


文图音视频全能覆盖。
智东西8月3日讯,minimax正式对外开源其最新一代通用视频生成模型——minimax h3。
MiniMax H3是一款面向全模态的通用生成系统,具备统一处理文本、图像、视频与音频等多源信息的能力,支持生成时长最长15秒、分辨率最高达2K,并原生集成立体声音频的高质量视频内容。
该模型于7月31日首次发布。当前,在Artificial Analysis发布的有声视频编辑能力评测榜单中,MiniMax H3以1130分的Elo评分高居榜首,力压Gemini Omni Flash、HappyHorse-1.0、Wan 2.7等国内外主流视频生成模型。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
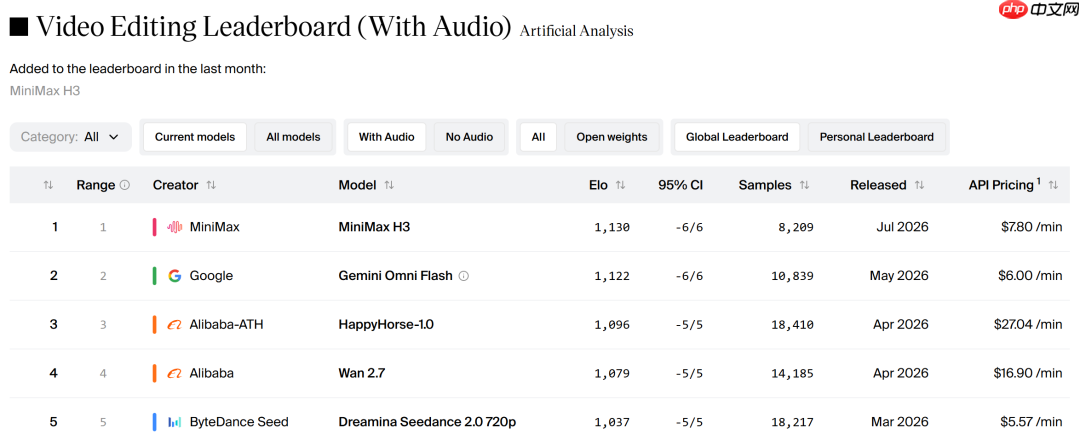
MiniMax H3位列有声视频编辑榜单榜首
H3整体架构由三大核心模块构成:H3-Context-IR、H3-Base 和 H3-Regenerate-2K。开发者可通过Hugging Face平台直接下载MiniMax H3系列模型;其中H3-Base已适配SGLang、vLLM、diffusers及ComfyUI等多种主流推理框架与可视化工作流,开箱即用。
伴随模型开源,华为昇腾、摩尔线程、沐曦、海光信息、昆仑芯、天数智芯、壁仞科技、AMD、Intel等国内外芯片厂商,以及Hugging Face、魔搭ModelScope、ComfyUI、RunningHub、fal等开发社区与云推理平台,还有vLLM-Omni、SGLang等前沿推理框架,共计16家生态伙伴已完成对MiniMax H3的全面适配与支持。
开源地址:
huggingface.co/MiniMaxAI/MiniMax-H3
模型体验入口:
H3-2K直出接口:
platform.minimaxi.com/docs/api-reference/video-generation-v2-create
H3-Context-IR接口:
platform.minimaxi.com/docs/api-reference/video-generation-v2-h3-context-ir
H3-Regenerate-2K接口:
platform.minimaxi.com/docs/api-reference/video-generation-v2-regeneration
MiniMax Hub: hub.minimaxi.com
海螺AI:hailuoai.com
今日,智东西团队对MiniMax H3进行了多轮实测。结果表明,该模型已能胜任风光航拍、商业广告等多种视频生成任务,在画面自然性、镜头调度逻辑与整体风格统一性方面表现稳健。但在画面真实感还原、复杂镜头衔接等方面仍有优化空间。
例如,我们输入指令生成一段15秒的自然风光航拍视频。成片中雪山、草原等景物细节较为逼真,光影过渡柔和,色彩还原度高,航拍运镜流畅,长镜头连贯性良好。但画面中出现的寺庙建筑仍带有较明显的人工合成痕迹。
随后,我们尝试让模型创作一段融合奶茶品牌与热门游戏IP的营销宣传短片。MiniMax H3输出了包含6个分镜的完整视频,叙事节奏清晰,视觉调性统一,广告氛围营造到位。不过在镜头编排上存在一处重复瑕疵:店员向顾客递送奶茶的动作被连续呈现两次。
01.单次输出最长15秒2K视频,画面与立体声同步生成
MiniMax H3 是一个真正意义上的全模态生成系统。在输出能力上,它支持生成4秒至15秒不等的视频内容,兼容21:9、16:9、4:3、1:1、3:4、9:16等多种宽高比,帧率固定为24FPS,并可同步生成采样率为32kHz的立体声音频。
默认输出分辨率为短边768像素,若需更高清效果,可通过H3-Regenerate-2K模块进一步升级至2K画质。模型目前已稳定支持中文、英语、日语、韩语、法语、德语等11种语言,对其他语种亦具备基础理解与生成能力。
H3提供FL2VA和Ref2VA两个版本,分别服务于首尾帧引导生成与全模态参考式生成。

用于在用户想通过浏览器自动化与 Google Gemini 或 ChatGPT 交互时。触发短语包括“ask Gemini”“ask ChatGPT”“ask GPT”“让...”。
H3-Base-FL2VA为“首尾帧模式”,最多接受两张图像输入:不提供图像时执行文生视频;仅提供首帧或尾帧图像时,分别生成对应起始或结束画面的视频;同时提供首尾两图,则依据两端视觉锚点智能补全中间动态过程。
H3-Base-Ref2VA为“全模态参考模式”,最多支持9张图像输入;视频片段最多上传3段,每段2–15秒,总时长不超过15秒;音频最多上传3段,同样限定单段2–15秒、总时长≤15秒,且必须与图像或视频联合输入,不可单独使用音频作为唯一提示源。图像、视频、音频三类文件合计上限为12个。
02.三大模块协同运作,2K画质依赖上下文再生成机制
H3系统由三个功能明确、分工协作的模块组成:负责多模态指令解析与上下文组织的H3-Context-IR、承担音视频实际生成任务的H3-Base,以及专责2K高清画面重建的H3-Regenerate-2K。
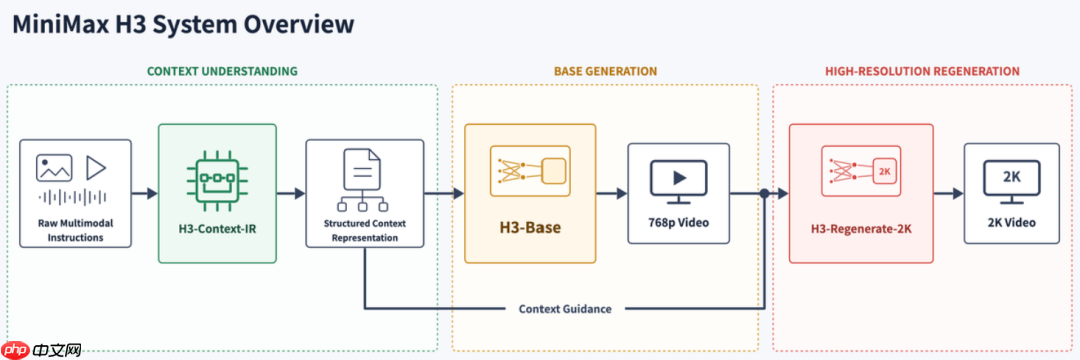
MiniMax H3系统概览(图源:MiniMax)
H3-Context-IR是一套托管式预处理与任务编排系统,能够精准识别文本、图像、音频及参考视频之间的语义关联,并厘清各类输入与目标输出之间的映射关系。其内部流程涵盖指令语义解析、跨模态对齐建模、时间序列建模以及多步逻辑推理等多个环节。
该模块采用多阶段流水线设计,整合多个专用托管模型与服务组件,目前尚未开源。MiniMax官方已开放配套API接口及详细提示词编写指南,供开发者构建自有预处理体系。
视频提示词撰写指引(英文):
huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/docs/VIDEO_PROMPT_WRITING_GUIDE_base_en.md
全参考模式提示词规范(英文):
huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md
H3-Base是音视频生成的核心引擎。文本经H3-Encoder编码,图像类输入则同步通过H3-Encoder与H3-VisualVAE进行双路径特征提取,音频信号由H3-AudioVAE完成编码。各类模态特征最终被整合为统一序列,送入H3-Omni-Transformer进行联合建模与生成。
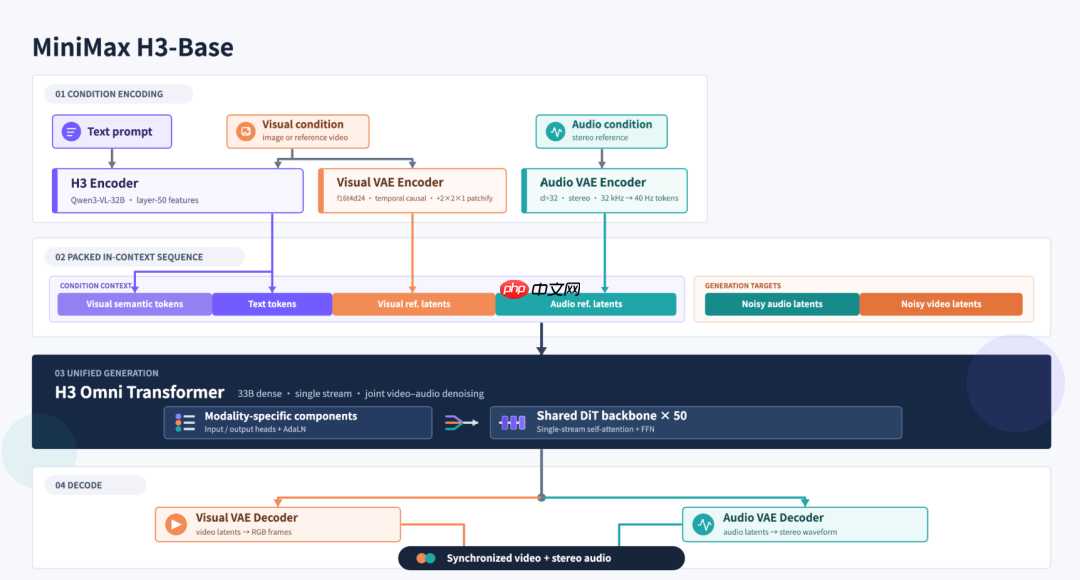
MiniMax H3-Base架构概览(图源:MiniMax)
对于2K输出,H3并未沿用传统超分方案,而是创新引入H3-Regenerate-2K模块——基于原始文本描述与多模态参考素材,对已生成的768p基础视频进行上下文驱动的重生成。这一策略能有效复用初始语义信息,显著提升小字号文字、纹理细节等低分辨率下易丢失内容的还原精度。该模块暂未开源,但开发者可通过官方API完整复现2K生成全流程。
03.本地部署支持768p音视频生成,2K全流程需调用云端API
MiniMax为开发者提供了两种验证路径:一是仅部署H3-Base实现本地化768p音视频生成;二是结合本地模型与云端API完成端到端2K工作流。
H3-Base以FL2VA与Ref2VA两个独立仓库形式发布,每个仓库均包含处理器、分词器、文本编码器、Omni Transformer、Visual VAE及Audio VAE等全套推理组件,支持SGLang、vLLM、diffusers与ComfyUI等多种部署方式,并兼容多GPU并行推理。
仅部署H3-Base时,可生成短边为768像素的音视频。其中FL2VA适用于文生音视频及首尾帧生成任务;Ref2VA则支持图像+视频+音频混合参考,实现角色一致性保持、动作迁移、口型同步、音色克隆等高级编辑能力。
完整的2K生成流程需三步协同:首先由H3-Context-IR解析并增强用户输入;其次由本地H3-Base生成768p基础音视频;最后调用H3-Regenerate-2K API,结合原始上下文完成高清重建。MiniMax已在Hugging Face模型页中公开文生音视频、首帧驱动、全模态参考等典型用例,含请求参数、示例代码与参考输出,便于快速上手。
04.结语:全模态视频生成迈入开放共建新阶段
从实测表现来看,MiniMax H3已在自然风光、商业广告等多样化场景中展现出较强的综合生成能力,在画面自然度、镜头逻辑性与风格统一性方面达到较高水准。
随着十余家芯片厂商、开发平台、云服务商与推理框架集体完成适配,本次开源不仅释放了模型本身的技术能力,更初步构建起涵盖模型获取、本地部署、应用开发与产业落地的完整生态闭环。全模态视频生成的竞争焦点,正加速从单一画面质量,转向声音生成质量、复杂指令理解深度与跨平台生态协同效率的全方位比拼。
本文来自微信公众号“智东西”(ID:zhidxcom),作者:杨京丽,编辑:李水青,36氪经授权发布。











