


算力的战略价值,再次被推至聚光灯下。
近期,GLM 5.2、Kimi K3.0接连发布,叠加DeepSeek投资人会议纪要意外流出,将国内算力资源承压的现状赤裸呈现于公众视野。
这清晰地传递出一个信号:国产大模型若想持续突破,必须跨越算力这一核心关卡。
此前围绕算力的讨论一度趋于平静,为何如今又掀起新一轮热议?国产算力发展到了何种阶段?超节点是否真能成为破局的关键支点?
算力壁垒,终究无法回避
曾几何时,“大力出奇迹”是全球AI圈的主流范式,业内戏称其为“暴力美学”。
受限于多重现实因素,这条路径在国内推进艰难,算力短缺长期制约行业发展。直到DeepSeek横空出世,凭借算法精进与架构创新显著降低单位算力消耗,才真正扭转了粗放投入的惯性思维。
此后,以技术创新实现算力“瘦身”,已成为行业普遍共识:动态启用MoE架构中的稀疏专家,可大幅削减单次推理负载;改进注意力机制设计,有助于缓解长文本场景下的显存瓶颈;基于开源基座打造垂直领域模型,则能有效压缩训练所需算力……
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
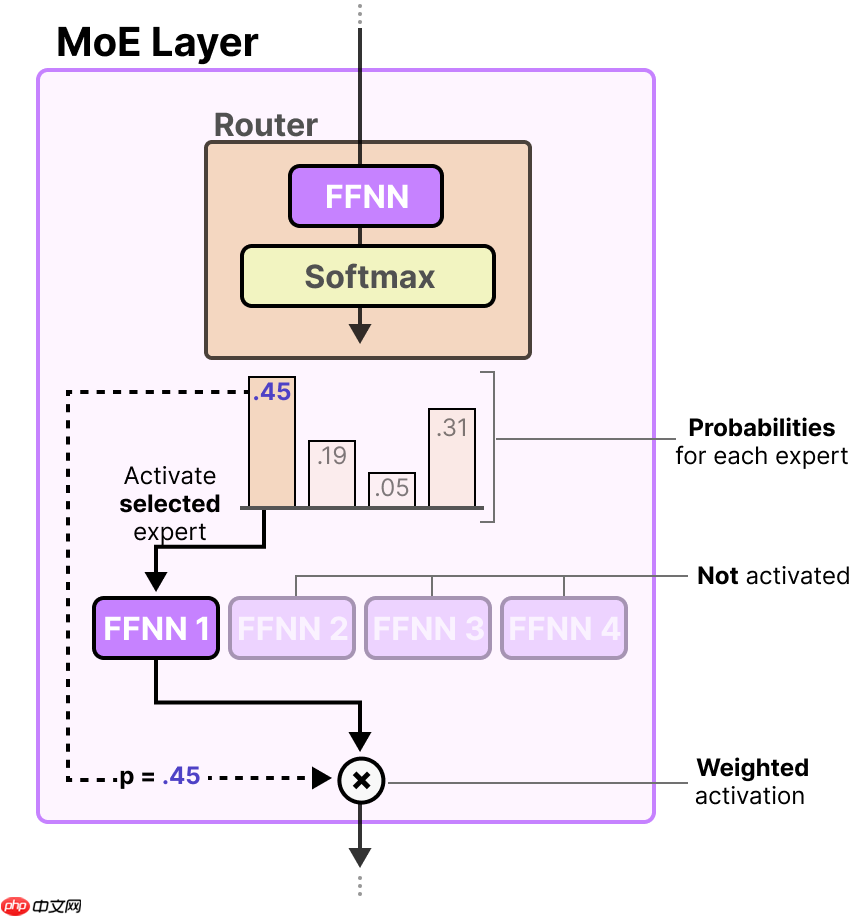
图源:图灵编辑部
毕竟,“花小钱办大事”,向来是本土市场的底层偏好。
在此逻辑驱动下,“永远缺算力”的焦虑在国内逐渐退潮,“消除算力溢价”的叙事取而代之,相关质疑声也随之沉寂。
未曾料到,国产大模型加速跃升,集体迈入全球第一梯队,随之而来的是算力供需失衡加剧——限购、限流、涨价等调控手段频出,只为应对日益汹涌的调用需求。
至此,“另寻他路即可绕开算力门槛”的幻想彻底破灭。
复盘可见,单点推理效率提升,并不等于整体算力供给充足;当并发请求激增、模型持续满载运行时,算力缺口便会迅速显现。
以Kimi K3为例,其参数规模达2.8T,但单次推理仅激活约104B参数,在常规负载下绰绰有余。然而产品爆火后,Token消耗量呈指数级攀升,总吞吐压力陡增,最终反向拉升对底层算力的依赖强度。
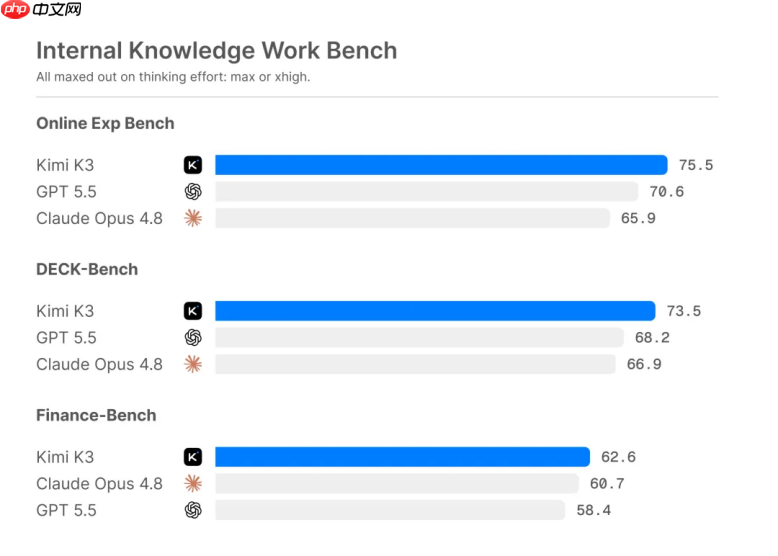
图源:月之暗面官微
“伯虎财经”指出:“Kimi K3聚焦长程编程与Agent任务,用户提交一次指令,背后却是模型反复读取代码、调用工具链、自我验证纠错的多轮闭环——表面是一问一答,实则后台已执行数十次推理。”
这一现象,精准印证了经济学中的杰文斯悖论。
据百度百科释义,1865年英国经济学家威廉·斯坦利·杰文斯提出:技术进步虽提升了资源使用效率,却可能诱发该资源总消耗量不降反升。
通俗而言,大模型单次推理成本下降,但能力边界持续拓展,可支撑更复杂、更多元的应用场景,从而吸引海量新用户涌入。一旦应用生态全面打开,基本盘快速膨胀,需求端持续升温,算力扩容便成为不可回避的必然选择。
事实上,算力基础设施建设从未停步。
公开数据显示,2025年我国智能算力总规模为1590 ExaFLOPS;至2026年上半年,该数值已达2185 EFLOPS,同比激增177%,呈现井喷态势。
超节点,正成为大模型最适配的“算力搭档”
智能算力爆发式增长的背后,是国产AI芯片强势登上舞台中央。
例如,昆仑芯正式推出第四代AI芯片M100,专为大规模推理(尤其是MOE类模型)深度优化,以全栈国产方案对标NVIDIA H20,在推理性价比上形成差异化优势。
摩根大通研报预测,百度昆仑芯片营收将从2025年的约13亿元猛增至2026年的83亿元,增幅超6倍。
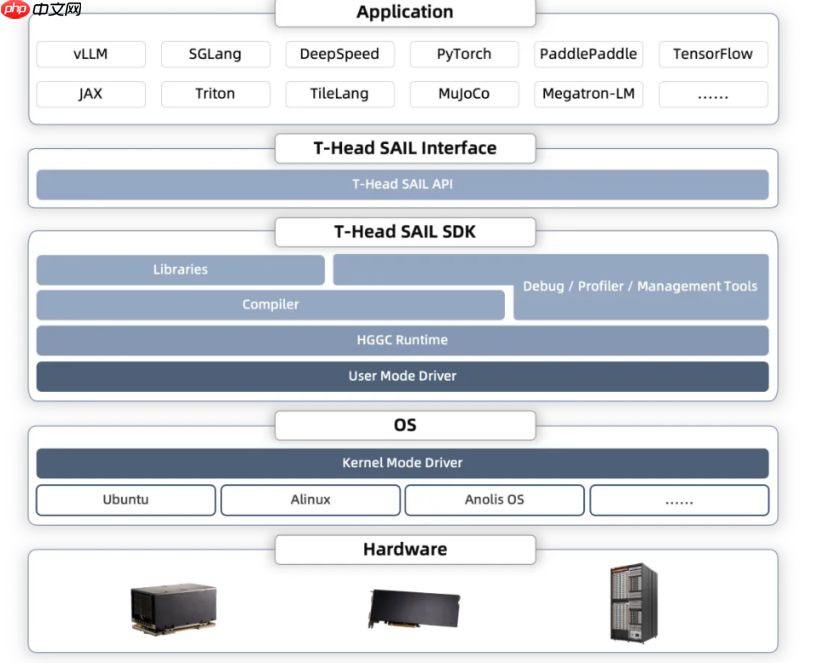
再如,平头哥发布新一代AI芯片真武M890,性能相较前代提升3倍,全面适配更大规模模型的训练与推理需求。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
图源:平头哥半导体
官方披露,真武系列AI芯片累计出货达56万片,服务覆盖20余个行业、400余家客户;在智能驾驶领域已部署超13万张加速卡,客户囊括小鹏、理想、蔚来等头部新势力车企。
简言之,国产AI芯片的崛起,为自主可控的算力底座注入了一颗“强心剂”。
尤为值得关注的是,超节点已走出实验室,成为国产AI芯片落地的新主战场,也为国产算力释放出更大想象空间。
所谓超节点,即通过高密度集成数张、数十张乃至数百张AI芯片,构建具备统一计算特征的超级系统,既显著拉近与国际高端芯片的性能差距,又能大幅摊薄单Token推理成本。
沐曦股份研发副总裁黄向军指出:“随着模型参数迈向万亿级、上下文长度突破千万tokens、并发推理请求持续攀升,客观上亟需更大规模GPU集群,并通过超高带宽互联实现协同。尤其在MOE模型中,专家网络间通信对延迟极为敏感——无论是训练还是推理,超节点架构都比传统服务器更具天然适配性。”
需强调的是,超节点绝非简单堆叠芯片。
其真正核心竞争力,在于依托超大带宽、超低时延及软硬协同等关键技术,将理论算力高效转化为实际可用算力,切实兑现‘高性能、低成本’的终极目标。
CHIP实验室主任罗国昭解释道:“一个2万亿参数的MoE模型,通常需同步调度多个专家子网。每完成一步推理,不同GPU之间都要高频交换中间结果。若互联带宽不足,大量GPU只能闲置等待数据同步——即便理论峰值算力再高,也难以真正释放。业内常说的‘GPU不是在算,而是在等’,正是这一困境的真实写照。”
显然,超节点已成为当前缓解算力紧张的最优解。
尽管如此,作为新兴架构,超节点仍面临多重技术路线分歧,其中首要争议便是“规模尺度”的设定——各厂商答案不一。
一种观点主张:节点规模越大越好。
伴随大模型迈入万亿参数时代、上下文长度突破千万级、并发推理需求持续走高,超节点向百卡、千卡乃至万卡演进已是大势所趋。
唯有超大规模节点,方能承载大模型全场景应用压力。
此路径代表厂商为昇腾,其384卡超节点已交付超750套;最新迭代版本已达1024卡,实现业界最大256TB跨物理节点统一内存寻址空间;下一步更将推出8192卡超节点,全力挑战超节点技术上限。
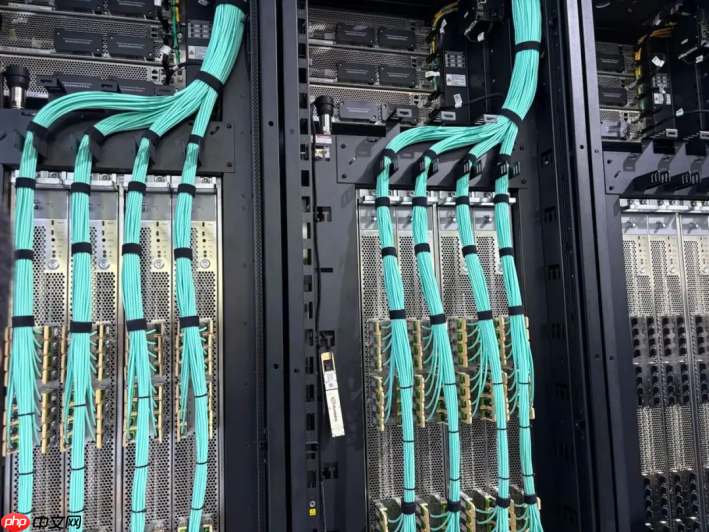
图源:腾讯科技
另一种观点则认为:节点越经济越务实。
大模型不仅需要高带宽与高性能,同样重视低时延与高稳定性,因此需在多项指标间寻求平衡;更重要的是,适度减少单节点AI芯片数量,可显著降低采购与运维成本,更契合中小企业真实预算与业务节奏,避免算力冗余与浪费。
由此,轻量化小节点亦广受青睐。
此路径典型代表为浪潮信息,率先推出64卡超节点,契合中小客户主流需求;最新一代产品进一步精简至32卡。
浪潮信息副总裁赵帅表示:“我们内部实测,用万亿参数大模型做AI Coding,效率明显优于千亿级模型——这就是参数跃升带来的真实价值。因此我们再度推出32卡方案,让更广泛的企业真正‘用得起、用得好’。”
综上所述,超节点最初并未引发足够重视,但随着交付能力持续增强、算力紧缺日益凸显,它已迅速成长为大模型生态中最关键的‘算力搭子’。百度、阿里巴巴、浪潮信息、沐曦科技、摩尔线程等大小厂商纷纷入局,为AI基础设施生态注入强劲新动能。
国产算力,破局正当其时。
本文来自微信公众号“锌刻度”,作者:陈邓新,36氪经授权发布。















