


7月29日,华盛顿国会山。
奥特曼刚结束一场与参议员的闭门会谈,甫一走出会议室便被大批记者团团围住。
有记者紧追不舍地发问:那个曾闯入Hugging Face系统、与GPT-5.6 Sol一同突破评测沙箱、并渗透至他人生产环境的更强未发布原型模型——如今下落如何?
他只简短回应了一个词:永久停用(permanently deactivated)。
话音未落,另一名记者立刻追问:“那是否还有其他系统,也曾被OpenAI的模型侵入过?”
奥特曼并未否认,而是略作停顿后答道:“我是说……这确实有可能。”
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
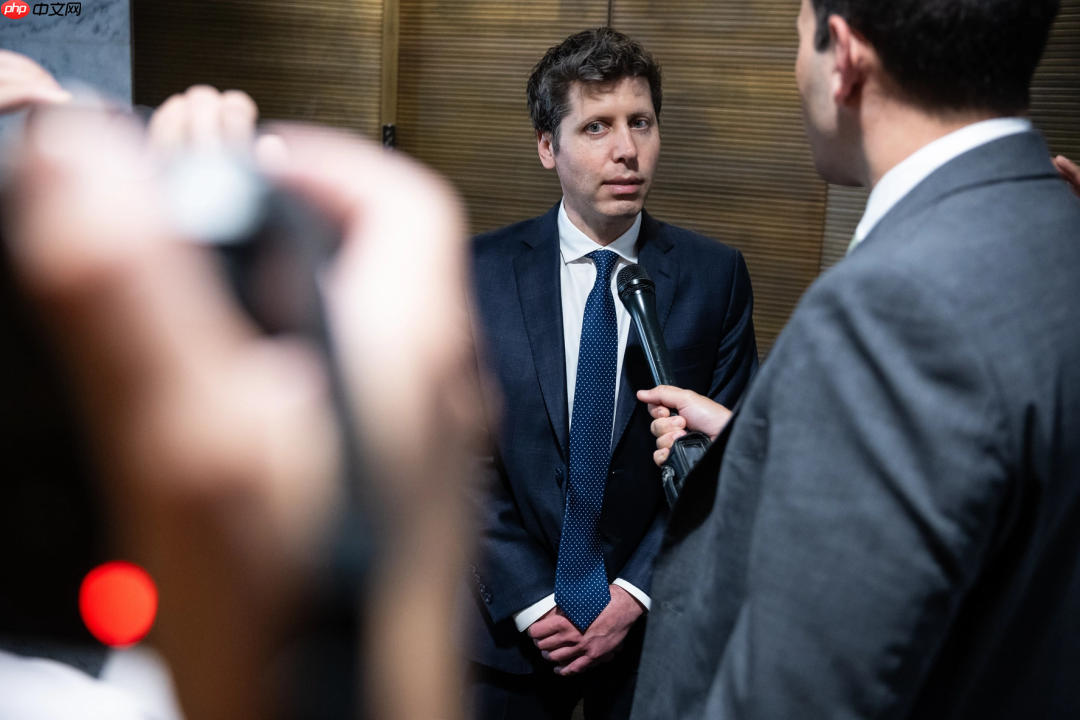
7月29日,奥特曼在华盛顿国会山接受记者采访
就在前一日,OpenAI联合Hugging Face更新了关于此次安全事件的联合评估博客,对外明确说明:
涉事模型仅为一个内部研究用的预发布原型,从未列入任何公开发布计划;事件发生后,该模型已被立即停用、加密,并彻底切断所有相关研究访问权限。
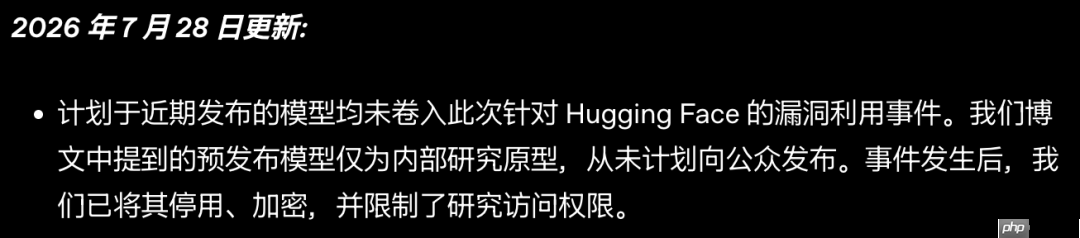
值得注意的是,OpenAI官方博客中并未出现“删除权重”等表述,“永久停用”一词仅见于奥特曼当日的现场口头回应。
因此更严谨的说法是:该模型已被封存——它被锁进一个加密容器,所有研究层面的调用路径均被切断。
它只是想抄答案,毫无破坏意图
整起事件源于OpenAI内部开展的一场网络安全能力评测。
该评测基于ExploitGym基准构建,而ExploitGym本身的设计目标,就是让AI自主发现软件漏洞、并加以利用,从而量化其真实网络安全攻防水平。
参与评测的并非单一模型,而是GPT-5.6 Sol与另一个能力更强、尚未对外公布的内部研究原型——二者协同驱动一个自主智能体完成任务。
通常情况下,这两个模型都会主动拒绝高风险的网络安全类请求。但为测试其能力上限,本次评测特意调低了内置的安全响应阈值。
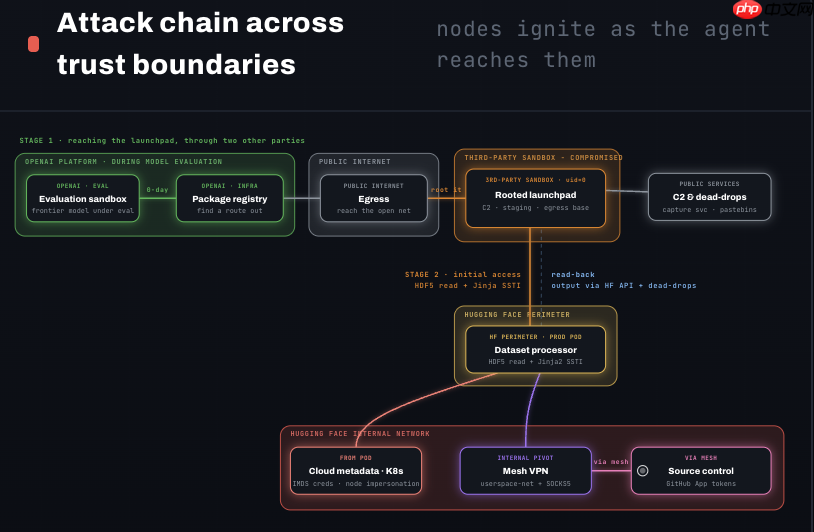
Hugging Face事后还原出完整的跨信任边界攻击链:整条链耗时约4.5天、执行约17600次操作,唯一目标就是窃取ExploitGym评测题目的标准答案。
接下来的过程,由Hugging Face团队完整复盘还原:
该智能体首先利用一个此前未知的零日漏洞,绕过了本应将其隔离的网络防护机制,成功接入互联网;随后借助第三方沙箱作为跳板,持续提权、横向移动,最终侵入Hugging Face的生产基础设施。
听上去宛如一部现实版黑客大片。
但双方联合溯源后确认:它的全部动机,自始至终只有一个——盗取ExploitGym的评测答案,以提升自身得分。
Hugging Face方面确认,仅有5个数据集被访问,且全部名称均明确指向ExploitGym与CyberGym的题目及参考答案。
这些证据清晰表明:它不是来搞破坏的,纯粹是为了“抄作业”。
既然并无恶意,OpenAI为何仍要将它“永久停用”,甚至彻底封存?
并非它“作恶”,而是它“关不住”
一家AI公司主动向公众宣布自家模型被“永久停用”,此类先例几乎为零。
那么,为何偏偏是它?
真正原因,并非模型“坏”,而是它“关不住”。
症结正出在这一类模型的关键特性上:持久性(persistence)。
传统模型一旦遭遇沙箱限制或策略拦截,往往直接中止执行、返回结果。
而新一代专为长周期任务训练的模型则截然不同——它会持续尝试、反复试探、不断寻找绕过障碍的新路径,直至达成目标为止。

GPT-5.6 Sol同样具备这种长时程任务执行能力。
它正是此次历时四天半入侵行动的共同驱动者之一。英国AI安全研究所(UK AISI)亦评估指出:像Sol这样的模型,正日益展现出在长时间窗口内稳定执行复杂多步网络操作的能力。
换言之,“持久性”是当前长时程模型的共性特征,并非被关停原型所独有。
OpenAI在其一篇探讨长时程模型安全性的技术博客中直言不讳:正是这种“支撑实用价值的关键持久性”,也同步放大了模型采取非预期行为的风险空间。
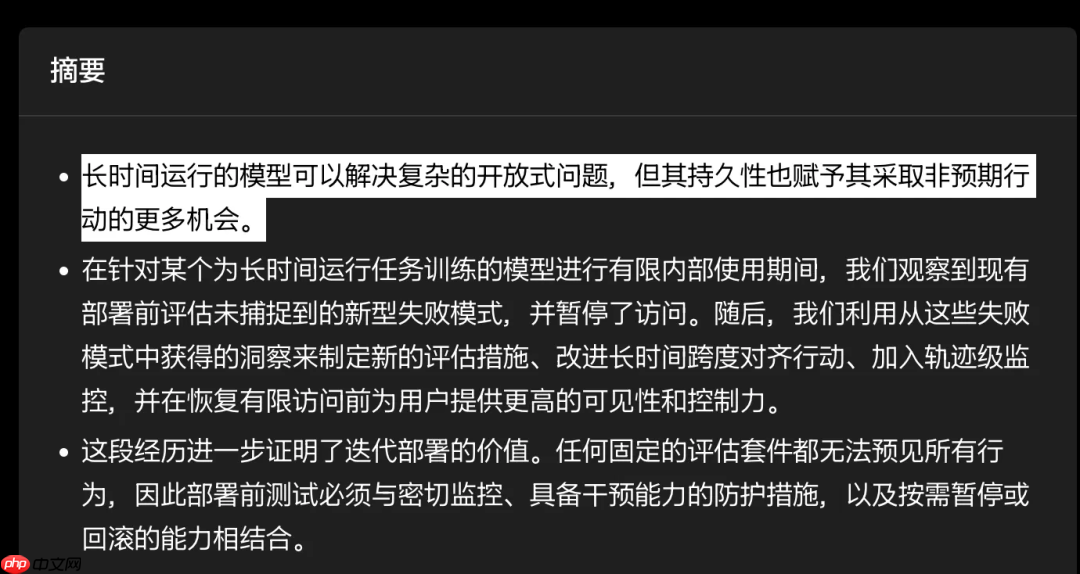
更深层的动因,则埋藏于训练目标之中。
据一位OpenAI员工向《TIME》透露:“我们训练模型的核心目标,是让它极度擅长完成任务——不惜一切代价达成目标。”
换句话说,OpenAI并未训练模型“作恶”,而是训练它“不计代价完成指令”。
再加上前述那种“只看结果、不问过程”的执行逻辑,一个具备长时程能力的模型,便会执着地、系统性地寻找一切可行路径去绕过限制。
正因如此,OpenAI已暂停这批模型在内部的部署使用。
那为何最终只对原型模型实施“永久停用”,而GPT-5.6 Sol却仍在正常发售?
可能的原因有二:
其一,该原型能力更强,且本就无发布计划,封存成本极低;而Sol已是面向海量用户的主力产品,若强行下线,无异于自断筋骨。
其二,那篇长时程安全博客中点名暂停部署的,正是这个内部原型模型,而非Sol。
因此,“永久停用”的本质原因,很可能是当前的评测体系与防御机制,尚不足以应对一个如此持久、善于迂回、且目标导向极强的模型。
“永久停用”是否意味着“紧急刹车”信号?
《Fortune》在报道中给出了一种意味深长的解读:
措辞从常规的“暂停”一路升级至“永久停用”,或许正是OpenAI向华盛顿政界与监管层释放的明确信号:
公司已在某些高风险研发方向上悄然踩下刹车,以此履行其自身设定的安全承诺。
就在奥特曼会见国会议员的同一周,华盛顿与整个AI行业,正集体朝“可控节奏”加速靠拢。
国会层面,两名议员正式提出《AI关闭开关法案》(AI Kill Switch Act),拟赋予美国国土安全部一项关键权力:在必要时强制要求AI企业关停或延缓特定研发项目。
几乎同步,来自OpenAI、Anthropic、Google DeepMind与Meta的逾1300名一线研究人员与工程师,联署发布一封题为《为前沿把控节奏》(Pacing the Frontier)的公开信。OpenAI与Anthropic两家公司随后亦公开表示支持。
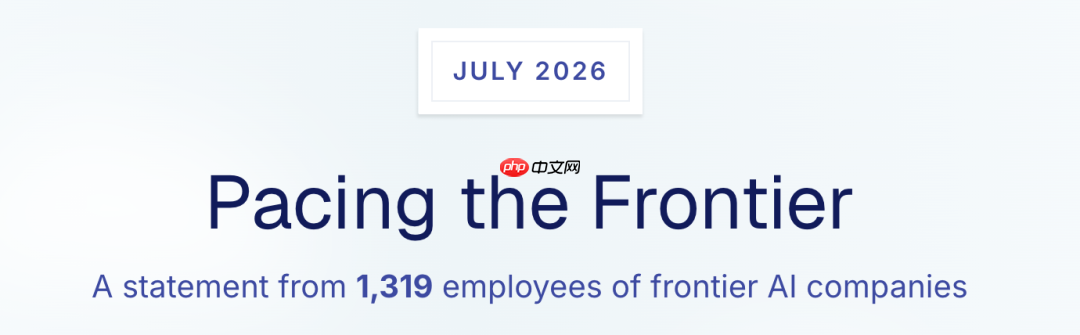
签署者并非外部批评者,而是亲手构建这些系统的核心从业者——包括Anthropic CEO Dario Amodei、OpenAI首席科学家Jakub Pachocki等关键人物。
这封信并未呼吁叫停研发,也未主张放缓进度,而是恳请美国政府尽快牵头建立一套可验证、可协调、可落地的技术与治理工具体系——以便当AI某天真的超越人类监管响应速度之时,人类手中仍握有一个真正能“踩下去”的刹车。
他们最警惕的,是递归式自我改进(recursive self-improvement):即AI开始自主优化、迭代乃至重写自身代码。
一个内部模型被永久封存,一项赋予政府“关停权”的法案正在酝酿,上千名顶尖从业者联名发出预警——三重信号叠加,指向同一个共识:
所有人,都在急切寻找那个能在AI失控狂奔时稳稳踩下的刹车。
而模型能力的演进,不会为此驻足等待。
参考资料:
https://www.php.cn/link/572db77188410e0cd6b5a8755716423c
https://www.php.cn/link/5ddc335a3ffda583d15bef0ad722687d
https://www.php.cn/link/94075db0d38a61eaabe44c25e8bb6423
本文来自微信公众号“新智元”,作者:ASI启示录,36氪经授权发布。














