7月31日,deepseek正式面向公众开放v4-flash正式版api的公开测试。本次更新最引人瞩目的核心亮点是——agent能力实现跨越式升级。
9项权威基准测试结果全面公布,多项关键指标显著超越此前发布的V4-Pro-Preview预览版本,再度刷新“代码智能体”的能力边界。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
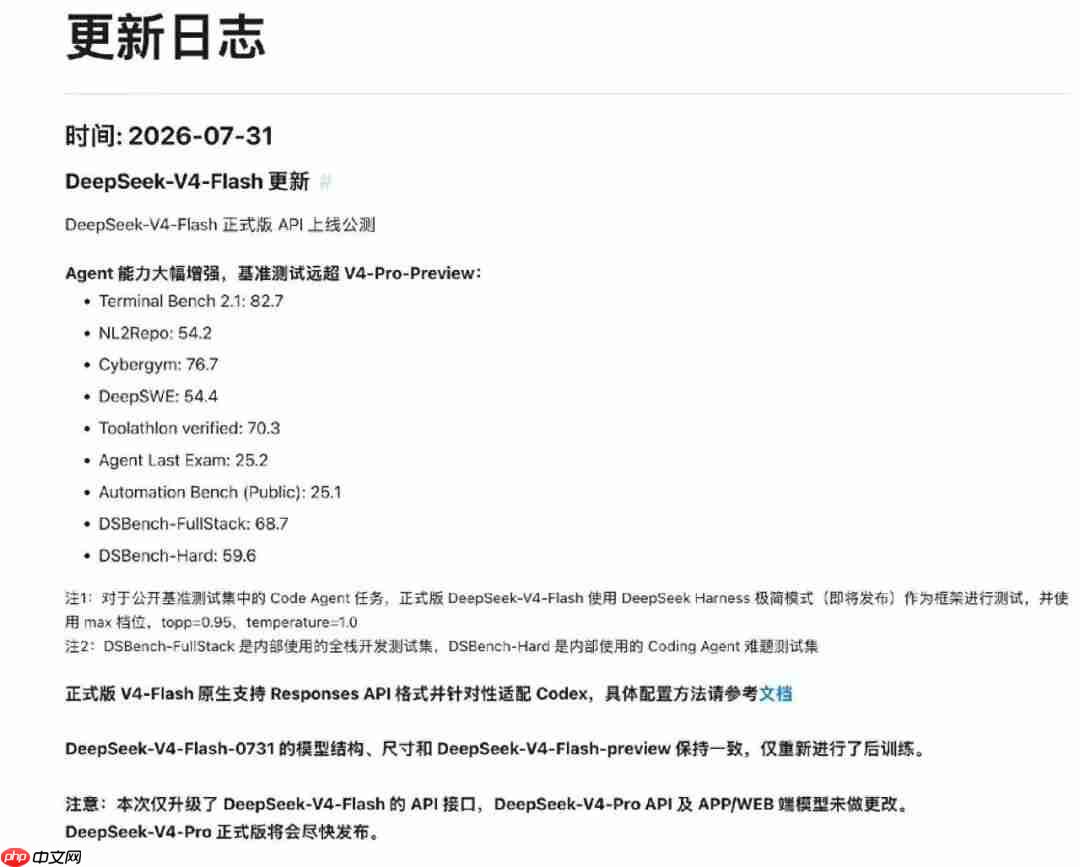
从Terminal Bench到DSBench-Hard,从网络安全攻防演练到全栈工程开发,DeepSeek-V4-Flash正式版展现出极为突出的“全能型Agent”潜力。
这代表什么?意味着AI已不止于“会写代码”,而是逐步具备工程师级的工作逻辑——启动终端、解析代码仓库、调用外部工具、独立执行端到端复杂任务。
9项基准测试实绩:用数据验证实力
此次,DeepSeek选择完全公开透明,一次性披露全部9项基准测试得分。覆盖范围涵盖终端交互、代码库理解、安全攻防、自动化测试等多个关键维度。
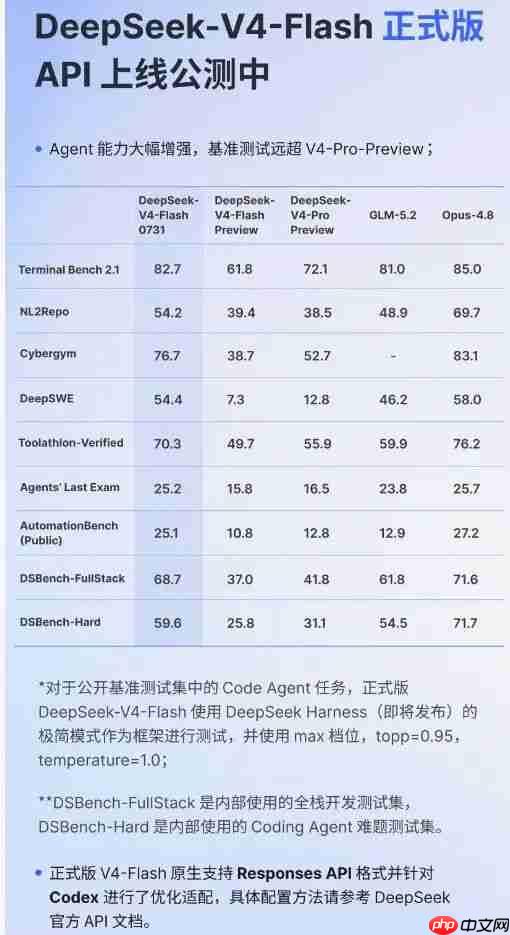
其中,Terminal Bench 2.1以82.7分高居榜首,表明模型在真实终端环境中的任务执行能力已趋于成熟——可准确解析复杂命令行语义、自动生成Shell脚本、定位并修复运行时错误,接近“AI运维工程师”的实战水平。
Cybergym获得76.7分,凸显其在网络安全对抗场景下的强大推理与响应能力。DSBench-FullStack(全栈开发专项测试)和DSBench-Hard(高难度Coding Agent挑战测试)分别斩获68.7分与59.6分,印证该模型不仅能完成单点函数编写,更能统筹从前端界面到后端服务的完整交付流程。
评测机制说明:公开、规范、可复现
DeepSeek同步公布了详尽的测试配置细节,体现出高度的专业性与可信度:
注1:针对公开Code Agent基准测试集,正式版DeepSeek-V4-Flash采用即将开源的DeepSeek Harness极简模式作为统一评测框架,并启用max推理档位,top_p=0.95,temperature=1.0。
注2:DSBench-FullStack为内部构建的全栈开发评估数据集;DSBench-Hard则为专用于检验Coding Agent极限能力的内部难题集。
尤为值得关注的是,DeepSeek Harness极简模式作为一款即将独立发布的标准化评测框架,首次随本次成绩同步亮相,折射出DeepSeek在构建规范化Agent评估生态上的战略意图——不仅致力于打造更强模型,更着力提供可信赖、可复现、可扩展的评测基础设施。
原生兼容Responses API,深度适配Codex生态
除性能跃升外,V4-Flash正式版在工程集成层面亦有重要演进——全面原生支持Responses API标准格式,并完成对Codex协议的针对性优化。
开发者可无缝将V4-Flash嵌入现有Codex工作流中,大幅降低迁移与适配成本。具体接入方式请参阅DeepSeek官方技术文档。

通过 Codex CLI 生成图片,支持尺寸控制和批量模式。依赖:codex (npm)。代理默认启用。用 generate.sh 生成单张,batch_generate.sh 批量生成游戏 UI 素材,gen_size.sh 指定尺寸。所有输出保存至 ~/.codex/generated_images/。
模型架构保持一致,后训练成为决胜关键
一个关键事实值得强调:DeepSeek-V4-Flash-0731的网络结构与参数规模与Preview版本完全相同,仅通过新一轮精细化后训练完成升级。
换言之,底座未变,“教育方式”升级了。这也清晰表明,在Agent能力构建这条新赛道上,后训练策略仍蕴藏着巨大优化空间。同一套基础架构,经由更科学的数据构造、更精准的指令微调与更严格的强化学习反馈,即可在多项Agent基准上实现质变突破——这对整个AI研发范式具有深远启示意义。
本次升级范围:仅限V4-Flash API接口
适用范围说明
已完成升级:DeepSeek-V4-Flash API服务
暂未升级:DeepSeek-V4-Pro API服务
暂未升级:APP客户端 / Web网页端所用模型
即将上线:DeepSeek-V4-Pro正式版(官宣将尽快发布)
需特别说明的是,本轮更新仅作用于DeepSeek-V4-Flash的API服务接口。若您当前使用的是V4-Pro系列API,或通过移动端App/Web页面访问DeepSeek服务,本次调整暂不影响您的使用体验。
至于备受期待的V4-Pro正式版,DeepSeek官方明确表示“将尽快发布”。鉴于Flash版已在Agent能力维度展现出如此强劲的领先优势,V4-Pro正式版的综合表现无疑更值得业界翘首以待。
行业洞察:我们是否已步入Agent时代?
从Terminal Bench到Cybergym,从DeepSWE到Toolathlon,这9个测试名称本身便勾勒出一条清晰演进路径:AI能力评估正加速从“生成一段代码”迈向“交付一项工程任务”。
DeepSeek-V4-Flash正式版在多项Agent专属基准中大幅领先V4-Pro-Preview,释放出明确信号——在后训练主导的新阶段,竞争焦点已悄然转移:不再比拼参数量级,而聚焦于Agent行为建模、工具调用链路、多步任务规划等深层能力的系统性打磨。
当AI可以稳定操作终端、深入理解百万行级代码库、参与红蓝对抗演练、自主完成跨技术栈的软件交付时,我们或许正站在一个全新纪元的门槛之上:AI不再是被动响应的编程助手,而是能主动思考、协同协作、持续交付的“AI工程师”。
而DeepSeek,已然在这条通往Agent时代的征途中率先起跑。
本文来自微信公众号“CSDN”,整理:梦依丹,36氪经授权发布。