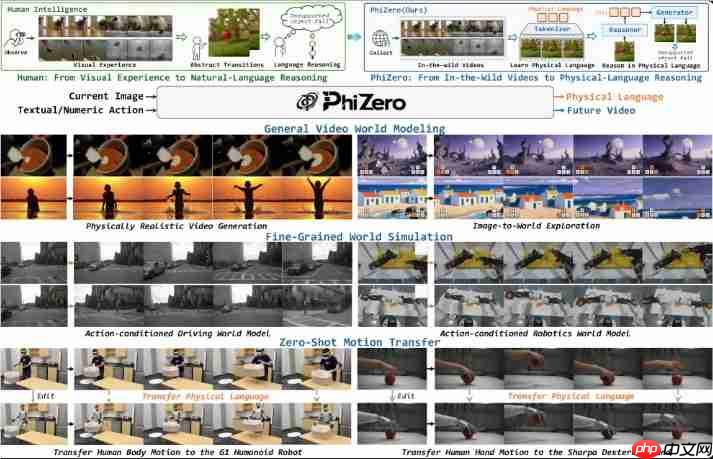
在当下的大模型发展浪潮中,视频生成模型常被视作通向具身智能的重要“虚拟试验场”。但目前主流方法普遍依赖像素空间的端到端直接建模,往往难以保证生成内容在物理规律层面的稳定性与时间连贯性。为突破这一行业瓶颈,研究团队近期正式发布全新一代物理世界建模框架
其核心突破在于构建了一种名为“物理语言”的离散化动态表征体系。该体系通过自监督范式,从大规模真实场景视频数据中自动挖掘状态演化模式,提炼出跨视觉经验共有的动力学先验。依托该表征,模型采用“推理先行、渲染后置”的两阶段范式:首先在物理语言空间内以自回归方式规划未来状态序列,再由专用扩散解码器将符号序列精准映射为高保真视频帧。该解耦设计不仅实现了动力学建模与视觉合成的模块化分离,更显著增强了输出结果在物理合理性上的鲁棒性。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
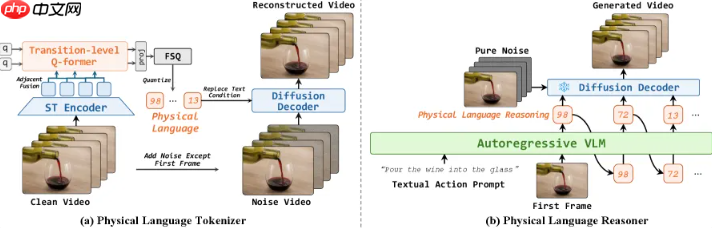
从工程实现角度看,整个系统由分词器与推理器两大支柱模块构成。其中,物理语言分词器采用转移感知型Q-Former结构捕捉帧间状态跃迁,并借助有限标量量化策略生成紧凑、语义明确的离散token;扩散解码器则以初始图像和物理语言token为联合输入,逐帧还原丰富细腻的视觉细节。而物理语言推理器则基于预训练视觉语言模型进行参数初始化,结合首帧视觉信息与文本描述的动作指令,高效生成符合物理约束的未来状态符号序列。
在多项权威评测中,
随着具身智能与自主机器人技术加速走向实际部署,