


值此成立周年之际,fish audio 正式发布其目前性能最强的生产级语音大模型——s2.1pro。区别于面向固定脚本旁白的传统文本转语音(tts)系统,该模型专为实时交互式语音场景深度优化,现已全面接入 fish audio api,并同步开放具备开发与测试友好额度的免费试用版本。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
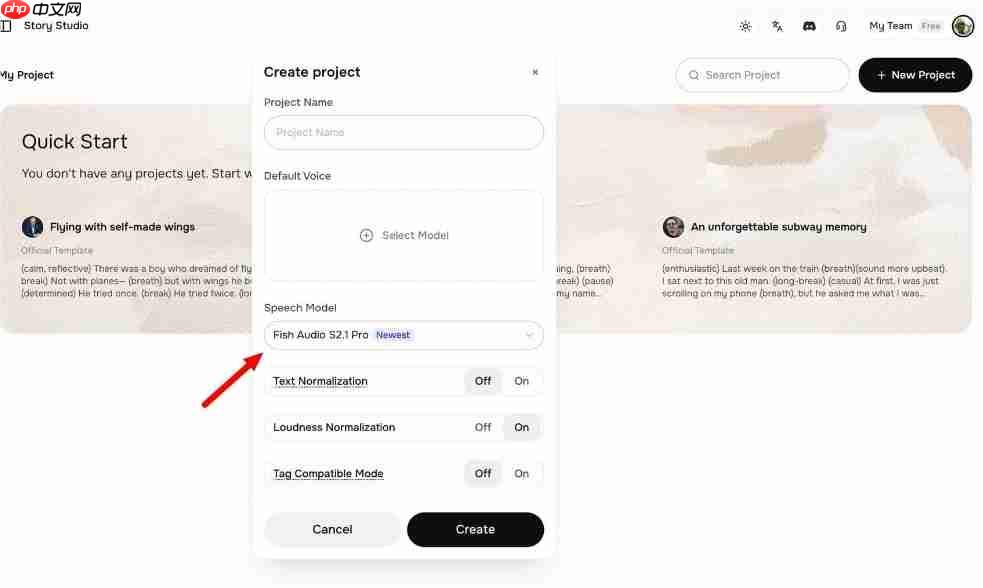
在技术指标上,S2.1Pro 实现约90毫秒的首帧音频延迟,确保对话过程中轮替自然、响应流畅;模型支持83种语言,且全部基于统一语音建模架构。在情感与语态调控方面,它摆脱了传统预设情绪选项的束缚,支持在输入文本中直接嵌入自由格式括号指令(如“(耳语)”“(紧张地笑)”),实现细粒度、上下文感知的语音表现控制。
同时,S2.1Pro 原生兼容多角色对话生成,仅需10–30秒的语音样本,即可完成高质量声纹克隆,在零微调条件下精准还原目标说话人的语调特征与个性化表达风格。
S2.1Pro 的问世,标志着语音人工智能正加速从静态脚本合成迈向超低延迟、高保真、强交互的实时对话范式,为全球范围内的智能语音应用落地,提供了更易集成、更高稳定性的算力底座与技术支撑。













