





7月24日,蚂蚁百灵正式推出全新一代原生混合推理模型——ling-3.0-flash。该模型总参数量为124b,单次前向计算仅激活5.1b参数。在显著缩减模型体积与降低硬件资源消耗的前提下,ling-3.0-flash 在基础逻辑推理、指令精准执行以及长文本理解与生成等关键能力维度上,不仅追平,更在多项指标上超越参数规模达其2至3倍的业界主流大模型,真正实现了更高水平的“智能效率比”与工程落地价值。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
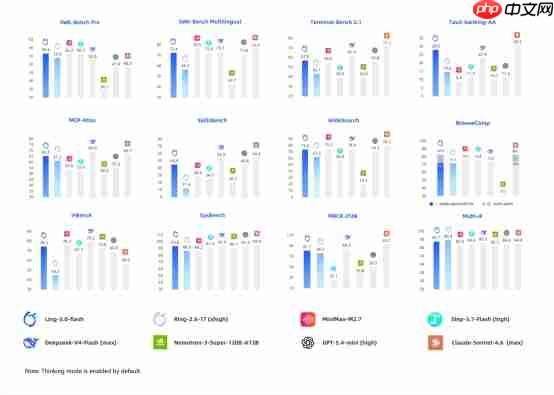
本次升级聚焦AI Agent的实际部署需求,Ling-3.0-Flash 针对真实业务场景完成深度优化。模型构建并融合了超10000个高保真交互式训练环境,并重点强化了复杂任务中的自我修正能力与跨步骤长程规划机制。无论面对编程实现、多阶段任务分解,还是跨平台、多来源信息的深度整合分析,Ling-3.0-Flash 均展现出更强的端到端自主交付能力,有效缓解了传统大模型在处理大型任务时易出现的逻辑偏移、上下文断裂等问题。
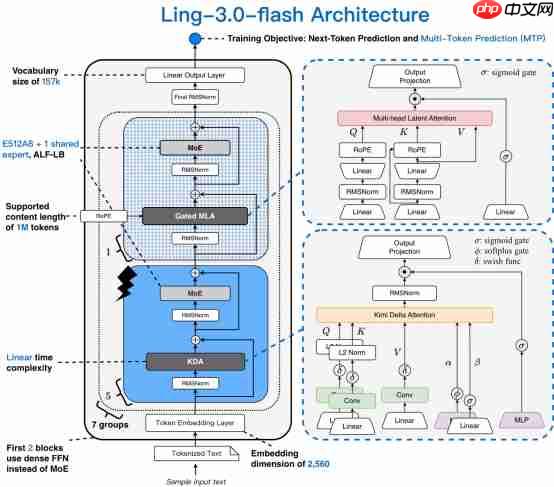
据悉,达成“轻量化、强智能”这一目标的核心,在于模型底层计算范式的系统性重构。Ling-3.0-Flash 摒弃了单纯扩大参数规模的技术路径,自预训练起即采用创新的混合注意力架构:以5:1的比例交替堆叠KDA线性注意力层与MLA(Multi-Layer Attention)层,在保障长距离依赖建模能力的同时,大幅提升上下文处理效率与整体模型效能之间的协同性。
与此同时,Ling-3.0-Flash 将上一代Lightning Attention全面升级为KDA(Kimi Delta Attention),在Delta Rule的状态更新机制中嵌入细粒度对角门控结构,使模型在解析长文档、大规模代码库等复杂输入时,能够更稳定、更聚焦地捕获并保留核心语义线索。此外,模型进一步压缩了稀疏专家激活比例——每个Token所激活的专家模块数量由上一代的1/32降至1/64,从而在维持高性能的同时,显著提升单位算力下的推理杠杆效应。
为支撑AI Agent高效、可靠运行,百灵同步构建了与Ling-3.0-Flash深度适配的工程底座与协作体系。在响应性能方面,通过引入集群级分级缓存机制,大幅减少长对话与多轮交互过程中的重复计算开销,将长输入场景下的首Token延迟降低60%–80%以上;在系统稳定性层面,新一代多智能体协同架构支持不同Agent按角色分工、交叉验证、动态协同,显著削弱单一模型决策偏差带来的风险,为高并发线上服务及规模化产业应用提供了坚实支撑。













