


7月19日傍晚,在kimi k3登顶榜单两天后,阿里云正式推出qwen3.8-max预览版。这款模型尚属“未完成态”,官方明确表示将以每日迭代的方式持续进化——旗舰级大模型首次以“预览版+日更机制”形式面世。
相较Kimi K3创下新高的定价策略,Qwen3.8预览版祭出极具冲击力的“骨折价”:日间调用仅需原价一折,夜间更降至0.2折。部分用户反馈称,模型能力确有肉眼可见的进步,几乎每天都在变强;但也有用户直言:“付了费就得干活,不是来体验不稳定版本的。”
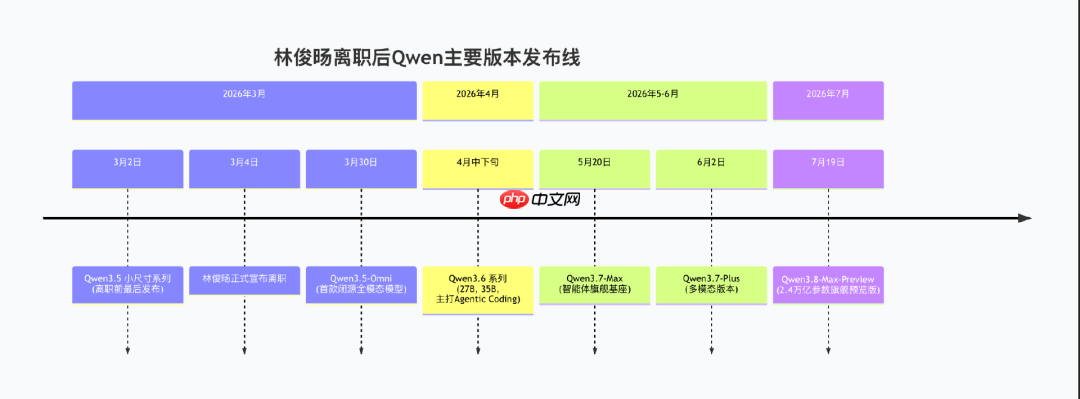
Qwen3系列由林俊旸在职期间主导研发,而Qwen3.5则是他在离任前发布的最终版本。然而该版本与去年9月曾跻身LMArena大模型盲测前三的Qwen3-Max Preview相比,表现明显下滑。据《晚点LatePost》披露,阿里内部高层对该款于除夕夜仓促上线的模型评价不高,甚至私下称之为“半成品”。
林俊旸始终坚持开源路线,后因阿里组织架构调整而离职,此事一度引发业界广泛热议。Qwen系列能否保持长期进化能力,也成为外界持续关注的焦点。
参数层面,Qwen3.8-Max总参数量达2.4万亿,采用MoE稀疏架构,是阿里首个突破万亿参数门槛的原生多模态模型。官方数据显示,其在代码生成与协同办公两大核心场景中,较前代Qwen3.7-Max分别提升22.8%和44.4%。
在林俊旸离开140天后,Qwen3.8-Max将再度回归开源路径。阿里或许已意识到:当模型能力尚未达到闭源头部水平时,开源反而成为维系品牌声誉与构建健康生态的最优解。
01
日更模式下的Qwen3.8-Max预览版,并未完全兑现宣传承诺
据阿里云官方介绍,相较上一代旗舰模型Qwen3.7-Max,新版在代码工程、专业办公等关键能力维度实现显著跃升,在全栈开发、数据分析、Office办公流程等复杂长程任务中展现出全球领先的综合表现,并仍在快速演进中。
为检验其在真实办公场景中的实用性,我们向模型提交了一份题为《具身智能发展报告(2025年)》的文档,并提出三个具体问题:报告中归纳了几类主流具身智能技术实现路径?请逐一简述其核心特征;依据报告所列数据,分析2025年该领域投融资呈现哪些趋势性特点;基于报告内容,设计3至5个适合用于PPT展示的数据可视化方案。
Qwen3.8-Max预览版对每个问题均进行了约10秒的响应准备,输出逻辑清晰、结构完整,并辅以表格形式呈现答案。
在X平台,一位ID为“Lonely”的独立开发者利用Qwen3.8-Max预览版生成了一段令人惊艳的视频。首次尝试时,他仅给出模糊需求,结果产出效果平庸、缺乏创意;第二次则详细列出功能模块、交互逻辑、图像规范及页面层级结构。
最终生成的昆虫视觉效果堪比BBC纪录片实拍画面,高度写实;对比初版卡通风格,整体专业感大幅提升。每个昆虫还配有学习卡片,支持用户自主检测掌握程度。
实际体验发现,即便面对超长提示词与多页面协同构建任务,Qwen3.8-Max预览版仍能保持流畅响应,全程耗时仅17分钟;而Kimi K3完成同类任务需52分钟,等待时间大幅压缩。在长周期任务执行方面,Qwen3.8-Max预览版表现出色,基本实现了所有指定交互细节与模块拆解要求。
为进一步测试其前端生成能力,我们要求模型创建一个关于宇宙星系的交互式HTML页面,具体需求如下:
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
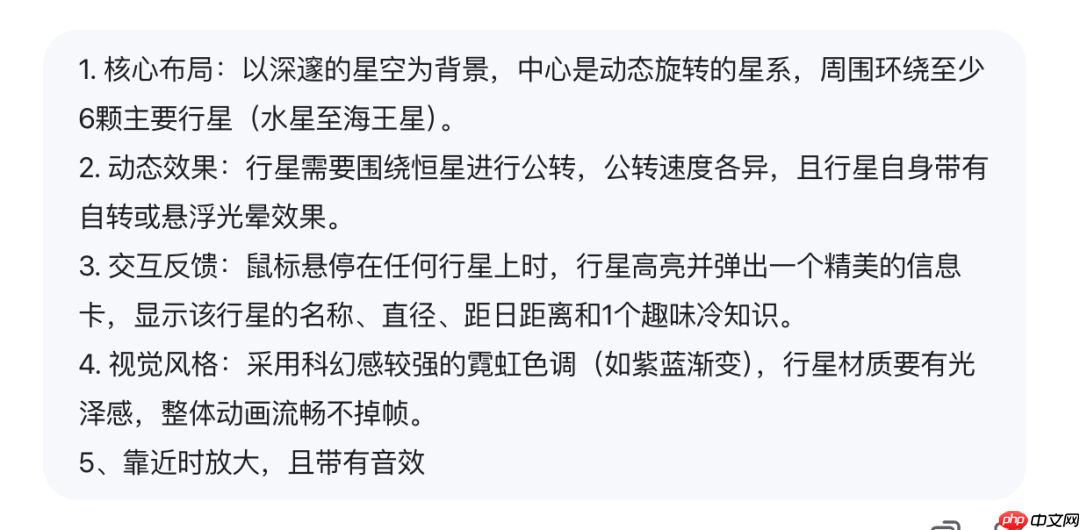
从表面看,模型基本满足了全部基础要求,但存在明显常识错误:太阳系主要行星被设定为以相同速度绕日公转,且彼此相对位置恒定不变。事实上,各行星公转速率差异巨大,轨道位置亦时刻动态变化。
社交平台上的用户反馈显示,Qwen3.8-Max预览版在创意编程、3D交互、复杂叙事等非标任务上仍显乏力。有人将其称为“裸奔式发布”——有参数无扎实训练数据,有口号缺实证支撑。阿里此次选择以“日更机制+限时一折”组合策略,本质是借大规模真实用户反馈加速打磨闭环。这一打法与此前HappyHorse视频生成模型的发布逻辑高度一致:先引爆热度,再逐步补足能力,用市场关注度为产品迭代争取宝贵窗口期。
不过,参考腾讯混元Hy3正式版相较Preview版的跃升幅度,Qwen3.8正式版的实力仍有可观提升空间。
一位独立游戏开发者向Tech星球透露了他的使用经历:日常依托Godot引擎与Blender开展原型开发,工作流对响应速度与迭代效率极为敏感。实际体验表明,Qwen3.8-Max预览版在复杂逻辑生成与长上下文任务处理方面尚未迈入第一梯队,但在短周期、高频次交互场景下,单位时间产出效率甚至略胜GPT-5.6 Sol,性价比优势突出。然而一旦任务周期拉长至30分钟级别的连续推理或大规模代码生成,其后劲明显不足,稳定性尚待加强。
就具体能力维度而言,该开发者评估认为:当前在游戏功能代码生成与基于MCP协议的工具调用控制方面,GPT-5.6 Sol稳居第一梯队;Kimi K3与GLM 5.2可划入第二梯队;Qwen3.8-Max预览版则需再降一档,其核心竞争力更多体现在上下文窗口容量、单次调用成本及响应延迟三者的综合平衡上,适用于高频辅助开发场景,但在复杂任务精度与深度上仍存明显短板。
比起模型本身,“限时一折”的价格策略反而更具吸引力——不少开发者在主力模型之外,主动接入Qwen系列。一位开发者坦言,自己是在Kimi K3月度额度耗尽后临时切换至Qwen,才得知最新版本上线。“大模型迭代太快了,遇到新版本都想试试。”但他也补充道:“如果Qwen3.8恢复原价,大概率不会继续使用。”
02
阿里为何急于推出Qwen3.8-Max?
林俊旸离职后,阿里大模型团队进入一段微妙的过渡期。
在其离开一周内,阿里于3月30日至4月2日期间密集发布三款新模型:Qwen3.5-Omni、Wan2.7-Image与Qwen3.6-Plus。值得注意的是,这三款模型全部闭源,开发者无法下载权重进行本地部署,仅能通过阿里云百炼平台调用API——此举与Qwen系列过去两年坚持的“开源优先”传统形成鲜明反差。
但从全球大模型发布节奏来看,2025年底至2026年中这半年间,Claude、Gemini、Llama均已热火朝天地推进“4系”乃至“4.5系”旗舰版本。而Qwen在此期间主版本号仍停留在Qwen3,更新节奏显得相对保守。

过去一年,阿里并未推出类似Qwen4这样的跨代基座模型,主要聚焦于推理性能微调与长文本能力优化,部分能力被整合进中小规模版本中。相比之下,Claude一年内完成了从3.5到4.0再到4.5的三级跳;Gemini同期发布1.5改进版、2.0、2.5三代,平均3–4个月即推一大版本;Llama不到一年时间便从3.3跨越至4.1,且始终坚守开源路线,迭代速度极快。
阿里2026财年(截至2026年3月31日)年报及第四季度财报,首次交出一份可量化的AI商业化成绩单。本季度,阿里AI相关产品在阿里云外部收入中占比首次突破30%,达89.71亿元,年化经常性收入(ARR)已超358亿元——其中绝大部分来源于百炼MaaS平台的API服务收入,即企业客户为调用模型支付的Token费用。
阿里集团CEO吴泳铭在财报电话会上多次强调:AI已越过前期投入阶段,正式迈入商业化回报周期。面向未来五年,阿里AI基建投入资金将远超此前承诺的三年3800亿元。
巨额投入带来的成本压力,倒逼阿里必须在AI商业化路径上找到确定性的规模化收入来源,而不能仅停留于技术声量与开源口碑层面。当“卖Token”成为最大营收支柱时,一个结构性矛盾随之浮现:开源旗舰模型本质上是在付费API墙之外,为自己打造了一个免费替代方案——每一个能本地部署Qwen的开发者,天然减少了调用付费API的需求。换言之,阿里越拥抱开源生态,就越可能在商业化道路上亲手培育竞争对手。
因此,阿里大模型闭源边界持续扩大,“中小模型开源、大模型闭源”的双轨模式逐步成型。
但市场并未给阿里的战略调整留下充足缓冲期。进入7月,全球AI大模型迎来密集发布窗口,头部玩家几乎同步亮出新牌。
7月16日,月之暗面发布拥有2.8万亿参数的Kimi K3,主打长程编程与复杂推理,多项代码评测指标反超GPT-5.6 Sol;DeepSeek V4也在同期加速落地,以极致性价比切入赛道,竞争维度正从单一能力转向性能、成本与迭代效率的多维博弈。
海外同样于7月掀起“AI大乱斗”。7月9日,OpenAI正式推出GPT-5.6系列(含旗舰版Sol),编码能力再创新高;xAI发布Grok 4.5,主打高性价比;Meta上线Muse Spark 1.1,强化工具调用能力;谷歌Gemini 3.5 Pro亦计划于7月中旬上线。海外厂商普遍聚焦编码能力、工具调用与AI Agent构建。
当大模型迭代节奏迈入“按周竞速”阶段,在Kimi K3与DeepSeek V4双重压力下,阿里不得不提前抢跑。Kimi K3发布仅三天后,阿里迅速推出Qwen3.8-Max预览版,被外界视为抢占关键窗口期的重要动作,也是在全球AI竞赛中维持声量的必要举措。
为争分夺秒,Qwen3.8-Max的发布形式也透出多重“赶工”痕迹:后训练尚未彻底收尾;对外宣传中,英文版直接宣称“仅次于Fable 5”,中文版却谨慎加上“可能”二字;同时明确承诺回归开源,这也是阿里旗舰级大模型时隔多轮闭源后,再次踏上开源之路。
02
林俊旸离开之后,Qwen3.8-Max为何再度回归开源?
林俊旸离职后,通义实验室历经三次重大组织架构调整。
3月,阿里成立ATH事业群(Alibaba Token Hub),将AI业务统一纳入该框架,由吴泳铭亲自挂帅,确立“Token生产、分发与变现”的核心战略;4月设立集团技术委员会,吴泳铭任组长、周靖人出任首席AI架构师,并将通义实验室升级为通义大模型事业部;6月进一步将通义大模型事业部与未来生活实验室合并,组建Token Foundry事业部,仍由吴泳铭直接领导,周靖人则转任集团首席科学家,牵头AI未来研究院。
三次调整的核心主线,是推动AI业务从“技术驱动型”组织形态,全面转向“商业化驱动型”的Token工厂模式。
此前,林俊旸离职的直接诱因之一,正是通义实验室计划将Qwen团队由“垂直整合”体系拆分为预训练、后训练、文本、多模态等水平分工单元。拆分后,后训练板块交由来自Google DeepMind的周浩负责,而预训练与多模态板块负责人至今未公开披露。
林俊旸的离开,在很大程度上映射出阿里在“开源信仰”与“商业回报”之间的阶段性拉锯。如今Qwen3.8-Max预览版上线并重申开源承诺,标志着阿里在战略层面的一次重要回调。
从时间节点观察,全球范围内开源与闭源力量的对比正发生根本性转变。Mozilla发布的《开源AI现状报告》指出,开源模型与闭源模型的平均性能差距已缩至3.3%,在编码、指令遵循等核心能力上基本持平。
与此同时,OpenRouter数据显示,开源模型处理的Token占比从2026年1月的34%飙升至6月的65%,全球API调用月消耗量Top5已全部被开源模型包揽。中国大模型更在全球调用量中连续十一周领跑,开源模型下载量占比已达41%。
在开源生态建设方面,7月22日,“阿里云开发者”公众号正式更名为“千问AI平台”,标志着阿里正式将Qwen开发者生态,从过去依赖林俊旸个人影响力维系的松散互动,迁移至由阿里官方统一运营、提供标准化服务的成熟平台上。
总体来看,Qwen3.8-Max正式版上线后选择回归开源,并非简单复刻旧路,而是阿里在经历内部路线分歧后,重新审视自身优势,并在激烈市场竞争中作出的理性商业抉择。
本文来自微信公众号“Tech星球”(ID:tech618),作者:林京 王琳,36氪经授权发布。













