


谷歌 deepmind 团队最近发布了全新架构的 genception 模型,旨在将原本用于视频生成的 ai 反向重构为具备深层现实理解能力的视觉分析系统。与传统方法中深度估计、图像分割等任务需分别建模不同,genception 通过统一模型架构,可同步高精度执行深度估计、语义分割、3d 姿态估计等五类关键视觉解析任务。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
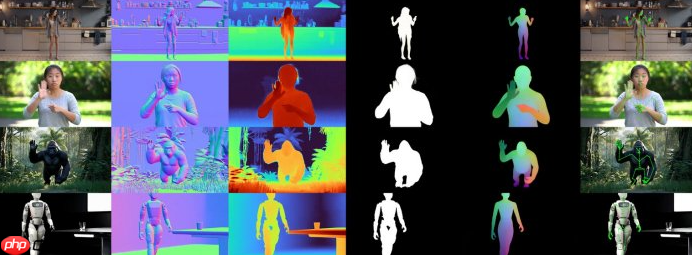
该模型依托阿里巴巴开源的通义万相 Wan2.1 架构进行训练,支持单次前向推理完成全部预测,显著优化了端到端响应效率。用户仅需输入简明文本指令,即可快速获得深度图、像素级分割掩码以及相机运动轨迹等多维度结构化输出。
仅用单人合成数据训练,泛化能力惊艳——发丝级细节完整保留
值得注意的是,GenCeption 的训练数据完全来源于约 7500 段由 Blender 渲染生成的单人合成视频。尽管数据规模有限且场景高度简化,模型却展现出卓越的跨域泛化性能:不仅能稳健解析真实场景中的多人动态视频,还可无缝适配动物及机器人等非人类主体。
实测结果显示,轻量版模型处理 81 帧视频耗时约 6 秒,而参数量达 140 亿的大规模版本也仅需约 10 秒。更令人惊讶的是,其重建细节甚至优于原始合成素材——猫科动物的胡须走向、人类个体的单根发丝轮廓均被精准刻画与保留。














