


在最新的一次深度分析中,wojciech gryc 对 anthropic 推出的 fable 5 模型与中国两家新兴ai公司——月之暗面(moonshot)与阿里巴巴——所发布的最新模型展开了横向对比。其中,moonshot 于 7 月 16 日正式发布 kimi k3,阿里巴巴则紧随其后,在 7 月 19 日推出 qwen 3.8。这两款中国新模型在多项关键性能指标上已逼近 fable 5,并且均宣布将全面开源模型权重。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
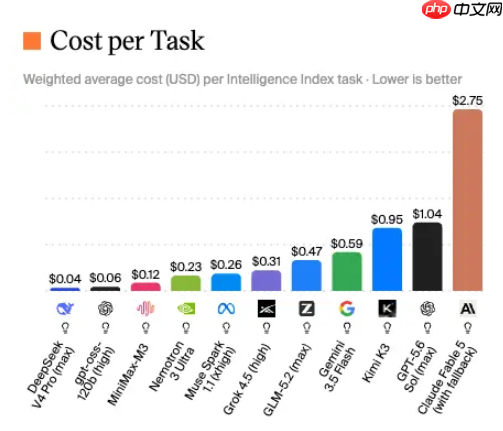
Gryc 指出,尽管训练尖端大语言模型的核心投入集中于顶尖研究人员薪资与大规模算力消耗,但真正决定长期可持续性的成本环节实为推理阶段。每一次用户通过 API 发起请求,系统都需要持续调用 GPU 并消耗可观电力。因此,能否高效覆盖推理开销,已成为左右企业商业模式成败的关键变量。
他进一步将当前主流 AI 企业划分为三大基础设施阵营:第一类依赖外部云服务或租赁数据中心并承担电费支出,代表企业包括 Anthropic、Moonshot 以及智谱(GLM 5.2);第二类则自主建设超大规模数据中心,如 Meta 与阿里巴巴;第三类更为罕见,不仅自建数据中心,还具备独立能源供给能力(例如自建光伏或核能供电设施),SpaceX 即属此类。Gryc 特别强调,掌握底层基础设施的企业即便在模型参数量或基准测试分数上略逊一筹,亦可通过对外提供算力服务实现稳定盈利。

基于阿里云百炼 Qwen3.5-Omni 的全模态技能,支持文本、图片、音频、视频理解与文本/语音输出。适用于图片分析、音频转写理解、视频理解、跨模态问答及语音回复生成。
值得注意的是,Gryc 的测算显示,Fable 5 在单任务推理成本方面约为 OpenAI 同级别模型及主流开源模型的三倍。在当前高度内卷的市场环境下,如此显著的成本差异是否仍能获得终端用户的持续买单,正构成 Anthropic 面临的一大现实挑战。他判断,现有公开基准测试体系已接近瓶颈,用户实际体验中的模型能力差异远小于其背后运行成本的差距,这或将加速 Anthropic 被市场边缘化的进程。
相较之下,OpenAI 凭借覆盖全场景的产品矩阵(从 API 到消费级应用)以及深度整合的全球数据中心网络,在商业化落地层面展现出更扎实的护城河。Gryc 预测,本轮由模型性能与基础设施双轮驱动的竞争浪潮将持续升温,未来或将有更多非传统科技巨头背景的实验室,在技术迭代速度与商业转化效率上逐步超越老牌美国科技企业。













