


在生成式ai步入应用深水区的2026年,全球创业生态正迎来重构。传统商业用人头堆砌产值的逻辑正在失效,取而代之的是一种全新的技术原生法则。
Y Combinator掌门人Garry Tan在最新演讲中指出,AI时代的真正红利绝非微调模型权重,而在于工作流的重新梳理。通过将传统组织架构中的员工、流程与绩效全面编码为“技能手册”与“企业大脑”,硅谷已经诞生了首批以15人、40人的极精简团队撬动数千万至上亿美元ARR(年经常性收入)的AI原生企业,彻底颠覆了工业革命以来传统商业的人均产值法则。
“如果你依然把AI当成代码自动补全、把提示词当成一次性工具,你将在下一阶段的竞速中被对手吃掉饭碗。”Garry Tan说。
一些核心观点:
决定AI时代生产力上限的并非大模型本身的权重,真正的效能杠杆(最高达400倍的提升)在于如何重新串联和编织工作流。
传统用人头堆砌产值的商业逻辑正在失效,未来的组织形态将全面代码化,一个“技能手册”就是一名虚拟员工,而“解析器表”就是组织架构图。
在系统开发中必须严格厘清计算的边界,将直觉判断等非确定性任务交给大模型的“潜空间”,将具体规则和代码交给“确定性空间”,避免两者错位。
必须打破人类“工作记忆”的局限,通过上下文工程构建“企业大脑”,将企业历史知识沉淀为可精准检索、产生价值复利的“知识图书馆”。
永远不要做一次性的工作,一旦对AI的输出结果满意,就必须将其“技能化”(skillify)为可复用的流程,否则企业每天都会陷入“技术失忆”。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
我们整理了此次演讲的重点内容,以下是原文实录:
1.400倍效能跨越:从个人生产力到重构工作流
Garry Tan:大家下午好,过得怎么样?准备好迎接这场变革了吗?刚刚Theo问了一个非常关键的问题:我们现在应该构建什么?作为一名创始人、投资者,同时也是一家正在向AI原生转型的20年历史机构的负责人,我想从投资人的角度来回答这个问题。让一家拥有20年历史的机构走向AI原生,是一件奇特而美妙的事情。接下来我会用大约20分钟的时间,聊聊YC正在尝试做的事情。我们希望培育出这样的企业:一个人就能完成过去需要两个人、甚至一千个人才能完成的工作。我这并不是在打比方,从实际操作来看,今年在座的各位就能实现这一点。大约一小时后,你们中的一些人就会走向创业沙场,我希望你们能带着对当今技术可能性的清晰认知走进去,因为现在的技术潜力远比人们想象的要巨大得多。
Garry Tan:让我先从一个数字开始。虽然我曾因为这个观点在网上饱受抨击,但我今天还是要当着大家的面再讲一遍。这个房间是全世界最适合对这个观点进行压力测试的地方,我宁愿和你们一起亲自验证它。2013年我还是YC的合伙人时,主要负责构建YC内部的社交网络。当时我虽然也做投资,但基本相当于全职工程师。那时候我每天大概只能写出14行真正有用的逻辑代码,这还是剔除了所有注释和空行之后的数据。如果你们看当年的文献资料就会发现这很正常,有些人写15行,有些人写50行,绝对不像现在台下很多年轻人在开发中动辄日产上千行代码。这15行就是我当时全力以赴的日均中位数产出。而今年,我全职管理YC。同样是我这个人,投入的时间差不多,甚至因为下午五点要接孩子,工作时间还要少得多,但我重新计算了自己的产出,发现效率提升了大约400倍。
Garry Tan:在质疑者跳出来质疑这个数字之前,让我先自己来拆解它。如果你不相信纯代码量的统计,没关系。你可以用最严苛的冗长惩罚机制来扣除水分,假设AI Agent写出的都是臃肿的代码,假设其中一半都是脚手架框架,甚至假设我是在自我标榜,但在底线上它依然带来了8倍的提升,中位数也达到了80倍。无论你如何拆解审视,这个数字都极其庞大。这里有一个核心关键,如果可以的话,我恨不得把它烙在每个人的眼睑内侧:这并不是模型本身的差距。带来2倍效能的人和带来100倍效能的人,使用的是完全相同的Claude模型、相同的权重、相同的上下文窗口和相同的API。因此,杠杆的立足点并不在于模型的权重,而在于你如何串联工作流。
Garry Tan:而且这不仅仅发生在我的身上。在YC,我们经常能看到这种情况。在2025冬季班中,有四分之一的企业,其代码库有95%都是由AI生成的,而那已经是去年的事情了。这一期项目已经成为YC历史上增长最快、利润最高的班次。在YC的历史上,已经有94家公司通过一笔种子轮融资成功实现了收入破亿美元。所以,我想我们非常清楚自己在谈论什么。虽然我无法向你证明AI生成的代码直接导致了这种增长,但我可以告诉你的是,我们资助的那些增长最快的创始人,并没有把AI仅仅当作代码自动补全工具,而是将其视为一种生产力劳动力。那些重新编织了工作流程的公司,才是真正实现弯道超车的企业。
2.劳动力的新物理法则:把组织机构编码为“技能手册”
Garry Tan:那么,重新构建工作流程究竟意味着什么?这是本次演讲的核心,也是我最希望你们借鉴的地方。我们在构建AI Agent过程中学到的所有东西,都可以一一映射到现实的组织架构中。
Garry Tan:在AI时代,一个技能手册就等同于一名员工。它具备一种能力,负责一项工作,并且被清晰地记录下来,以至于任何主体都可以执行它。而解析器表则是组织架构图,当一项任务进来时,解析器会决定由谁来处理以及分发到哪里。归档规则就是内部业务流程,用来判断解析器是否在正常工作、是否合规。触发评估则是绩效考核。过去需要雇佣上千人才能运转的组织,其中的每一个职能模块,现在其实就是一些代码文件以及其他类型的描述文件。我们一直都在构建组织,过去只是缺乏一个管理层,而现在我们拥有了它。当你坐在电脑前协同Claude、Coder、Codex进行开发时,你不仅仅是在写软件,你其实是在招聘、培训和管理一支由代码和文档组成的劳动力队伍。
Garry Tan:我看到有无数的公司正在践行这一点。比如2024夏季班中有一个AI应用构建工具项目Emergence,他们从正式上线到实现九位数的年度经常性收入(ARR)仅仅用了八个月的时间。当他们的年度经常性收入突破1500万美元时,团队仅仅只有15个人。截至2024冬季,他们的零售额已达6000万美元,团队规模约为40人。这种极高的人均产值在以前是不可想象的,无论是在软件行业、石油行业还是铁路行业,都从未出现过。他们并不是什么行业异类,只是首批原生构建与新物理法则之上的公司。那么这类公司究竟是如何运转的?他们不会为销售、支持、运营和财务等部门雇佣成百上千的名员工。我在YC内部看到的AI原生公司,会将所有这些职能编码为技能和书面流程。他们雇佣工程师的唯一目的,就是维护这些技能,去解决AI Agent目前还无法完成的工作。这就是真正的AI原生公司,它绝对不是一个思想实验。如果你配置好了对应的技能手册,它甚至能帮你去完成报税。
Garry Tan:现在请大家想象一下YC的创业营现场,其实和这里的感觉很像。400家公司或400位创始人坐在长桌前,我可以想象你们每人每天拿着一台笔记本电脑忙碌的场景。你们现在一天干的活,相当于过去一个人一整年的工作量。这不再是遥远的未来,而是当下行业触手可及的基准线。如果你不这样做,你的竞争对手就会这样做,他们会非常优雅地抢走你的饭碗,甚至还会客气地对你道谢。这也是大多数工程技术栈容易忽略的延伸点:这不仅仅影响工程师。在YC进行数字转型的过程中,我们的媒体人员、活动员工以及财务团队都在参与。那些生平从未打开过终端的员工,现在都在构建自己的技能手册和定时任务。我们的一位财务同事刚刚利用我们内部的开源系统和企业大脑,将大约100个复杂的Excel工作簿整合到了一个她自己构建的应用中。她不是程序员,但她现在成了管理AI Agent的经理,事实上YC的每个人现在都是这样。
Garry Tan:这就是为什么YC可以用极少的人手来维持如此庞大的运转规模,这个团队规模在任何其他同等体量的公司看来,都小到可以忽略不计。这并不是因为我们工作更拼命,而是因为我们拥有一种完全不同的组织形态。这才是制胜的核心所在。这不仅仅是效能提升400倍的工程师,而是一家运营效率高出400倍的公司。

3.工程双元性:厘清潜空间与确定性空间的计算边界
Garry Tan:如果你只能记住这里面的一件事,那就是在开发过程中,你必须非常非常小心地厘清计算究竟发生在哪里。计算几乎总是发生在两个不同的空间。我们遇到的所有AI工程缺陷和问题,通常是因为本应在其中一个空间运行的内容,错误地出现在了另一个空间。第一个空间我称之为潜空间(Latent Space),也就是实际的大语言模型本身。你会用它来做什么?答案是审美、直觉判断、理解人类说出某些模糊话语时的真正意图等非确定性调用,这些计算存在于模型中,你通过描述文件来引导它。而确定性空间(deterministic space)则是工程师们非常熟悉的领域,比如你的代码Agent会去自动编写TypeScript,或者如果你在使用Elixir,它们会去编写Erlang代码。确定性空间就是计算发生的第二个地方。
Garry Tan:举个例子,这也是我们在即将到来的创业学院中面临的真实痛点。我们有6000名学员,而我们正准备尝试的一项实验是,能否让800人同时就座,并实现完美的聚类?也就是说,坐在你左边和右边的人,恰好是你在创业学院最应该结识的完美人选。要做到这一点,我们必须将确定性空间与潜空间结合起来。这种计算以及具体的数据存储——比如每个人在这800个座位的多维阵列中到底身处何处——绝对不能塞进上下文窗口里。大语言模型必须需要处理感性的部分,也就是安排人员就座。这与人类去执行这项任务时的逻辑完全一致。如果是人类面对这个任务,可能需要把800页的资料打印出来,铺在一个大房间里,然后琢磨这个人该放哪儿。但现在,所有这些工作都可以在电脑里完成。原本需要耗时一个月的工作,现在可能只需要价值几百美元的Token,在10分钟内就能搞定。我认为这非常了不起,哪怕在半年前,这也是根本无法实现的。
4.企业大脑的定义:突破7位数字限制的“图书馆与管理员”
Garry Tan:这就引出了工作记忆的概念,这也是我个人最喜欢用来理解它的方式。我们人类的大脑一次只能处理大约7件事,也就是著名的7±2法则。这是认知心理学领域最著名的论文之一,也是为什么本地电话号码通常是7位数,以及为什么你总会忘掉购物清单上的第8个物品。这基本上就是人类个体的全部工作记忆。人类历史上建立的每一个机构、每一份检查清单、每一张组织架构图、每一个文件柜,本质上都是为了弥补这一限制而发明的假肢。这背后的逻辑仔细想想其实挺疯狂的。但是,一个AI Agent可以容纳100万个Token,这大约相当于1000页的内容。我最近试着向我10岁的孩子解释什么是企业大脑,我说AI Agent可以在脑子里同时翻开三本《哈利·波特》,它能在几秒钟内找出任何细节,并对这三本书的内容进行综合分析。这确实太神奇了。三本《哈利·波特》对标人类的7位数字,这非常震撼。这算不算是通用人工智能?也许还不算,但它已经展现出了截然不同的运行和治理机制。然而,地球上几乎所有的公司,目前依然在用针对7位数大脑设计的传统组织架构来运转。
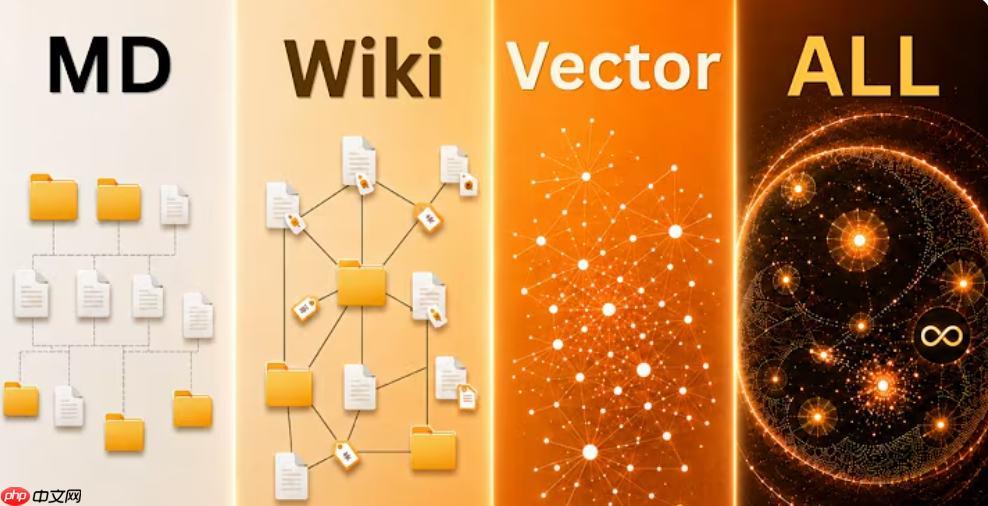
Garry Tan:但这也向我们透露了一个事实:三本书虽然很多,但其实也很少。你们的公司可不止三本书,你们的公司是一座图书馆。每一封邮件、每一次会议、每一项决策及其推导过程、每一次客户对话、每一次复盘报告都包含其中。决定你的Agent究竟是天才还是只有七秒钟记忆的金鱼,关键在于谁来决定桌上应该翻开哪三本书。这就是上下文工程(context engineering)。而这正是所谓的企业大脑(Company Brain):它既是图书馆,也是图书管理员。现在你们中有些人可能会想,这不就是检索增强生成吗?你们说得对,检索确实是最底层的基石,就像Postgres的底层只是B-trees一样。但真正困难的是围绕它的一切:最初有哪些内容被沉淀进了维基,这些内容又是如何被丰富和链接的,哪些内容被提升到了热记忆区,哪些又被归档为冷数据参考,以及当两条事实发生冲突时由谁来裁决。检索本身并不难,难的是如何让自己成为一个真正值得去检索的产品。
Garry Tan:我一直在公开构建我自己的系统,名为G-Brain。它能与任何开发框架配合,但它最契合的是Open Claw和Hermes Agent。它实际上就是面向Agent的Postgres,是一个专门的检索层,其职责就是针对任何给定的任务,计算出应该把哪三本书塞进Agent的大脑里。我的个人系统最初只有几个房间的书籍量,现在它已经发展成了一个仓库,拥有大约22万页的内容。这些内容主要是由我的Agent根据我的电子邮件、会议记录、长达20年的笔记以及我的亲身经历自动撰写的。这就是重点,它成为了我的第二大脑。当有创始人因为危机给我发邮件时,甚至在我还没看完邮件之前,我的Agent就已经调出了之前与该创始人的所有对话记录、另外三家遇到过同样困境的投资组合公司,以及当时真正帮他们渡过难关的有效方案。当我的Agent执行任何任务时,它都是站在我已经掌握的知识库基础上去做的。这就是助手与同事之间的本质区别。
5.拒绝一次性工作:将成功经验“技能化”以实现价值复利
Garry Tan:让我来对自己的观点进行一下压力测试,因为你们迟早也会质疑这一点。企业大脑确实存在失效模式。一个无人维护的大脑最终会变成一个搜索功能强大的垃圾场,检索系统会充满自信地为你提供一个陈旧过时的事实。一个糟糕的技能手册,则会把一个错误的业务流程永远固化下来,这非常糟糕。因此,最核心的基石不是内存(memory)本身,而是内存加上精细管理(hygiene),以及确保每一条事实都有迹可循(provenance),在新旧信息碰撞时进行冲突检查(contradiction),并且需要一个由人类和Agent共同组成的图书管理员来负责修剪冗余信息(pruning)。如果你把大脑当作生产基础设施来对待,它的价值就会不断复利叠加;如果你把它当成垃圾倾倒场,你最终得到的只会是一个极度自信却错得无可挽回的Agent,而且没人能追踪它是怎么出错的。
Garry Tan:在我看来,有一种习惯能让我们的企业大脑以及我个人的AI实现价值的复利——这是我的招牌动作,也是我对每一家YC创业公司和YC内部所有人强调过的话——那就是永远不要做一次性的工作。你可以打开Open Claw或你的开发工具去做一些工作,但当你对结果比较满意时——虽然一开始它可能干得并不完美,就像一个不太熟练的实习生,但好在你可以直接对它说“嘿,我不喜欢这个,修改一下”,我相信在座的各位都在做这样的事情——但不要止步于此。在任务结束时,你实际上需要将它技能化(skillify)。我在社交平台上发过一篇关于这方面的博文,你们可以去搜索“skillify it”获取那个技能手册,然后把它加载到你们自己的开发环境中。它就会把你刚刚完成的动作转化为一个可以重复使用的技能。因为如果你不得不重复交代同一件事两次,那就意味着你的管理失败了。
Garry Tan:所以,如果你们只能记住一件事,那就是当你们使用AI Agent并对输出结果感到满意时,顺手将它技能化,这会带来极大的改变。通过这种方式捕捉学习成果的组织,每天都会变得更聪明。而没有做到这一点的组织,无论底层的模型有多优秀,每天早晨醒来时都处于失忆状态。模型的质量是可以花钱租赁的,但如果你构建了自己的企业大脑,你就真正拥有了核心资产。
6.点燃新时代的软件富足:去构建真正的AI原生公司
Garry Tan:现在正面回答Theo的问题:我们现在应该构建什么?去构建AI原生公司,而不是仅仅使用AI的公司。从第一天起,公司的形态就应该像我刚才描述的那样:一个精简的团队、所有职能都沉淀为技能手册、创始人依然深度参与代码开发、拥有自己的图书馆、拥有企业大脑和个人AI。如果你们愿意,可以使用G-Brain,它是开源且免费的,但你们也不是非用它不可,市面上有很多非常优秀的选择。这个图书馆从第一周开始就会不断产生复利,你整个组织的运营效率也将被拉升到400倍左右。如果你想寻找一片尚未被开发的处女地,也就是如果我今年25岁、坐在台下你们的位置上会选择去构建的东西,那就是地球上的每一家公司马上都需要一个大脑。这是一个让你永远不需要重新询问已知知识的记忆层,是一个真正懂你的个人AI。我们正在以MIT开源协议公开构建G-Brain,我没打算通过这个项目来赚钱,因为我认为这个底层架构应该像Linux一样保持开源。但这个赛道本身——包括企业大脑、个人上下文、负责挑选那三本书的图书管理员——全都是大有可为的广阔天地。我希望有人能在这个领域构建出一门定义行业伟大的公司。如果是这样,我非常乐意在YC为你们提供资金支持。
Garry Tan:最后,让我说句老实话,虽然这可能会削弱我刚才这番推销的力度:你们其实不需要我的工具就能开始。Open Claw固然是性能强悍的法拉利,我也会一直推荐它,但Codex同样是一辆非常优秀的本田,它完全能帮你搞定其中90%的工作。
Garry Tan:虽然它不会带来让你惊掉下巴的极致体验,但绝对能帮你达成目标。用什么工具并不重要,核心在于理念,而不是我个人的开源代码仓库。关键在于去思考计算发生在什么空间,将技能手册视为你的员工,建立图书管理员机制,并且永远不要做一次性的工作。这些理念在任何技术栈中都是通用的。
Garry Tan:最后,让我来总结一下。现在世界上有很多人对未来岗位的去留感到极度恐慌,我完全理解这种恐惧。但我想坦率地告诉大家,这其实是想象力的匮乏,而在座的各位就是这个问题的答案。你们将会把刚才我所描述的这套架构带进你们的初创企业。你们会成倍地放大自己的效能,你们公司的每一个人也都会成倍地释放潜力,你们将要去构建的那些企业,会成为整个社会认识这一变革运行机制的灯塔。丰饶从来不是写在政策报告里的文字,而是交付上线的软件。
Garry Tan:我有一位朋友,他的孩子患有一种罕见的癫痫症。他建立了一个包含8万个Markdown文件的代码仓库,这是一个专门为一个底层小男孩打造的企业大脑。他将自己推向了人类对儿子这一特定病情认知的绝对边缘。没有实验室,没有资金拨款,也没有任何人授意。只有一个父亲、一台笔记本电脑和一座图书馆。这绝不是一个题外话,这恰恰就是我过去20分钟里一直在描述的系统架构。一座图书馆加上图书管理员,在最正确的时刻翻开最正确的三本书,全部聚焦在这个男人世界上最珍爱的事情上。现在,你们也可以做到这一点。
Garry Tan:过去每一个让你觉得“要是有个专家帮我就好了,可惜我请不到”的难题,现在你都能解决;每一个你曾认为漏洞太多而无法修复的代码库,现在你都能全部修复;每一个由于体量太大而无法阅读的档案库,每一个由于过于杂乱而无法清洗的数据集,以及每一个曾经被告知不要去白费劲的宏大挑战——现在,我们完全有能力去攻克这些看似不可能的难关。
Garry Tan:在座的每一个人现在都可以飞翔,这不是比喻,而是技术层面的事实。为了生存、为了发展、为了获胜,你们必须这样做。Theo问我们现在应该构建什么,这就是全部的答案:去构建一家AI原生公司,并构建其底座——那个大脑、记忆层以及不断产生复利的图书馆。这会让继你们之后的每一家公司的构建都变得更加容易。去攻克那些不可能的难关吧,去编写那个测试,去交付那个技能。你们即将在这场创业沙场上看到的某些公司其实已经开始这么做了。去构建那个把它做到极致的公司吧。谢谢大家。
本文来自微信公众号“划重点KeyPoints”,作者:林易,36氪经授权发布。













