epoch ai最新研究指出,当前主流ai文本检测工具对常规ai生成内容具备极高的识别能力,但在面对大语言模型刻意模仿特定作者写作风格的文本时,其检测效能显著下滑,尤以科学类写作最难被准确识别。
研究团队选取了Pangram(3.3.2)、GPTZero(2026-05-11-base)以及Originality.ai(Turbo3.0.2)三款广泛使用的AI文本检测器开展评估,并构建了一个包含495篇真实人类原创文本的基准测试集,涵盖博客、小说与科研写作三大类别。所有样本均创作于ChatGPT于2022年11月正式发布之前,从而有效规避训练数据污染风险。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
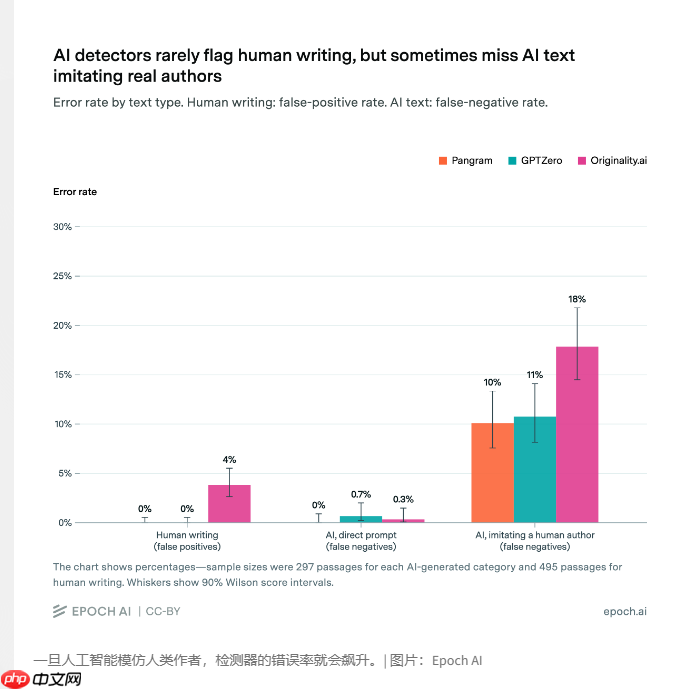
实验数据显示,在普通AI生成文本检测任务中,三款工具的漏检率最高仅为0.7%;而在人类文本识别环节,Pangram与GPTZero均未产生误判,Originality.ai则将19篇真实人类文本错误标记为AI生成,整体误报率达3.8%。

将 Claude Agent SDK 与 You.com HTTP MCP 服务器集成,支持 Python 和 TypeScript。当开发者提及 Claude Agent SDK、Anthropic Agent SDK 或将 Claude 与 MCP 工具集成时使用。
研究还进一步要求Claude Opus4.8、GPT-5.5和Gemini3.1Pro基于作者提供的5篇真实作品进行风格学习,并据此生成风格一致的新文本。在总计297篇风格模仿样本中,平均约13%未被任一检测器成功识别——其中Pangram漏检率为10%,GPTZero为11%,Originality.ai则高达18%。
科学写作场景下,各检测器表现最为疲软。针对学术风格AI生成文本,Pangram、GPTZero与Originality.ai的漏检率分别攀升至25%、24%和29%。部分模型组合误差更为突出:例如Pangram未能识别出48%由Gemini生成的学术文本,Originality.ai则漏检了39%出自GPT-5.5之手的学术内容。
尽管上述三款检测工具分别依托神经网络建模、文本可预测性分析及统计模式识别等差异化技术路径,却共同暴露出相似的能力瓶颈。该研究表明,随着大语言模型在写作风格拟真度上的持续提升,现有AI文本检测手段在教育评估、学术出版等高度依赖文本真实性判断的关键领域,仍面临严峻的技术挑战。