


在科技迅猛演进的当下,ai 与人类之间的交互正变得愈发紧密,但传统视频通话仍常受困于画面卡顿、响应延迟以及音画不同步等顽疾。而通义实验室全新发布的 wan-streamer v0.2,一举打破这些技术瓶颈,以低至550毫秒的端到端响应延迟,真正实现了如临其境、自然流畅的“面对面”对话体验。
Wan-Streamer v0.2 是一款创新型端到端全模态理解与生成模型。它将“听觉感知、视觉理解、语言表达、动作演绎”四大能力深度融合于单一 Transformer 架构之中,赋予 AI 类似人类的实时情境感知与即时反馈能力。无论输入是语音、文字还是动态视频,系统均可毫秒级完成解析,并生成高度协同的多模态输出。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
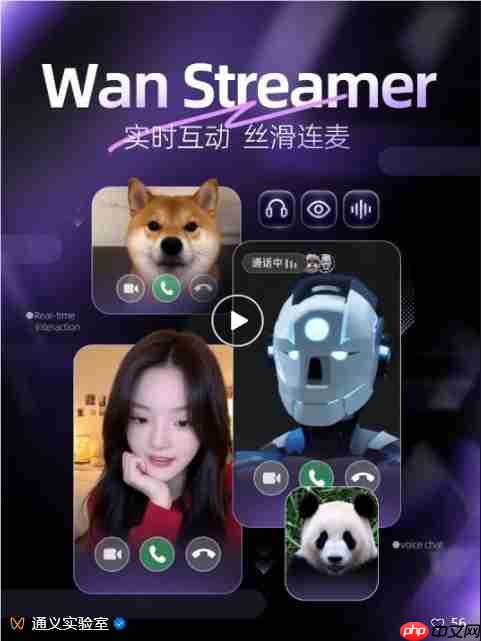
相较于当前主流实时交互方案,Wan-Streamer 在响应效率上实现跨越式提升——整链路延迟压缩至0.55秒(含网络传输耗时),远优于多数现有语音驱动对话系统。同时,其输出画质全面升级:分辨率由原先的192×336跃升至640×368,画面更细腻、场景更丰富、细节更可辨。
这一性能飞跃,根植于其颠覆性的系统架构。区别于传统依赖多阶段串联处理的流水线式设计(易引发信息衰减与模态错位),Wan-Streamer 首创“流式单元”机制,每160毫秒即可完成一次完整的输入感知、内部状态更新与响应生成闭环,从而保障交互全程丝滑连贯。

在本次迭代中,AI 不再局限于静态或半身的“虚拟头像”,而是进化为具备全身表现力的数字人实体。用户不仅能观察到精准的眼神追踪、自然的身体姿态与协调的手势动作,还能感知其所处的三维环境氛围。这种沉浸式呈现大幅增强了交互的真实性与情感亲和力。
Wan-Streamer v0.2 的落地潜力极为广阔,已覆盖口语训练、心理陪伴、个性化教学、智能游戏NPC等多元场景,凡需强“在场感”与高拟真度的领域,皆可成为其施展舞台。
综上所述,Wan-Streamer v0.2 凭借原生流式架构与分布式推理能力的深度协同,正推动人机沟通迈入类人化新纪元。这项技术的后续演进路径与生态延展,无疑将持续引发业界高度期待。













