





在具身智能研究中,如何赋予机器人类人级别的物理空间精准感知能力,始终是行业亟待突破的关键挑战。近期,由蚂蚁集团孵化的具身智能企业robbyant正式对外开源lingbot-vision模型家族。该系列基于自监督学习的视觉transformer架构,首创“边界驱动建模”范式,在密集型空间感知任务中展现出突出实力,多项核心指标甚至优于参数量高出数倍的前沿大模型。
当前主流视觉基础模型普遍聚焦于“物体识别”任务——即判断图像中存在哪些目标,却普遍弱化了机器人执行物理操作所依赖的核心要素:物体边缘、轮廓结构与三维深度信息。LingBot-Vision反其道而行之,将“边界信息”设为模型预训练的首要信号源。借助掩码边界建模(Masked Boundary Modeling)技术,模型可自主定位图像中语义与几何信息最密集的边界区域,并以此作为核心监督信号进行训练。这一设计不仅强化了模型的语义理解能力,更自然催生出高精度的空间几何建模能力。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
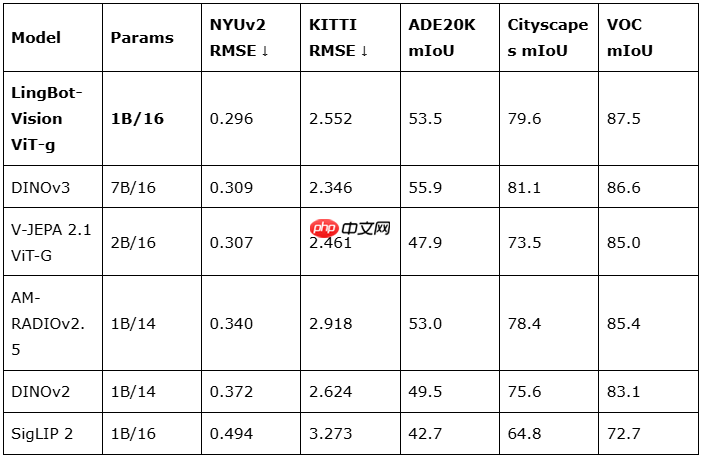
性能方面,LingBot-Vision旗舰型号ViT-g/16仅含11亿参数,却在NYU-Depth v2等权威深度估计基准上刷新最优结果,综合表现超越参数达70亿的DINOv3模型;同时其训练所需数据规模仅为后者的约三分之一。为适配资源受限的实际部署环境,该系列还提供涵盖3亿参数及更轻量级的蒸馏版本,确保在各类硬件平台上均能维持顶尖的密集预测水准。
为验证技术落地效果,研发团队同步发布了升级版深度补全系统LingBot-Depth 2.0。实测表明,该系统在应对玻璃、水杯等传统视觉感知盲区的透明物体时,深度重建准确率实现显著跃升。值得注意的是,随着训练数据持续扩充,LingBot-Vision的性能提升曲线仍保持稳健上升趋势,未出现典型大模型常见的性能饱和现象,充分印证了以边界为中心的空间表征架构在复杂真实场景中的强大适应性与扩展潜力。
目前,LingBot-Vision已在Hugging Face平台以Apache-2.0许可证全面开源,覆盖giant、large、base、small四种规格的完整权重文件与端到端推理代码。随着该技术的广泛应用,开发者有望以更低计算开销,为机器人注入更细腻、更可靠的物理世界感知能力,加速具身智能向高精度、强交互方向演进。














