




7月10日,蚂蚁灵波正式推出业界首个面向具身智能原生构建的世界动作模型——lingbot-va2.0。此次发布,标志着机器人基础模型正经历一次根本性跃迁:从“以数字世界模型为底座进行迁移适配”,全面转向“以物理世界交互本质为出发点的原生设计”。这不仅是技术路径的升级,更体现了一种关键的战略选择:机器人的“大脑”不再依赖对大语言模型或视频生成模型的能力“移植”,而是围绕动态环境建模、因果关系推演、毫秒级实时响应等真实具身需求,从零开始系统性重构。
依托这一原生架构,LingBot-VA2.0在真实机器人平台上展现出卓越的执行速度与跨任务泛化能力。以下视频即为实证案例:无需任何外部摄像头辅助,机器人即可自主完成与人类之间的多轮随机击打交互,全程闭环感知—决策—执行一气呵成。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
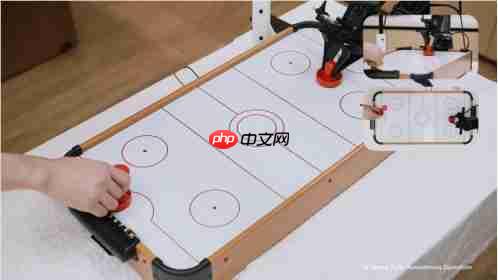
今年以来,“世界模型如何真正赋能具身智能”已成为全球学术界与产业界共同攻坚的核心命题。回归本源,物理世界的本质是连续、因果、可干预的。因此,机器人所需的预测能力,必须是持续符合物理规律、支持动作反事实推演的“因果预测”。它不仅要判断“现在该做什么”,更要理解“这个动作将如何改变环境”,并据此规划后续行为链。当前主流方案多基于面向AIGC(人工智能生成内容)的视频生成模型,再通过下游微调适配控制任务。
但需清醒认识到:内容生成与运动控制存在底层目标鸿沟——前者追求画面逼真度与创意表达,后者则严苛要求动作合理性、时序一致性与执行鲁棒性。这种目标差异,使得两类模型在预训练阶段就已形成截然不同的能力偏好。若强行用微调方式将视频生成模型“改造”为动作控制器,极易引发知识覆盖、推理偏差、泛化退化等结构性缺陷。
LingBot-VA2.0选择迎难而上,开辟一条更扎实但也更具挑战性的技术路径:采用自回归架构,从海量真实世界动作数据出发,端到端开展预训练,并通过四大核心创新实现原生基模构建。
其一,首创语义视觉-动作联合分词器(Semantic Vision-Action Tokenizer),作为新型视觉编码器,在图像压缩阶段即注入动作语义对齐机制,显著提升“指令理解→动作生成”的映射精度与响应一致性;
其二,贯彻严格因果预训练范式,确保所有视觉预测与动作序列生成均遵循不可逆的时间流向,杜绝未来信息泄露,筑牢物理世界建模的因果根基;
其三,集成稀疏专家混合(MoE)结构,在保障单卡推理吞吐的前提下大幅扩展模型表征容量,兼顾性能深度与部署效率;
其四,构建增强型异步推理引擎,支持边执行、边预测、边校准:在动作输出的同时同步推演未来状态,并即时融合最新传感器观测,实现毫秒级闭环反馈与策略迭代。得益于此,LingBot-VA2.0在行业普遍受限的“具身世界模型实时性”难题上,交出了单GPU达150Hz稳定推理的领先答卷。
从落地实效看,一台真正能“干活”的机器人,必须做到“看得清”“想得准”“动得稳”。本周,蚂蚁灵波密集发布并开源一系列垂直能力模型:专注空间感知的LingBot-Vision与LingBot-Depth2.0、支持“一脑控多机”的跨平台动作模型LingBot-VLA2.0、强化实时人机协同的LingBot-World2.0,以及更高吞吐效率的视频生成基模LingBot-Video。这些模型共同构成了蚂蚁灵波对具身原生能力图谱的系统性拆解;而LingBot-VA2.0,则是该技术体系的集大成者与里程碑式收官之作,也由此正式拉开具身智能原生时代的大幕。
蚂蚁灵波CEO朱兴指出:“我们一方面将持续突破具身智能的技术天花板,另一方面也将加速构建开放、协同的技术生态与场景生态,推动机器人从实验室走向产线、物流、服务等真实产业腹地。”
据悉,蚂蚁灵波将于7月17日至20日亮相2026世界人工智能大会(WAIC),在上海世博展览馆(H3-B302、H1-C701展位)全面呈现“全栈大脑2.0”在工业、仓储、家庭等多类场景中的端到端落地能力,欢迎现场体验。














