


在尚未开放公众测试的情况下,openai 仅凭文本生成视频模型 sora 的一组预告内容,就迅速引发了科技圈、互联网行业和社交媒体的集中讨论。
根据 OpenAI 官方发布的视频案例,Sora 可基于用户输入的文本生成最长约 1 分钟的复杂场景视频。除了画面细节表现突出,这一模型还展现出对镜头运动的模拟能力。
从目前公开的效果来看,行业关注的核心,并不只是“能生成视频”,而是 Sora 在一定程度上呈现出对真实世界的理解能力。与其他文本生成视频模型相比,Sora 在语义理解、画面表现、视觉连贯性和生成时长方面都体现出明显优势。
OpenAI 将其定义为“世界模拟器”,称其能够模拟物理世界中的人物、动物与环境特征。不过,OpenAI 也明确表示,Sora 仍不完美,现阶段依然存在理解偏差以及潜在安全问题。
也正因此,Sora 目前仅向极少数用户开放测试。OpenAI 尚未公布其面向大众开放的具体时间,但仅凭现阶段公开的演示内容,已经足以让同类模型研发者感受到技术差距。
Sora 预告内容为何迅速引爆关注
随着 OpenAI 发布 Sora,中文互联网很快出现大量围绕其能力的讨论。
不少自媒体和行业人士都对 Sora 的表现给出高度评价。360 创始人周鸿祎曾表示,Sora 的出现意味着 AGI 的实现时间有可能从 10 年缩短至两年左右。短时间内,Sora 的谷歌搜索热度快速上升,关注度一度逼近 ChatGPT。
Sora 受到广泛关注,直接原因在于 OpenAI 公布了 48 段演示视频,其中最长时长达到 1 分钟。相较此前文生视频模型 Gen2、Runway 的生成时长上限,这一表现进一步突破,同时画面清晰度更高,镜头语言也更成熟。
例如,在一段 1 分钟的视频中,一名身着红裙的女性走在霓虹闪烁的街头,整体风格偏写实,画面流畅自然。更受关注的是人物特写部分,脸部毛孔、斑点、痘印等细节都被模拟出来,妆容状态、颈部纹理与面部状态之间也保持了较强一致性。
除了人物写实效果,Sora 还展示了对动物和环境的模拟能力。在一段维多利亚冠鸽的多角度特写视频中,蓝色羽毛、红色眼珠的动态以及呼吸节奏等细节都被较为清晰地呈现出来,使得画面真假边界进一步被压缩。
对于非写实风格内容,Sora 同样给出了较强的生成效果。部分创意动画片段呈现出接近成熟动画电影的视觉质感,也因此引发了外界对于动画制作行业变化的讨论。
更重要的是,Sora 对文本生成视频模型的提升,并不只体现在时长和画质上。它还能模拟不同镜头与拍摄轨迹,包括第一人称游戏视角、航拍视角,以及类似电影一镜到底的连续镜头表达。
从这些公开案例不难理解,为什么互联网圈和社交媒体会对 Sora 产生如此强烈的反应。需要注意的是,目前外界看到的仍只是 OpenAI 释出的预告级内容。
OpenAI 如何用“视觉补丁”训练 Sora
那么,Sora 的模拟能力是如何实现的?
按照 OpenAI 发布的 Sora 技术报告,这一模型正在尝试突破早期视觉生成模型在数据类型、视频长度和固定尺寸上的限制。
过去,文本生成视觉内容的研究通常采用循环网络、生成对抗网络(GAN)、自回归 Transformer 以及扩散模型等方案,但这些方法大多集中在较少的视觉数据类别、较短视频或固定尺寸视频的处理上。
Sora 采用的是一种基于 Transformer 的扩散模型。其生成过程可分为正向过程和反向过程两个阶段,这也使其具备了沿时间维度向前或向后扩展视频的能力。
在正向过程中,模型模拟的是从真实图像逐步扩散到纯噪声图像的过程,也就是不断向图像中加入噪声,直到图像完全被噪声覆盖。反向过程则与之相反,模型会从噪声图像中逐步恢复出清晰图像。OpenAI 通过这种方式,让 Sora 学习视觉内容是如何形成的。
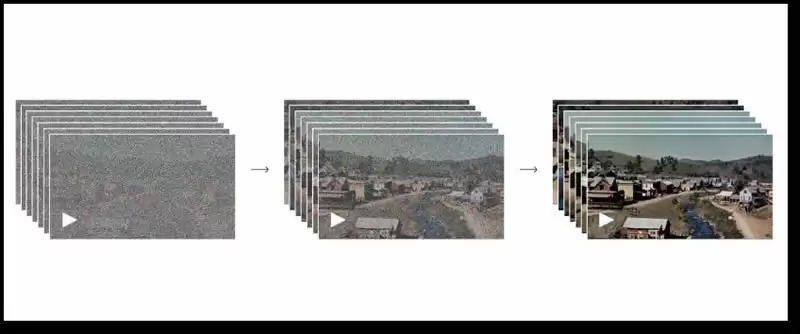
从全噪点到清晰图的过程

这一过程需要通过大量训练反复完成。模型会在迭代中学习如何逐层去除噪声、还原细节,从而生成高质量图像。扩散模型也因此在图像生成、图像编辑和超分辨率等任务中表现出较强能力。
这解释了 Sora 为什么能够生成高清且细节丰富的视觉内容。但从静态图像迈向动态视频,还需要模型在数据和训练层面进一步扩展。
在扩散模型基础上,OpenAI 将视频、图像等不同类型的视觉数据转换为统一表示,并据此对 Sora 进行大规模训练。OpenAI 将这种表示方式称为“视觉补丁(patches)”,可以理解为一种更小粒度的数据单元,类似于 GPT 处理文本时所使用的 token 集合。
研究人员首先会将视频压缩到低维潜空间,再把这种表征拆分为时空 patches。这样的表示形式具有较高扩展性,便于完成从视频到 patch 的转换,也更适合训练一个同时处理多种视频和图片类型的生成模型。
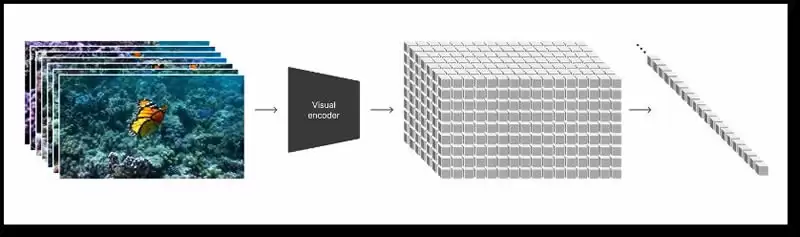
将视觉数据转化为 patches
为了以更少的信息量和更低的计算压力训练 Sora,OpenAI 还开发了一个视频压缩网络,先将视频降维到像素级低维潜空间,再基于压缩后的视频数据生成 patches。与此同时,OpenAI 也训练了解码器模型,用于把压缩后的信息重新映射回像素空间。
基于视觉补丁这种表示方式,研究者可以使用不同分辨率、不同持续时间以及不同长宽比的视频和图像来训练 Sora。进入推理阶段后,Sora 则能够通过在适当大小的网格中排列随机初始化的 patches,来判断视频逻辑并控制最终生成视频的尺寸。
OpenAI 在报告中提到,随着大规模训练推进,视频模型开始呈现出一些值得关注的能力,包括更真实地模拟现实世界中的人物、动物与环境,生成高保真视频,并实现一定程度的 3D 一致性和时间一致性,从而更接近对物理世界的模拟。
能力惊艳之外,Sora 仍有明显局限
无论从结果展示还是技术路线来看,Sora 都体现出很强的模型能力,但普通用户目前还无法直接体验。现阶段,外界更多是通过在 X 上向 OpenAI 创始人 Sam Altman 提交提示词,由其代为生成并公开展示视频结果。
这种有限开放的方式,也让外界对 Sora 的真实水平保持一定审慎态度:它是否真的如官方展示的那样强?
对此,OpenAI 的态度相对直接。官方承认,Sora 目前仍存在一些问题。类似早期 GPT 的“幻觉”现象,Sora 也会在以视觉为主的视频结果中出现较为具体的错误。
例如,它还不能准确模拟许多基础物理交互过程,包括跑步机履带与人的运动关系,以及玻璃杯破碎后液体流出的时序逻辑等。
在一段“考古工作者挖掘出一把塑料椅”的演示片段中,塑料椅是直接从沙子里“飘”出来的。
还有一段视频里,小狼崽会凭空出现,因此被网友调侃为“狼的有丝分裂”。
在部分案例中,模型也会出现前后左右方向判断不清的问题。
这些动态画面中的瑕疵说明,Sora 在物理运动逻辑的理解上仍有待继续训练和完善。与此同时,相比 ChatGPT 主要面向文本交互,Sora 直接作用于视频内容,其道德与安全风险也更加直观。
在此之前,文生图模型 Midjourney 已经让外界意识到,“有图未必有真相”。当人工智能能够生成高度逼真的图像时,虚假内容就更容易成为谣言传播的载体。身份验证公司 iProov 的首席科学官纽维尔博士也表示,Sora 可能让“恶意行为者更容易生成高质量的假视频”。
可以预见,如果这类生成视频能力被恶意滥用,用于欺诈、诽谤,或传播暴力、色情内容,潜在后果将难以低估。这也是 Sora 在带来技术震撼的同时,也引发外界担忧的重要原因。
OpenAI 显然也意识到了相关安全问题,这或许正是 Sora 目前仅以邀请制向极少数人开放测试的原因之一。至于何时面向大众开放,OpenAI 仍未给出明确时间表。不过从目前公开的演示效果来看,留给其他公司追赶 Sora 的时间窗口并不宽裕。












