长期以来,人工智能体(agent)的任务执行能力主要依托于文本指令。然而,在修图、图形界面(gui)操作等高度依赖视觉理解的任务面前,纯文本表达的局限性日益凸显。近日,openjiuwen社区正式推出skill-omni——业界首个完成工程化落地的多模态skill范式。它不仅推动agent的能力从“理解文字”跃升至“感知图像”,更在智能体与复杂视觉任务之间架起一座全新桥梁。
传统Skill范式在应对视觉类任务时,常因缺少直观视觉锚点而效果受限。以图像修复为例,“提升整体氛围感”这类模糊的文字提示,难以让Agent准确判断色彩饱和度、光影过渡等细节尺度。Skill-Omni的关键突破在于:将网页快照、交互界面状态及视频操作序列转化为结构化、可复用的视觉经验单元。借助对比示意图与关键帧标注,Agent不仅能掌握操作步骤链路,更能清晰捕捉任务目标所对应的“视觉黄金标准”,从而大幅提升执行精度与成功率。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
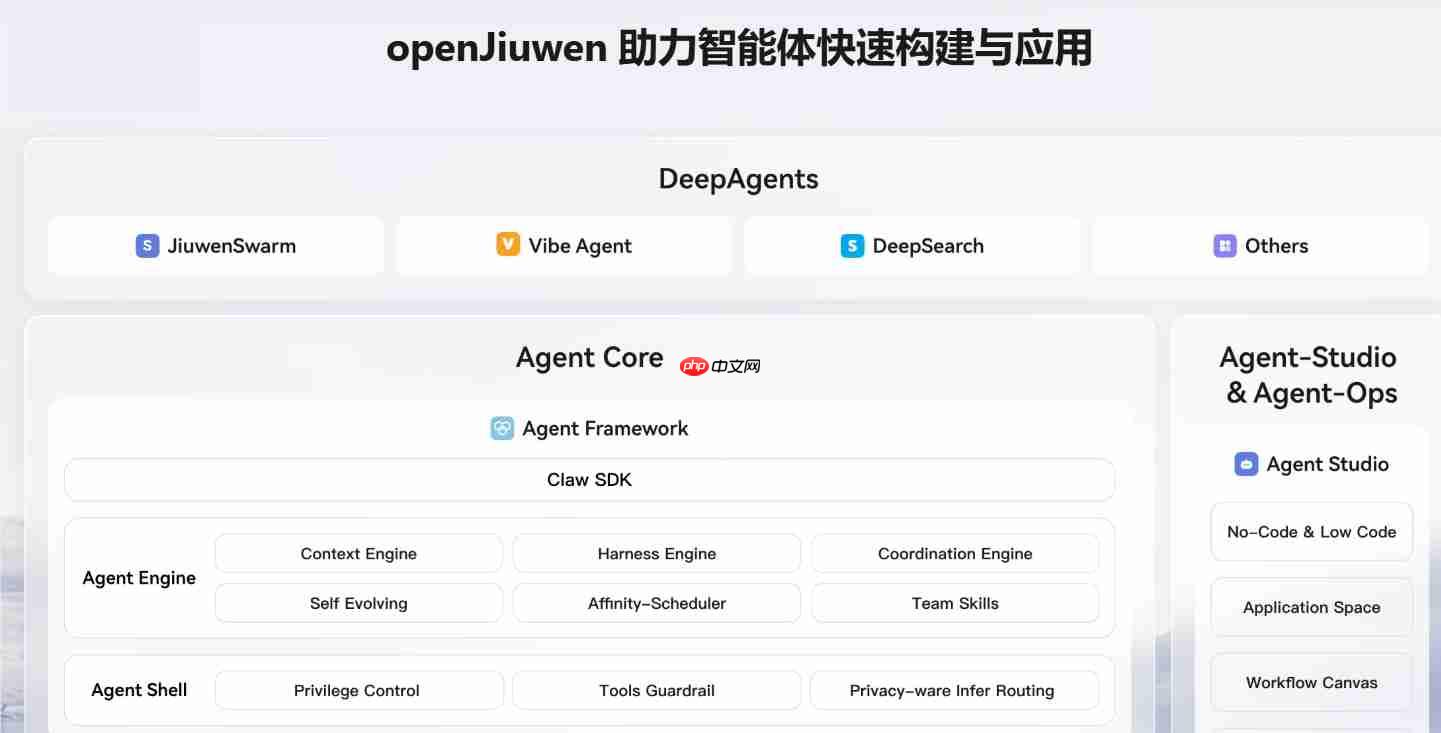
在落地实践中,开发者可通过Skill-Omni内置的自动化生成模块,一键将任意网页链接或B站教学视频转换为多模态Skill。系统自动识别并剔除广告、弹窗等干扰元素,精准截取核心操作界面,并解析出逻辑连贯的动作序列。该机制将海量分散的在线教程资源,高效沉淀为Agent专属的高质量“视觉知识库”,使软件安装、参数配置、UI设计等复杂流程不再依赖反复试错,真正实现经验的即取即用与规模化复用。
为平衡模型上下文容量与视觉信息效用,JiuwenSwarm平台构建了一套智能“按需加载”机制。运行过程中,系统实时评估当前任务对视觉线索的依赖程度,仅在模型明确需要图像辅助决策时才动态注入对应截图或帧序列,彻底规避了冗余图片堆叠导致的上下文膨胀问题。这种轻量级、场景化的视觉证据供给方式,使Agent在执行中能如人类般随时调阅“操作样板”,显著降低误判与异常操作风险。
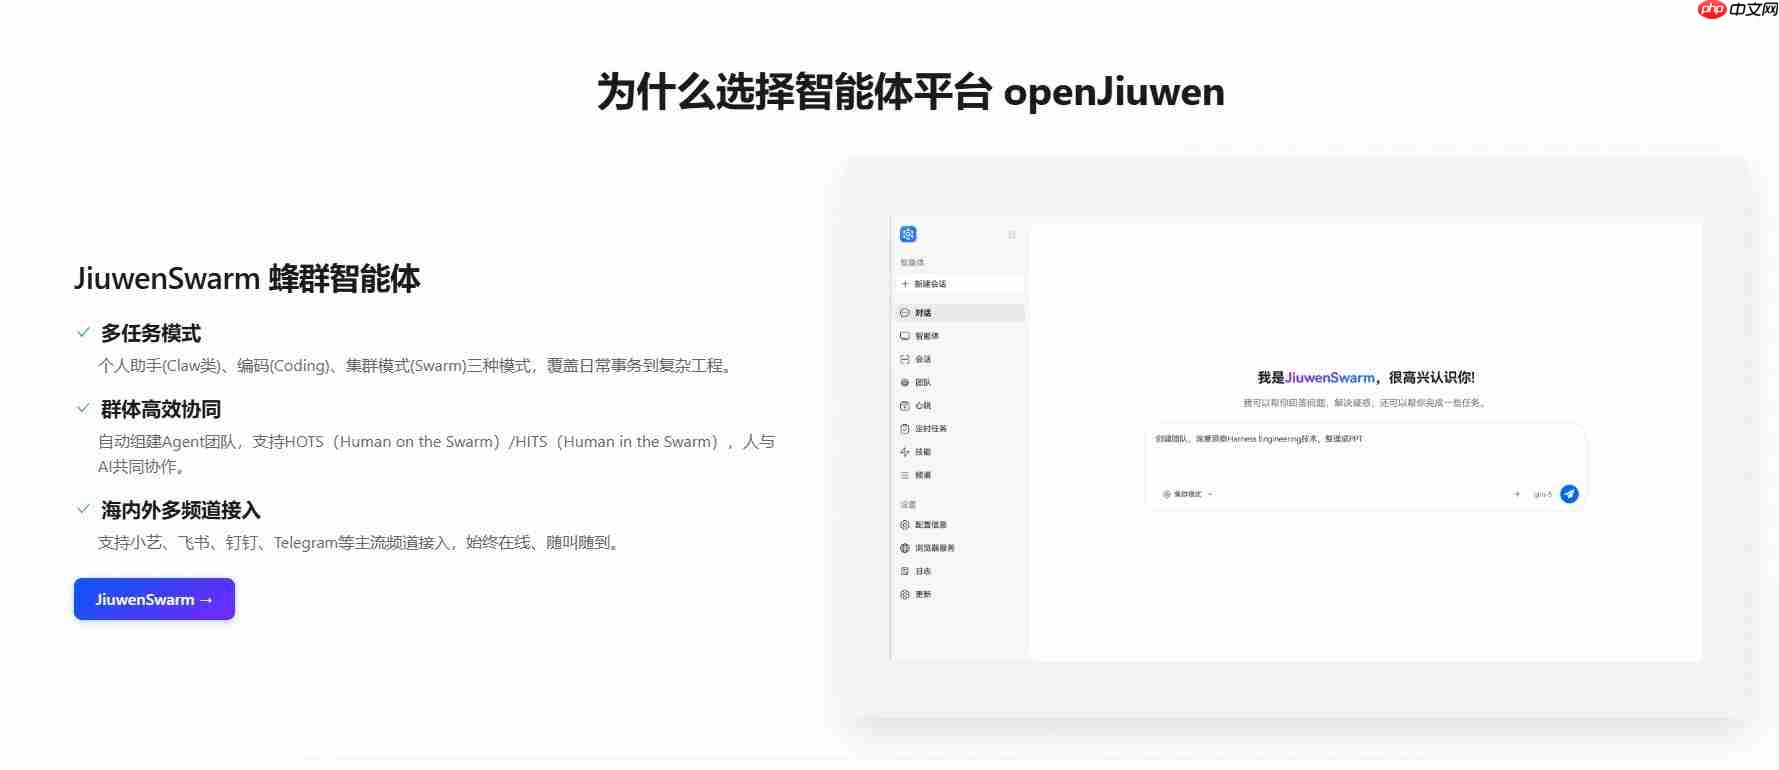
Skill-Omni的发布,标志着AI Agent的经验构建范式正由单一文档驱动,全面迈入视觉表征与逻辑推理深度融合的多模态新阶段。目前,该技术已在图像编辑、桌面自动化、企业级知识图谱增强等多个实际场景中验证其强大适应性。展望未来,随着Skill-Omni向Physical AI方向延伸,其有望通过积累真实世界中的物理交互数据(如机械臂操作、设备调试等),赋能智能体在实体空间中完成高鲁棒性、高保真度的动作控制。现阶段,Skill-Omni已集成于JiuwenSwarm平台,开箱即用,为开发者构建下一代多模态Agent提供坚实底座。