你去菜市场买猪肉,摊主报价二十八一斤,你问能不能便宜,他说“就这价,不买拉倒,对面没有的”。你转身一看,对面真开了一家新摊——门开着,猪还没宰,价签也没挂。再回头,摊主语气立马软了三分。
7月7日,路透社援引三名知情人士透露:DeepSeek已秘密推进自研AI推理芯片项目约一年,核心目标是降低对英伟达、华为等外部算力供应商的依赖,并显著压缩推理侧算力成本。消息一出,英伟达盘前股价下挫约1.6%,A股ASIC相关概念股逆势走高。
不少人第一反应是:DeepSeek一家杭州起家的大模型公司,真能挑战英伟达?国内先进制程仍卡在7纳米以上,美国出口管制层层加码,这会不会只是个营销噱头?
这个质疑本身跑偏了。DeepSeek做推理芯片,真正撼动的并非英伟达的技术高地,而是它那句“你没得选”的定价底气。而这底气,恰恰是英伟达两万亿美元估值最底层的支点。
训练与推理,本就是两条赛道
先厘清一个关键前提:训练大模型 ≠ 部署大模型,二者对硬件的要求天差地别。
训练阶段需海量参数同步更新,极度依赖高算力密度、超大内存带宽与低延迟互联,H100、B200这类旗舰GPU确有不可替代性。但推理呢?本质是单次前向传播——输入进来,模型跑一遍,输出结果。计算图高度固化,通用性要求大幅降低,反而为专用架构腾出巨大优化空间。
谷歌早已用实践验证这一逻辑。2016年TPUv1上线时采用28纳米工艺,而同期英伟达GPU已迈入16纳米时代。但谷歌内部测试显示:在典型推理任务中,TPUv1性能比同代CPU/GPU高出15–30倍,能效提升达30–80倍。 一块成熟制程的ASIC,在特定任务上碾压了更先进工艺的通用GPU。原因很简单:它把每平方毫米硅片都精准分配给推理所需的核心路径,不做任何冗余设计。
坦白讲,DeepSeek若推出一颗14纳米甚至7纳米级推理芯片,在工程层面完全可行——这和“复刻H100”根本不在同一难度量级。路透社报道指出,该公司已悄然接触芯片设计公司、晶圆代工厂及存储方案商,招聘也通过内推与猎头双轨并行。这些动作,处处透着务实落地的节奏感。
当然,制程只是第一道门槛。推理芯片真正的隐性瓶颈,在于显存带宽。当MoE模型参数迈向万亿级,哪怕仅激活部分Expert,仍需极高HBM吞吐支撑参数调度。而HBM供应链与IP授权,同样受制于人——三星、SK海力士在此领域的技术护城河,远比制程差距更难短期填补。因此,流片成功只是起点;能否持续“喂饱”,才是生死线。
多一个选项,就多一分话语权
这就是菜市场对面那家未营业却亮着灯的新摊的价值:它无需开张,只要存在,就能改写议价规则。
DeepSeek不需要做出最强芯片,只需要让谈判桌上出现第二个选项。
英伟达常年维持75%以上的毛利率。一家企业能把毛利做到如此高位,根基绝非成本优势,而是买家“别无选择”的现实。训练大模型?非H100不可;大规模推理部署?还得GPU集群;想用配套工具链?依旧绕不开CUDA生态。英伟达卖的从来不只是芯片,而是一套迁移成本极高的整体解决方案。这套方案的溢价权,正源于“唯一供给”这一事实,与硬件成本几乎无关。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
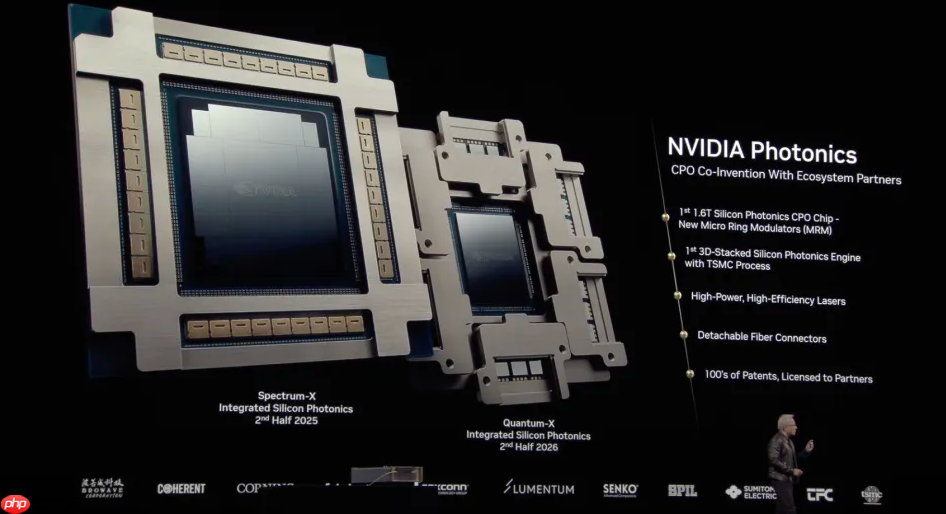
试想采购谈判场景已然变化:DeepSeek的算力采购负责人落座后,不必说“我们不买了”,只需轻描淡写一句:“我们自研推理芯片预计明年启动小批量流片,若价格缺乏弹性,推理业务将优先迁移至自研平台。”这句话值多少?足以撬动英伟达全部议价筹码。
垄断定价最脆弱之处在于:它只在买方认定自己毫无退路时才坚不可摧。哪怕退路尚在襁褓,哪怕流片尚未完成,哪怕良率还在爬坡——只要它真实存在,就足以让报价方手心出汗。而DeepSeek本身正是中国最大的推理算力需求方之一:其今年4月发布的DeepSeek-V4模型参数规模已达284B至1.6T,对外服务产生的推理负载庞大且持续。该项目背后,是扎实的内部需求驱动,而非纸上谈兵。
不止DeepSeek一家在行动
DeepSeek刷屏全网,但真正令华尔街绷紧神经的,远不止它一家。
谷歌TPU体系自2015年启动,至今已迭代八代。TPUv4基于7纳米工艺,在多项推理基准测试中较英伟达A100提速5%–87%(据谷歌2023年论文),其内部推理负载正加速向TPU迁移,对英伟达采购依赖持续减弱。AWS Trainium芯片已迈入第三代,不仅自用,OpenAI与Anthropic均已采用Trainium3承载部分推理任务。微软亦全力押注自研Maia芯片。
全球顶级大模型买家,正系统性削弱对英伟达的路径依赖。他们不会彻底弃用,但在具备替代选项的环节,已果断转向自有方案,将英伟达留给那些真正无解的场景。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
DeepSeek入场意味着什么?意味着中国最大推理需求方也正式踏上这条自主可控之路。这是一个结构性拐点信号。当然也要正视差距:谷歌、AWS依托台积电5纳米乃至3纳米产线,DeepSeek受限于制裁,只能立足国内成熟制程,体量与量产能力尚不在同一维度。但真正引发连锁反应的,是“多米诺骨牌又倒下一块”——连这个量级的玩家都开始自研,云厂商还有什么理由不向英伟达重新要价?
DeepSeek在软件栈上的独立性已相当可观:自研通信库hfreduce替代NCCL,构建分布式文件系统3FS,甚至已在华为昇腾平台上完成推理验证。当然,替换通信库不等于摆脱CUDA生态,TensorRT-LLM在推理端的深度优化仍是真实壁垒。但整套动作传递出明确信号:这家公司无意长期绑定任何单一外部供应商。
英伟达的“溢价空间”,正在被切片式收窄
本文无意渲染“英伟达即将崩塌”的唱衰论调——那既不客观,也不诚实。
CUDA生态确实是真实存在的护城河。全球数百万开发者扎根于此,成熟的模型、调优的工具链、封装好的算子库,均与CUDA深度耦合。新芯片要赢得市场,必须跨越软件适配这座大山,绝非流片成功即可绕过。DeepSeek的芯片项目尚处早期:从设计对接晶圆厂,到流片验证,再到良率提升与量产爬坡,每一步都面临真实的工程挑战。谷歌耗时十年才建成今日TPU体系,绝非一日之功。
但需区分两个概念:竞争壁垒 ≠ 定价权。CUDA生态抬高了用户迁移成本,却无法消除谈判空间。真正动摇英伟达根基的,是其估值中隐含的“定价权溢价”——该溢价建立在“AI算力需求爆发 + 英伟达独家供给”双重假设之上。如今前半句依然成立,后半句却正被系统性瓦解:谷歌、亚马逊、微软,加上DeepSeek,正用真金白银宣告——那个“独家供给”的假设,已站不住脚。
英伟达当然不会坐视不理。大客户定向折扣、软硬深度捆绑、加速推出推理专用产品线……这些反制手段早已启动。事实上,其针对云厂商的定制方案、面向大模型公司的软硬打包优惠,已在低调推进。真正的博弈焦点在于:溢价空间将在哪类客户层级、以何种速度率先被压缩? 大客户大概率率先拿到折扣,中小客户仍将维持原价。而这,恰是华尔街最敏感的变量——平均售价(ASP)还能坚挺多久?
在我看来,1.6%的盘前跌幅仅是情绪快照,真正的价格重估需要更长时间沉淀。但方向比幅度更重要——市场正用脚投票:英伟达的定价权溢价,正被一块块切割剥离。说白了,菜市场对面那家新摊还在装修,但英伟达已经悄悄低头,重新审视自己的价签了。
写在最后
回到开头的菜市场。那位喊出“就这价,对面没有的”的摊主,底气从来不来自肉质好坏,只取决于——对面有没有第二家。
DeepSeek自研芯片这件事,哪怕最终产品性能平庸,哪怕量产周期一拖再拖,甚至项目中途遭遇技术瓶颈,它所触发的最大影响或许早已发生:它改变了采购谈判桌上的对话逻辑。 过去英伟达可稳坐高位,如今每个自建推理体系的大客户,手里都多了一张“我也可以自己搞”的底牌——哪怕这张牌尚未真正打出。
DeepSeek做过什么?用580万美元训练出逼近GPT-4水平的模型;重写通信库与文件系统;在华为昇腾平台跑通推理;如今正与晶圆厂接洽。这家公司始终传递一种态度:拒绝永久依附任何外部供应商。
本质上,这是一个效率意识极强的买家,在系统性为自己铺设备用通道。市场上所有面临同样困境的买家,都在默默观察这条路是否走得通。
英伟达股价不会因一则早期项目传闻而崩塌,但一个值得长期追踪的问题已然浮现:当下一轮大模型算力采购谈判开启时,坐在对面的人,手里的筹码,是否已经不同?
免责声明
本文所涉上市公司及相关主体内容,系作者基于其依法公开披露的信息进行的独立分析与判断。相关信息来源包括但不限于公司定期报告、临时公告、投资者关系活动记录、天眼查及其他官方公开渠道。文中观点仅代表作者个人研究结论,不构成任何形式的投资建议、财务咨询或交易决策依据。读者据此做出的任何投资或商业决策,应自行承担相应风险。商业不许冷不对本文内容的准确性、完整性或时效性作出任何明示或暗示的保证,亦不承担因引用或依赖本文内容而产生的任何直接或间接责任。
本文来自微信公众号“商业不许冷”,作者:周既明,36氪经授权发布。