


同样一兆瓦电力,英伟达最新发布的gb300 nvl72可支撑61400个智能体并发运行,而上一代h200仅能承载约2600个。
两者之间,差距高达20倍。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
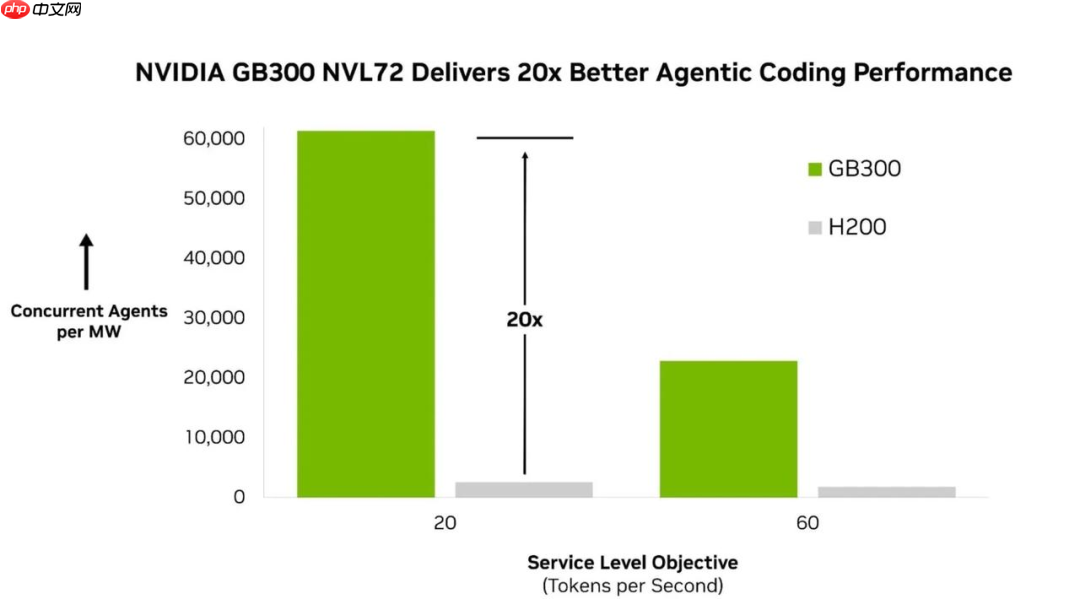
英伟达公布的AA-AgentPerf实测数据表明:在每秒20 token与每秒60 token两种服务速率下,GB300 NVL72每兆瓦所支持的并发智能体数量,均为H200的约20倍。
6月12日,当这组数字首次公开时,外界普遍视其为又一次性能展示。
但真正发生转变的,并非芯片本身有多强大,而是衡量算力的新标尺。
它正是由独立评测机构Artificial Analysis推出的全新基准——AA-AgentPerf。
Artificial Analysis在其官方博客中明确指出,这是业内首个专为「AI智能体(AI agent)」定制的推理性能评估标准。
该基准的核心指标也迥异于传统:不再聚焦于每秒处理多少token,而是采用「每兆瓦并发智能体数(Agents per Megawatt)」作为主衡量维度。
通俗来讲,即每输入1兆瓦电能,系统最多可同时驱动多少个持续工作的智能体。
FLOPS已沿用多年,每秒token数也长期作为主流指标,为何此时要推出AA-AgentPerf这一新基准?
旧标尺
已无法准确刻画智能体负载
要理解这一点,需先厘清智能体实际运行时的真实工作模式。
Artificial Analysis给出的判断十分清晰:2026年最典型的AI负载形态,早已与旧有基准诞生时所针对的场景截然不同——那些老基准测试的是固定长度的合成请求,且往往主动屏蔽了生产环境中真实启用的关键优化手段。
英伟达官方也打了一个形象比喻:
普通对话如同百米冲刺:模型接收一个问题,输出一段回答,随即结束;
而一个智能体执行任务,则更像一场接力赛。
它将目标拆解为数十甚至上百个步骤——读取文件、编写代码、执行命令、分析结果,再据此决定下一步动作,环环相扣,直至任务彻底完成。
整个过程中,大模型调用与工具调用交替进行,上下文持续累积增长,中间还夹杂着编译、数据库查询、网络搜索等外部操作。
其复杂度并非线性叠加,而是呈指数级放大。
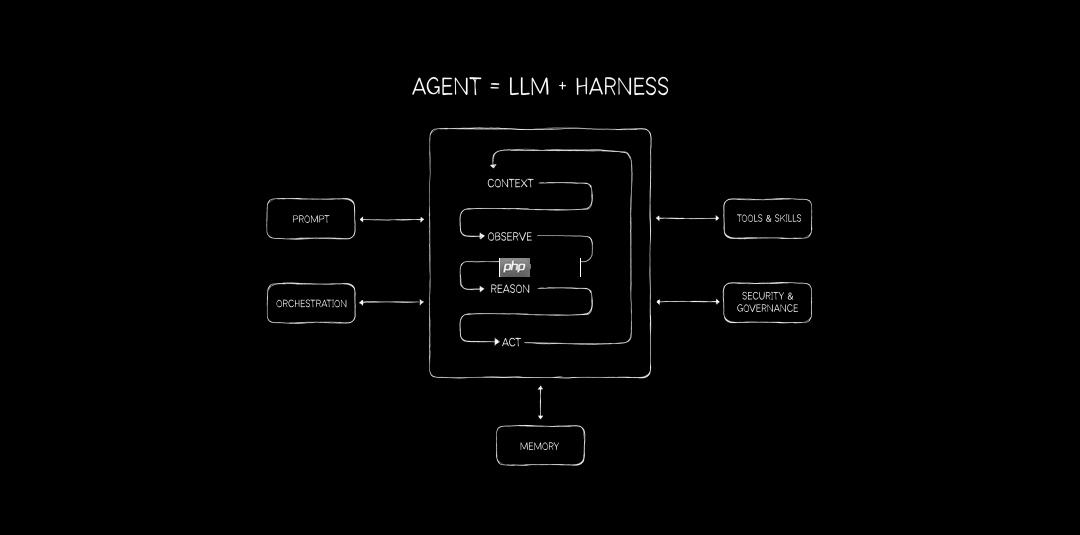
英伟达以“接力”类比智能体负载。单一目标被分解为几十至上百步,LLM调用与工具调用交替推进,形成不断延伸的长链式流程。
问题正源于此。
当前主流推理基准测试,均围绕单次请求设计:测量单个请求响应延迟、或单位设备最大并发请求数。
它们本就不是为智能体这类链式、状态化、多阶段的任务建模的。链式调用、工具等待、上下文爆炸式膨胀等特性,对系统的压力机制,与传统单次请求存在本质差异。
仅以长会话为例,就暴露了旧基准的盲区:同一段冗长前缀会在多轮交互中反复出现,能否高效缓存并复用,直接决定算力开销高低。
再加上工具返回结果常使上下文激增,而最终输出却可能仅有数百token,调度器与显存层级是否能承受这种忽长忽短、节奏不均的负载,成为系统是否稳定运行的关键。
而这恰恰是固定长度合成测试完全无法覆盖的维度。
对于真金白银采购硬件、建设数据中心的企业而言,他们真正关心的是:这套系统到底能同时支撑多少个活跃运转的智能体?每一千瓦时电、每一块GPU,又能换来多少实际可用的智能体产能?
这些问题,旧有基准无法作答。
首支专为智能体打造的标尺
AA-AgentPerf的设计逻辑与传统基准完全不同:它不使用人为构造的固定长度提示词,而是回放真实编程智能体的历史行为轨迹。
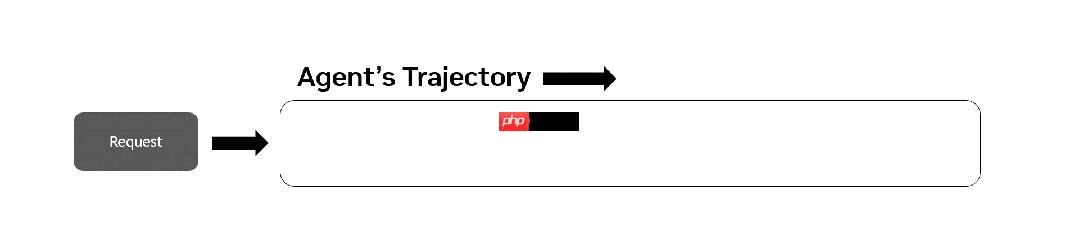
AA-AgentPerf回放的智能体轨迹示意。从初始请求出发,LLM调用与工具调用交替演进,直至任务闭环完成。
这些轨迹源自智能体在真实开源代码仓库中解决实际问题的过程,涵盖12种以上编程语言,单次会话最长可达200轮,上下文轻松突破10万token。
输入长度跨度极大,从5千至13万token不等,平均约为2.7万token。真正撑起长度的,并非原始提示,而是逐轮累积的工具返回内容与对话历史。
更关键的是它的评分方式。
它并不一味追求极限并发数。因为一旦并发堆得过高,每个智能体响应速度就会严重下降,高并发反而失去实用价值。
AA-AgentPerf反向设定:先锚定一项服务质量标准(SLO),要求每个智能体的输出吞吐率、首字延迟(TTFT)等指标必须达标,再测算系统在此约束下所能支撑的最大并发量。
该标准分为多个档位,包括每秒20token的“够用档”,以及每秒180token的“极速档”,每一档均对应现实中存在的典型服务水平。
WorkBuddy 4.10.0版本聚焦于用户体验与系统稳定性的全面提升。本次更新不仅带来了更美观、更流畅的界面交互,还解决了大量影响日常使用的关键问题,确保您的AI办公助手运行得更加稳定可靠。
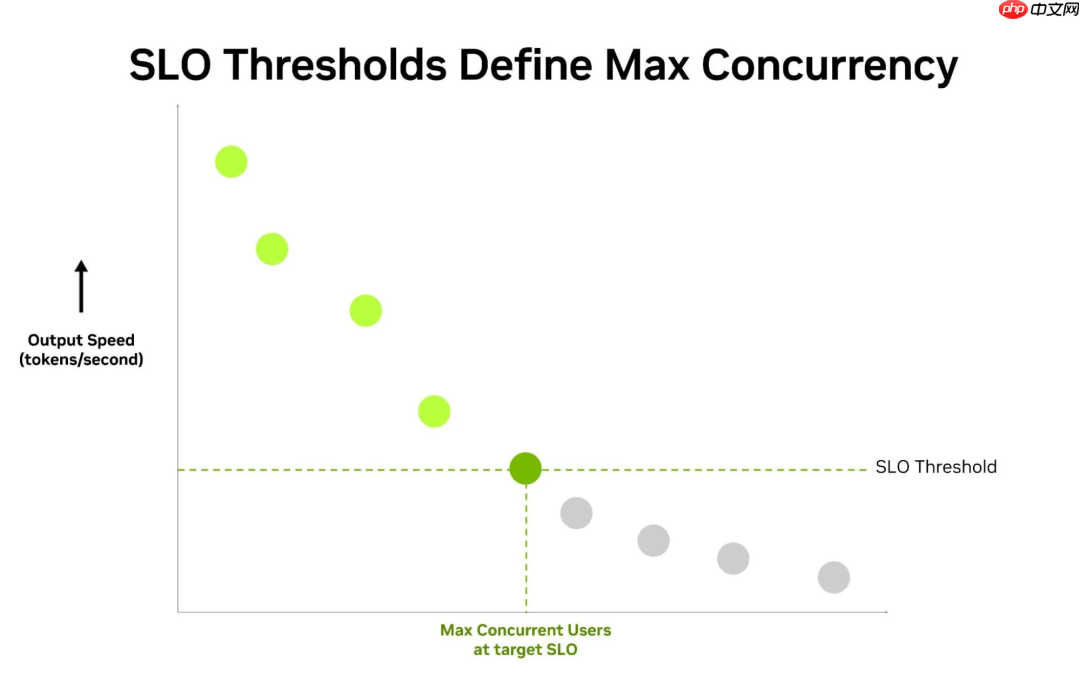
服务等级目标(SLO)如何界定最大并发能力。绿色区域代表达标区间,一旦并发提升导致响应速度跌破阈值,该点即为系统实际性能上限。
此外,它还做了一件其他基准极少尝试的事:全面放开厂商在真实生产环境中实际启用的所有优化策略。
KV cache复用、推测解码、预填充与解码分离部署……这些以往常被基准测试强制禁用的技术,在本次评测中全部开放。
理由很直接:关闭这些优化所测出的结果,对实际部署毫无参考意义。
与此同时,它同步监控输出质量,杜绝任何以牺牲回答准确性为代价换取并发提升的行为。因此,每一项软硬件层面的进步,都能被客观、真实地反映在最终得分中。
最终收敛到一个核心指标:每兆瓦并发智能体数。在一个电力日益紧张、能耗即成本的时代,这个指标,才是客户真正关注的价值锚点——从tokens/second,转向agents/megawatt。
每兆瓦领先20倍
每块GPU领先40倍
在一项代表当前最先进混合专家(MoE)模型的前沿测试中,GB300 NVL72每兆瓦可承载61400个并发智能体,平均每块GPU支撑57.5个。
作为对照的H200,每兆瓦仅约2600个,单卡仅1.4个。二者在每兆瓦维度相差约20倍,在单卡维度则相差约40倍。
这两个数值意义不同。
每兆瓦指标反映的是能源效率——相同电量所能支撑的智能体产能,是一笔能效账;
每GPU指标体现的是硬件密度——单卡所能承载的服务规模,是一笔硬件账。
借助这两项数据,用户可直接推算自身电力预算下,所能部署的智能体应用规模。
榜单中不仅包含英伟达GB300,亦纳入AMD MI355X。从单卡、整机到整机架,全部置于统一标准下横向对比。
首批结果揭示出两条显著规律:
规律一:机架级系统天然更具成本优势。它能将推理任务更充分地拆分并分布至更多GPU上,无论纯算力还是每兆瓦能效,均明显优于单节点架构;
规律二:从Hopper架构到Blackwell架构的跃迁,推动系统并发能力迈入全新量级,并非小幅迭代,而是代际跨越。
从单卡到机架
系统级协同的胜利
H200到GB300的升级,表面看是单卡性能提升,实质是一场系统级协同的胜利。
尤为关键的是,GB300 NVL72将72块GPU通过NVLink高速互联,整合为统一的机架级计算单元。
对于此类超大规模混合专家模型而言,这才是成败要害:模型整体可均匀分布于整套GPU集群之上并行执行,而非被迫压缩至单卡内硬扛。
CUDA底层进一步优化跨专家通信与计算的重叠调度,让协调各路专家所需的额外开销被算力悄然消化,而非堆积为延迟瓶颈。
TensorRT-LLM则负责在并发会话持续攀升时守住效率底线,例如将输入预处理与输出生成解耦,各自独立调优。
简言之,这一测试成绩,是硬件架构、高速互联与软件栈深度协同的结果。
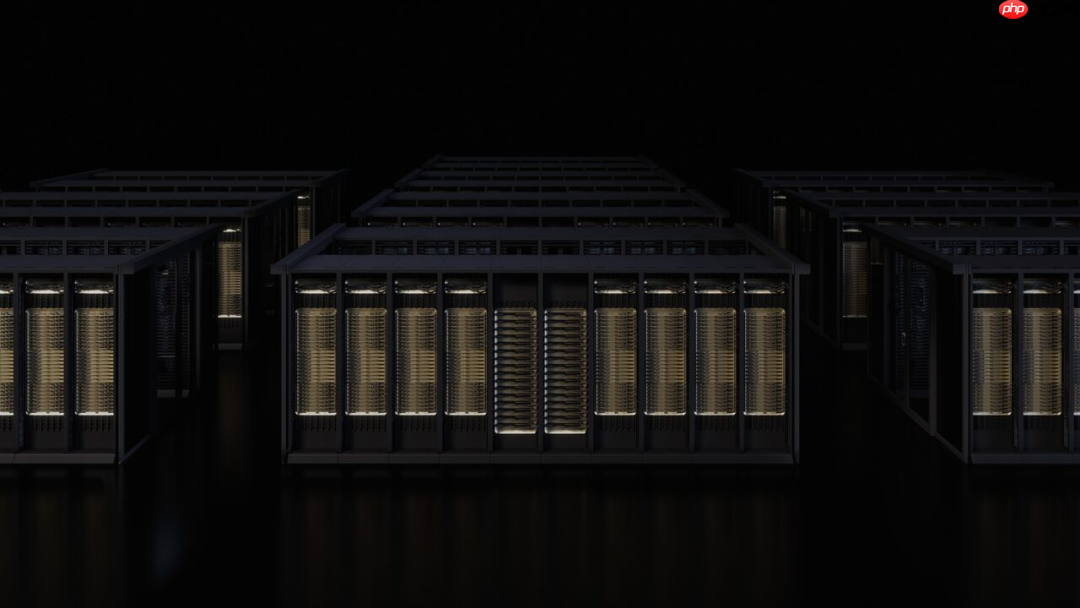
GB300 NVL72机架系统。72块GPU经NVLink构建成单一高带宽整体,这才是支撑6万个智能体协同运行的物理基石。
将72块GPU焊接成一个高带宽、低延迟的整体,使每块GPU均可快速共享参数、KV cache及中间计算结果,这才是6万个智能体得以高效协同运转的根本保障。
几条不可忽视的前提条件
需注意以下几点,避免将基准测试结果简单等同于真实生产表现。
第一,“6万”并非指一台机器实时运行6万个独立大模型实例。
这是基准定义下的并发会话模拟:每个智能体遵循预录制轨迹运行,工具调用也非真实执行,而是以一段预设CPU耗时进行仿真。
如此设计,是为了剥离外部变量干扰,确保结果仅反映算力本身差异;但这也意味着,它与真实生产环境中所能交付的实际服务能力,并不能直接划等号。
第二,基准成绩不等于服务承诺。
Artificial Analysis亦明确表示,该标准仍处于快速演进阶段,各家系统仍有大量未释放的优化空间,成绩将持续随软件迭代稳步提升。
第三,AA-AgentPerf目前仍属单一机构提出的评测框架。
它未来能否如MLPerf一般,成长为行业广泛认可的通用标尺,尚待时间验证。
参考资料:
https://www.php.cn/link/983c551e0b2e02d17c27f93dc691f1f8
https://www.php.cn/link/410e7a8274d8cdf0f354bfac7dd2c648
本文来自微信公众号“新智元”,作者:ASI启示录,编辑:元宇,36氪经授权发布。















