


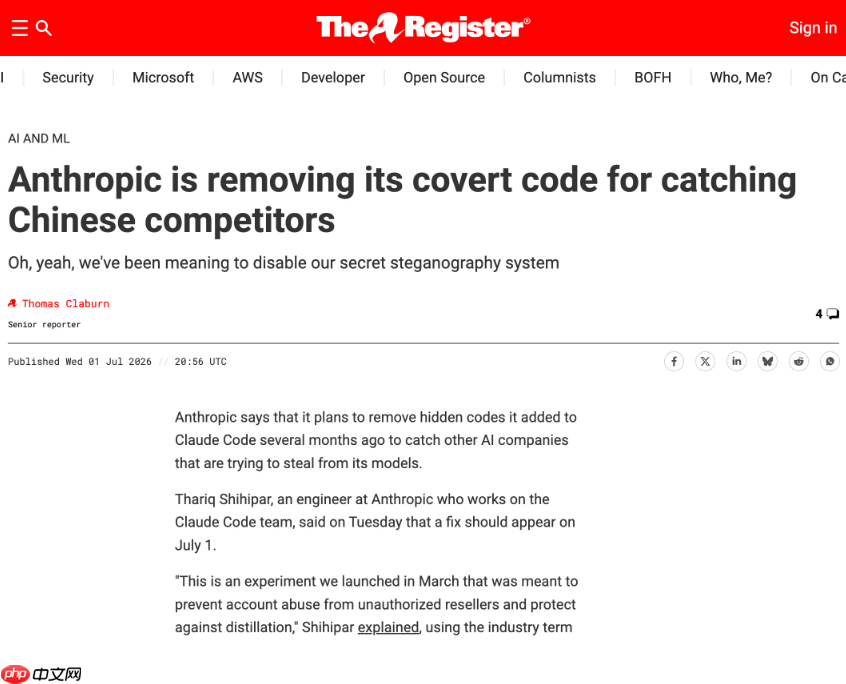
claude code 中一段未公开的代码悄然运行了整整三个月,时间跨度从4月2日延续至7月1日,期间既无任何日志更新,也未在官方文档中予以说明,导致绝大多数用户对此毫不知情。
Reddit 上的一位网友在分析其二进制文件时意外发现了该段隐藏程序。随后,多位安全研究人员对多个版本的源码展开逆向工程,并完成深入解析。海外主流科技媒体于7月1日就此事件发布重磅专题报道。
该隐藏模块的核心功能极为聚焦:专门用于识别两类用户——一是直接使用产品的中国大陆地区用户;二是通过国内AI企业提供的代理接口接入服务的终端使用者。整套识别逻辑设计高度隐蔽,常规检测手段难以发现。
研发团队采用了 Unicode 隐写术来传递识别指令,巧妙地将识别信号嵌入接口请求中的日期字段文本之中,使普通用户几乎无法察觉其中异样。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

双重校验叠加数据污染,误判风险显著升高
当用户手动配置了自定义代理地址后,系统将立即触发两项并行检测机制:其一比对设备本地时区信息;其二匹配加密后的域名黑名单。该黑名单采用双重加密算法保护,解密后可还原出包括百度、字节跳动、MiniMax 在内的上百个国内AI厂商及中转服务域名,覆盖范围极为广泛。只要用户设备时区属中国大陆,或所用代理域名落入黑名单,系统便会自动将响应文本中的部分字符替换为特定 Unicode 符号——这些符号在视觉上与常规字符几无差别,但后台却能据此精准打标识别。
此外,代码内还集成了反模型蒸馏标识机制:一旦命中目标用户,便会在输出中插入伪造的工具调用记录,从而干扰第三方机构利用其生成内容训练自有大模型的行为。官方后续回应称,该功能仅为防止账号非法转售而开展的临时性技术实验,新版客户端已全面剔除相关逻辑。然而,这一整套机制仍引发诸多质疑。
加密域名列表长期处于黑箱状态,既未公示也未提供申诉渠道;大量企业内部合规代理环境下的开发者亦被错误标记,带来明显的隐私泄露隐患与使用障碍。更引人注意的是,事件曝光时间点颇具戏剧性——就在美国政府刚刚解除对其旗下两款AI模型的出口管制限制之后,该识别代码丑闻随即浮出水面,形成强烈对比。而作为一款具备读取本地文件、修改代码等高权限能力的开发者工具,其底层潜藏未经披露的监测逻辑,无疑严重动摇了开发者群体对该产品信任的根本基础。















