








6月29日晚,deepseek正式宣布v4稳定版将于7月中旬全面上线。
公告指出:为更科学调配算力资源、保障服务连续性与可用性,V4正式发布后将同步优化API计费体系,首次引入“峰谷时段差异化定价”机制。
过去两周内,围绕DeepSeek还发生了两件标志性事件:
其一,6月16日,DeepSeek完成创立以来首轮融资,总额达510亿元,投后估值逼近4000亿元,标志着创始人梁文锋此前坚守的“不融资、不上市、不商业化”信条正式转向。
其二,在完成融资仅十余天后的6月27日,DeepSeek联合北京大学共同发布技术论文《DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation》,梁文锋作为核心作者之一署名其中。
立即进入“豆包AI人工智官网入口”;
立即学习“豆包AI人工智能在线问答入口”;
如果说DeepSeek的上半场,是用R1、V2、V3等模型不断验证自身在基础大模型领域的顶尖研发实力;那么下半场,则是在资本注入与技术纵深交汇之际,以真金白银兑现商业价值——它正努力成为一家真正可持续运转、具备完整闭环能力的科技企业。
01 500亿到账后,DeepSeek加速人才补强
融资落地后,DeepSeek Harness团队新任负责人崔添翼迅速进入战时状态。
6月25日晚间,DeepSeek在多个主流社交平台同步启动大规模招聘计划,涵盖算法、研发、运维、产品、数据工程及职能支持等七大方向,共计开放33个岗位,工作地设于北京与杭州,全部岗位均面向应届生及实习生开放。
从DeepSeek官网、Boss直聘、X(原Twitter)、小红书等渠道可见,这位毕业于浙江大学、今年3月加入团队的梁文锋校友,亲自下场参与招聘,并在评论区即时回应质疑、澄清误传。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
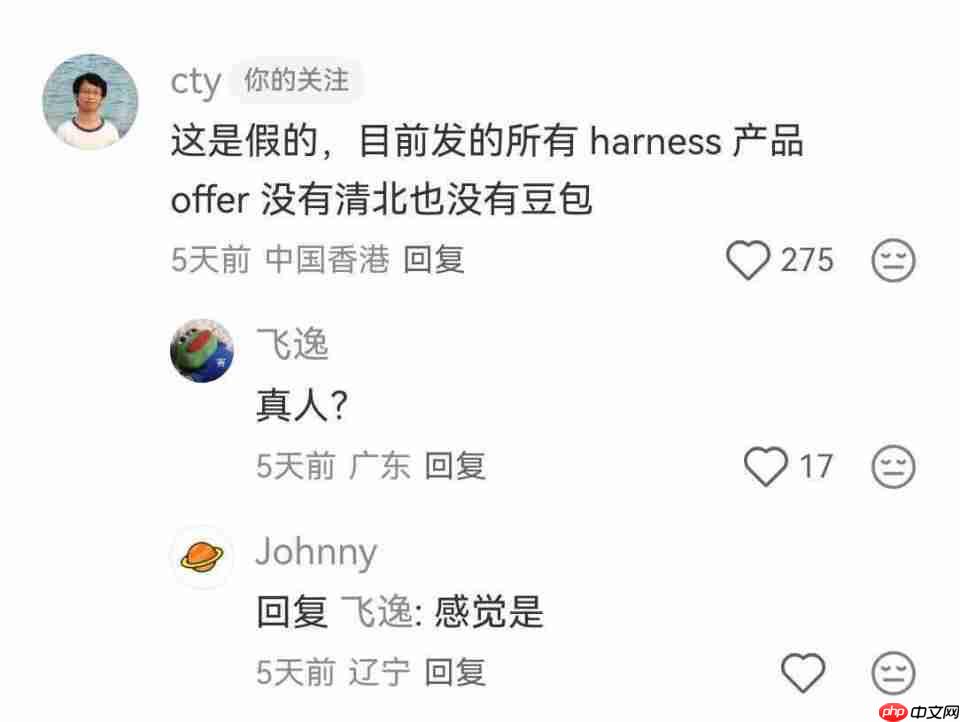
图为 崔添翼在小红书回应关于“招聘门槛卡清华学历+豆包从业经历”的网友提问
此前,DeepSeek始终保持着极简低调的技术团队形象,背后依托的是梁文锋创办的量化私募机构“幻方量化”。后者2025年实现年化收益56.55%,管理资产超700亿元,长期为DeepSeek提供稳定资金支持。
外界普遍认为,DeepSeek“并不缺钱”。
而促使梁文锋转变态度的关键动因,或源于核心人才流动加剧与行业抢人大战白热化。
作为对标样本,“大模型第一股”智谱AI截至6月30日市值已逼近万亿港元;MiniMax估值亦突破1300亿港元。
相较之下,DeepSeek员工手中的期权尚未获得市场化定价锚点——公司未融资、未上市、缺乏外部估值参照系。
“不融资,估值就无法提升;期权没有兑现路径,自然难以留住人。智谱、MiniMax这些同行,要么估值翻倍,要么上市后股价飙升,DeepSeek的骨干怎么可能不动心?”一位长期关注该公司的资深业内人士分析称。
人才维稳本身即是一笔高昂成本。
2025年,DeepSeek最核心的竞争壁垒,仍来自一支百余人规模、清北复交及海外名校背景密集的“高密度智力团队”。数十位顶尖AI研究员,叠加一位极具技术理想主义气质的创始人梁文锋,共同孕育出DeepSeek-R1这一里程碑式模型。
而今,一面是互联网大厂持续以高薪争夺顶级AI科学家,另一面是市场对AI人才需求井喷——公开数据显示,算法岗月薪中位数已普遍突破2.4万元,头部人才月薪逾5万元,AI人才溢价仍在持续扩大。
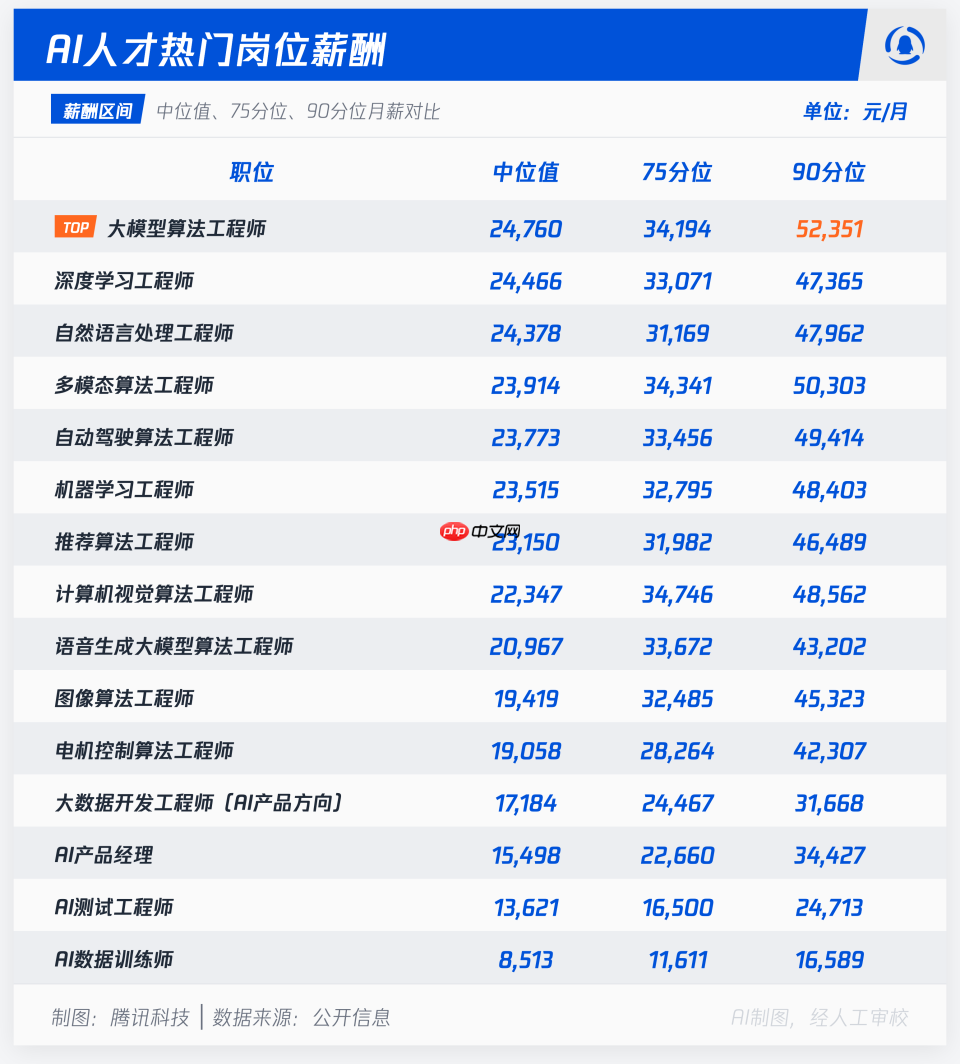
前程无忧《2026届校招市场AI人才需求报告》
本次招聘中,除全栈开发、算法、AI系统研发、运维、产品等技术类岗位外,HR、法务、财务、采购、行政等职能序列同步扩编,释放出明确信号:DeepSeek正系统性补足科技企业的组织基建能力。
从“产品驱动”迈向“组织驱动”,是多数技术型公司成长的必经阶段——唯有当组织结构趋于成熟、平台支撑日益完善、激励机制逐步健全,规模化的产品势能才真正开始释放。
500亿融资,既是对抗人才流失的现实所需,也为组织升级提供了底层资金保障。但随之而来的问题是:在快速扩张过程中,DeepSeek能否维持原有“小而精”的作战风格?能否在人员规模上升的同时,依旧保持决策链条短、响应速度快、执行效率高的敏捷特质?这是其“下半场”必须直面的第一道考题。
02 DeepSeek迈入重资产周期
在6月25日发布的33个岗位中,一批IDC(Internet Data Center,互联网数据中心)相关职位尤为值得关注,涉及数据中心基础设施建设全链条。
早在4月中旬,DeepSeek已在内蒙古乌兰察布启动首批IDC岗位招聘,包括数据中心高级运维工程师、数据中心高级交付经理;至6月,又新增“IDC设计规划工程师”一职。
从运维交付,到规划设计,DeepSeek的人才布局已由模型层延伸至底层算力基建。
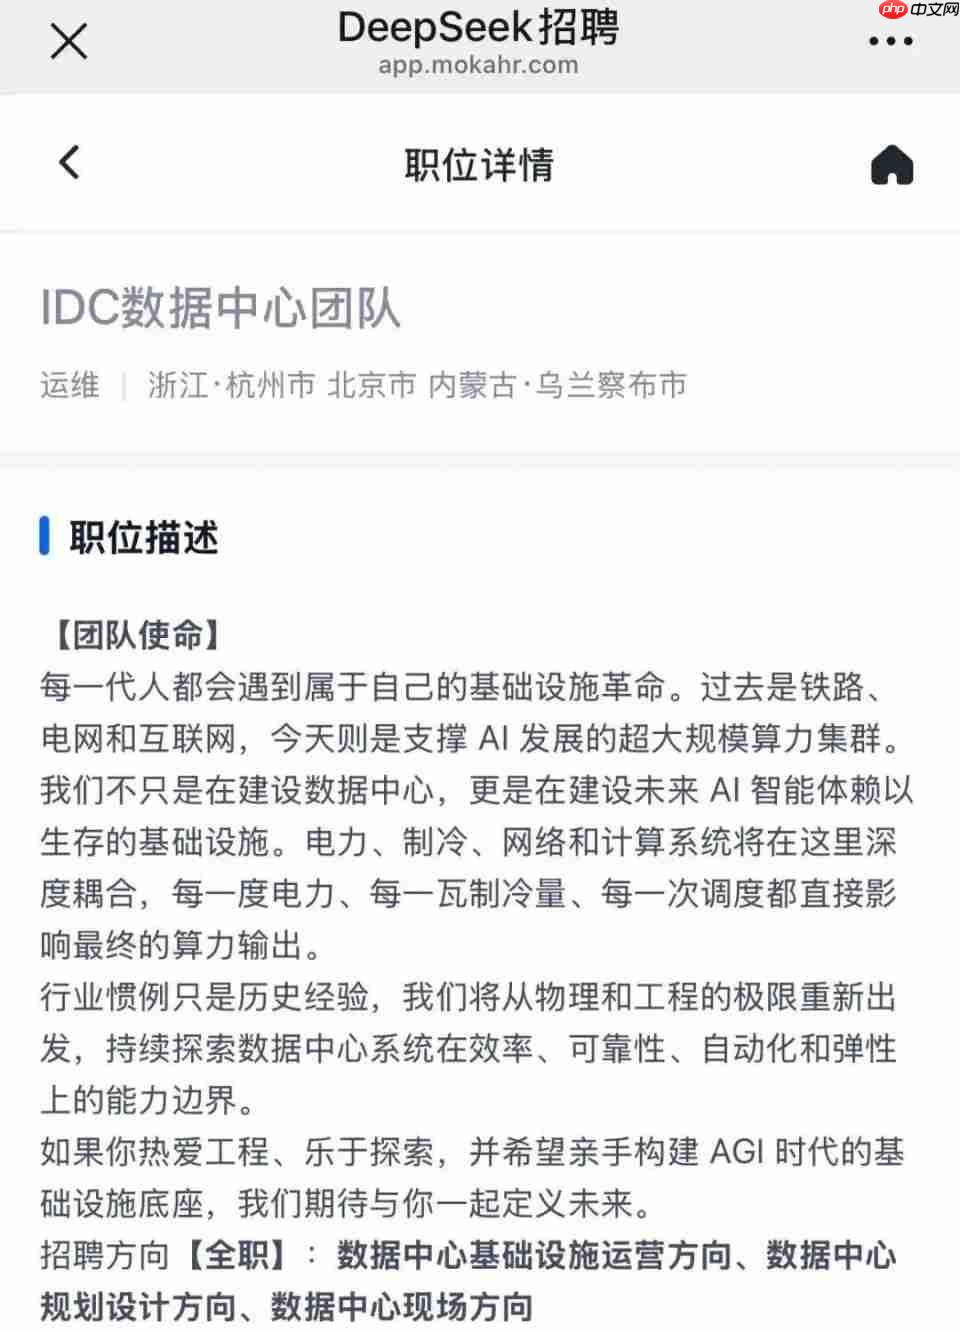
图为 DeepSeek IDC数据中心团队招聘岗位信息

随着大模型进入规模化训练与高频推理阶段,AI企业的竞争正加速向“硬实力”迁移——算力基础设施已成为决定长期竞争力的关键战场。DeepSeek不得不与硅谷一线大模型公司同步,投身自建算力集群这一典型的重资产投入赛道。
据公开统计,Alphabet、亚马逊、Meta与微软四家美国科技巨头,预计2025年将在AI基础设施领域合计投入约6500亿美元。Anthropic与OpenAI也在多份财报中明确表示,将持续加码数据中心与GPU集群建设。
例如,Anthropic已披露将向SpaceX租赁数据中心容量,每月支出约12.5亿美元,年支出达150亿美元,尚不包含GPU采购、网络搭建及日常运维等其他成本。
工信部信息通信经济专家委员会委员盘和林曾指出:“当前AI投资热潮下,大模型企业融资已是行业共识。不仅是DeepSeek,谷歌近期也完成800亿美元融资,整个赛道已整体迈入重资本投入期。”
要在算力基建竞赛中不掉队,DeepSeek必须实现资金端“开源”,通过融资获取长期弹药,进而支撑算力中心、超算集群等重资产建设。
值得注意的是,DeepSeek的算力建设,是在全球先进芯片出口管制持续收紧背景下展开的——这意味着其算力底座将高度依赖国产芯片。事实上,在V4官宣页面及配套技术文档中,DeepSeek已多次提及对国产算力适配的深度探索。
5月底,华为提出“韬(τ)定律”,旨在通过器件、芯片、系统全栈协同优化,突破摩尔定律放缓带来的性能瓶颈;国内大模型厂商亦正加快适配国产硬件生态,目标直指“自主可控的AI基础设施”。
03 AGI黎明将至
对DeepSeek这类底层模型公司而言,单靠资本与组织建设远不足以构筑长期护城河,真正的胜负手在于持续输出原创性技术成果。
一位资深算力行业人士指出:“本轮融资的核心目的,就是强化人才绑定与团队激励——只有充足的资金保障,才能支撑更大规模、更高频次的模型训练,从而稳固头部地位。”
论文,正是DeepSeek技术演进脉络的重要见证。
据不完全统计,过去两年间,DeepSeek累计对外发布核心技术论文约27篇,研究覆盖MoE(混合专家)、强化学习、代码大模型、数学推理、多模态等多个前沿方向,与其每一代主力模型的技术跃迁基本同步。
就在6月27日,DeepSeek在GitHub低调更新一篇关于“DSpark”的新论文。
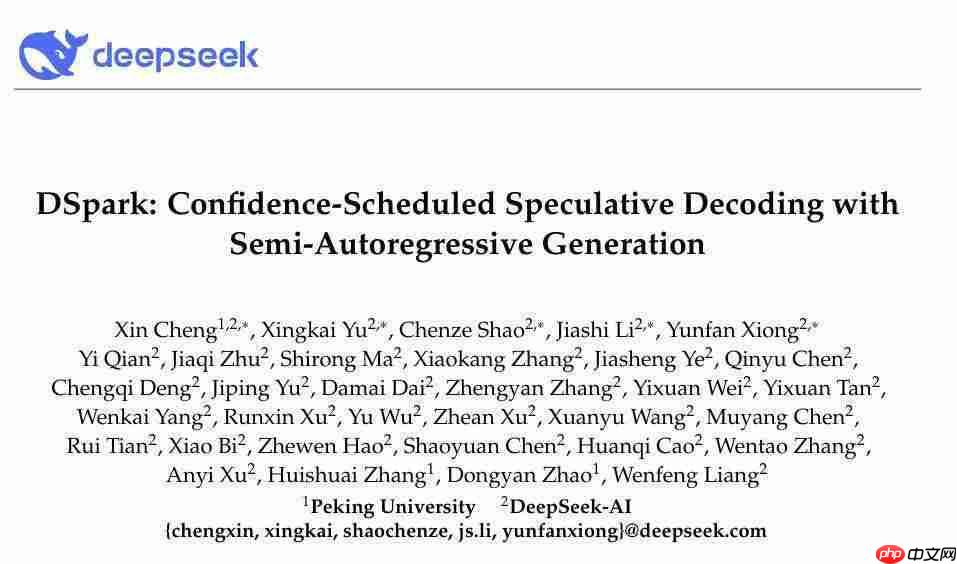
该论文提出全新推理加速框架“DSpark”,在不牺牲模型能力的前提下,显著提升生成速度与系统吞吐量。
与以往不同,此次并非模型架构迭代,而是基于现有DeepSeek-V4-Pro与V4-Flash模型,新增一套推测解码模块,聚焦工程落地层面的效能优化。
DeepSeek计划将DSpark直接部署于V4线上服务系统,在承接真实用户请求过程中,大幅削减冗余校验带来的算力损耗。
论文明确指出:“在不改动底层模型结构的前提下,文本生成速度提升60%–85%。”对于日均处理海量API调用的AI服务商而言,每一分算力节省,都意味着实打实的成本下降与利润空间拓展。
据VentureBeat今年2月报道,大模型训练成本正呈指数级攀升。Anthropic CEO Dario Amodei预测,下一代前沿模型的单次训练费用或将高达50亿至100亿美元。
上述业内人士坦言:“DeepSeek迟早也将步入这一‘烧钱’周期,融资只是时间问题。”
更多媒体观察到,融资落地仅十余天即发布新论文,DeepSeek意在传递一个关键信号:研发节奏未受干扰,团队依然维持高强度、高质量的技术输出。
无论是推出V4新模型、构建自有数据中心,还是从“天才实验室”转型为商业化AI公司,DeepSeek所有动作的终极指向,都是AGI(通用人工智能)。
2024年接受《暗涌Waves》专访时,梁文锋曾斩钉截铁表示:“我们做的就是AGI。语言大模型,不过是通往AGI的必经之路。”
在免费阶段,用户对响应失败、对话中断、API限流等问题尚有容忍度;但7月V4正式商用后,稳定性将成为硬指标——若问题反复出现,将直接影响开发者是否愿意将其接入生产环境与核心业务流程。
进入付费市场、开发者生态与企业级场景,DeepSeek的工程交付能力将面临前所未有的严苛检验。模型能否真正落地千行百业,亦是迈向AGI时代不可绕过的门槛。
当全社会期待DeepSeek推动中国大模型降本增效时,它自身也在精密计算:正处于AGI攻坚窗口期,首要任务是稳住核心团队,其次要保障模型持续迭代、技术持续突破,同时,数据中心这场“硬仗”也绝不能输。
单靠幻方量化这一单一资金来源,显然已难以为继。
2026年启动融资,已是DeepSeek的战略必然。正如其6月25日晚招聘启事开篇所写:
“人类正站在AGI的前夜。”
接下来,DeepSeek将正式踏入更漫长、更昂贵、更不确定的AGI长跑。能否延续“大模型时代”的领先身位,在AGI赛道继续领跑?这是其“下半场”必须回应的第二道命题。
本文源自“腾讯科技”,作者:谢瑞瑞,编辑:徐青阳,36氪经授权发布。

















