过去一年间,月之暗面kimi(后文简称“kimi”)实现了从“ai六小虎”之一到全球资本竞相追逐焦点的跨越式跃升。
2025年12月,Kimi顺利完成5亿美元C轮融资,投后估值达43亿美元;今年5月,再获20亿美元D轮融资,估值飙升至200亿美元;6月,市场传出消息,Kimi正推进新一轮最高达20亿美元的融资洽谈,投前估值已攀升至300亿美元。
技术演进方面,2026年1月发布的Kimi K2.5成为关键分水岭。这款原生支持全模态处理的旗舰模型上线不足一个月,其20天累计收入即超越2025年全年总收入,ARR(年度经常性收入)一举突破2亿美元大关。
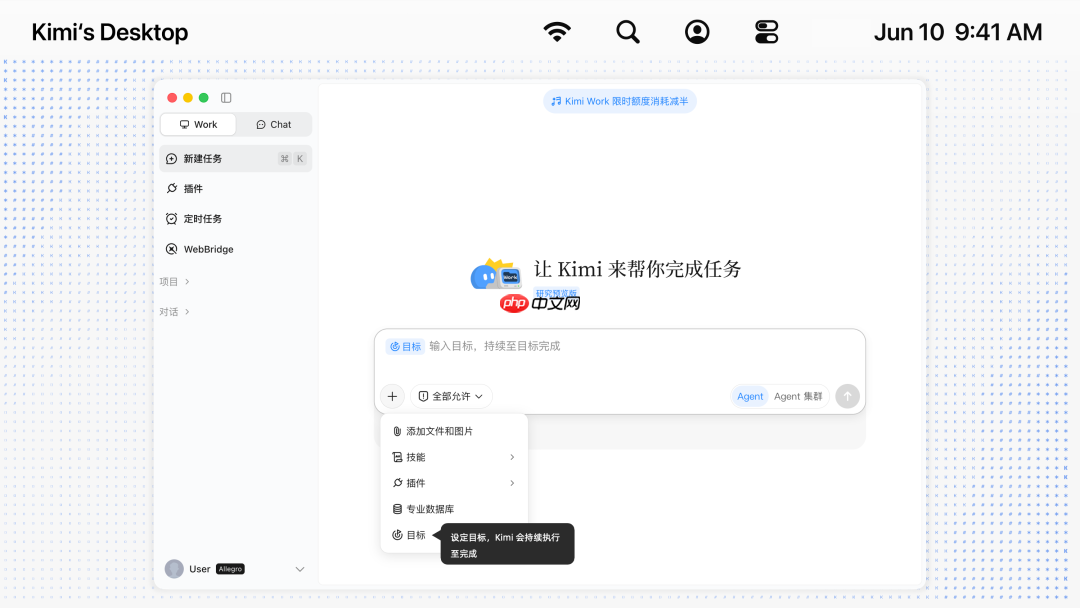
此后,Kimi的产品迭代节奏持续提速:2026年4月推出Kimi K2.6,聚焦编程能力与Agent集群协同,单次任务最多可调度300个专业化子代理并行执行;6月中旬,正式发布面向桌面端的本地通用Agent产品Kimi Work,并同步推出专精编程场景的K2.7 Code模型。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
据透露,Kimi K2.7 Code在多项基准测试中相较前代实现显著跃升。在长程任务中,K2.7平均Token消耗降低30%;多语言代码生成质量亦获得大幅增强。
“编程能力是AI释放生产力的起点——从Token消耗维度看,编程任务占比高达90%。但这仅是AI被广泛采纳的第一步,通用Agent所驱动的生产力革命,将从3000万程序员延伸至覆盖10亿知识工作者的广阔图景。”Kimi创始人杨植麟指出。
在他看来,大模型所开启的技术疆域远未见顶。“大模型研发正经历范式级转变,预计2026年下半年至2027年,AI将在科研层面扮演越来越核心的主导角色。”
01
高远的技术抱负
回溯2025年初,DeepSeek强势崛起,一度打乱Kimi原有研发节奏。而同年7月问世的全球首个万亿参数开源MoE模型Kimi K2,则重新向业界展示了杨植麟深厚的技术积淀与战略定力。
Kimi K2发布后,一位内部研究员在技术博客中写道:“年初的复盘会上,我提出了一些颇为激进的方向建议,没想到植麟后续的落地动作比我的设想更为彻底——比如果断终止K1系列迭代,集中全部资源攻坚基础算法与K2研发。”
多位接近Kimi的消息人士向《中国企业家》证实,K2诞生于公司发展的关键节点,杨植麟力主放弃K1、全力押注K2的决策,对Kimi整体技术走向具有决定性意义。
而多模态模型K2.5的亮相,则标志着Kimi技术路径完成重要升级。其原生多模态架构首次在底层实现文本与视觉输入的深度融合;Agent集群支持百级子Agent并发协作,单任务最大可调用1500个步骤。这款参数规模达1万亿的模型上线后迅速引发抢购潮,直接助推Kimi ARR突破1亿美元。
4月,K2.6将Agent集群容量扩展至300子Agent,协调执行步骤上限提升至4000步,编程能力实现质的飞跃——在SWE-Bench Pro评测中以58.6%准确率力压GPT-5.4;可持续编码时长达13小时,单次修改代码超4000行;6月发布的K2.7 Code则进一步深耕垂直领域,在推理Token消耗上降低30%,Kimi Code Bench V2得分提升21.8%,多语言代码生成能力全面优化。
半年三度迭代,Kimi的产品逻辑日益明晰:先以架构创新拓展能力边界,再通过To B场景深度打磨,逼近专业应用的精度极限。
据Kimi算法团队分享,支撑高频迭代的核心突破在于——视觉强化学习训练反哺纯文本能力。杨植麟将其称为“颠覆行业既有认知的关键发现”。“此前普遍认为引入视觉模态会削弱文本理解能力,但我们验证了二者存在正向协同效应。”
在杨植麟看来,过去十年间,Transformer架构、Adam优化器、残差连接等技术组件构筑了深度学习的底层基石,曾被视为不可动摇的行业共识。然而,随着模型规模持续膨胀、任务复杂度不断攀升,这些曾被奉为圭臬的“标配”,正逐渐演变为制约模型进化的隐性瓶颈。
因此,Kimi的技术路径展现出鲜明特质——直击底层重构,不止于工程微调,而是回归AI系统最基础模块,逐项攻坚:从优化器、注意力机制到残差连接,逐一重写、深度提效,以算法革新换取智能上限的实质性跃迁。
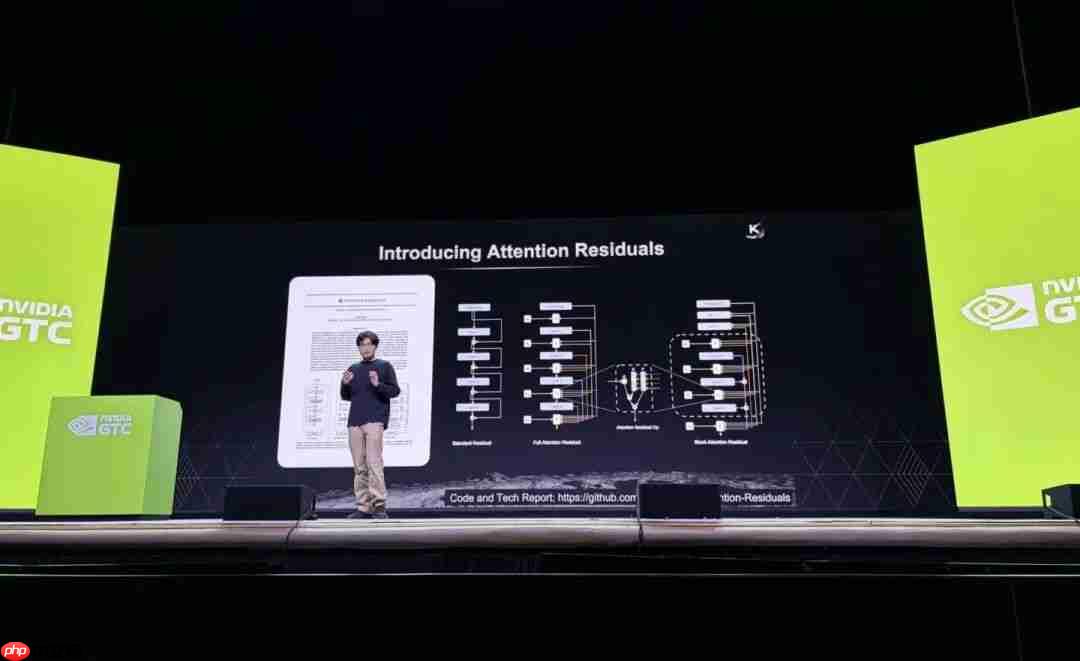
例如,K2采用的MuonClip优化器,使Token处理效率达到AdamW的2倍;Kimi Linear混合线性注意力架构,在128K至1M超长上下文中实现5–6倍解码加速;K2独创的Attention Residuals技术,则对神经网络核心残差结构进行全新设计,在保持性能相近前提下,训练计算量减少约20%,相当于获得1.25倍效率增益。
“MuonClip、Kimi Linear、Attention Residuals的本质目标高度一致——效率。我们通过算法原创,最大化释放现有算力价值,从而推动Token效率与模型智能水平双升。”一位Kimi算法研究员表示。
面向下一代模型K3,杨植麟明确表示:新架构将重点强化Agent长程任务能力,因其是当前最关键的智能维度。
“未来Kimi将持续深耕底层技术重构,大量基础组件将在未来2–3年内迎来系统性重写。我们期待K3不仅是一次升级,更是一种定义——带来前所未有的体验,呈现其他模型尚未构想过的全新能力。”杨植麟说。
02
审慎的组织成长
与技术上的锐意进取形成强烈反差的是,Kimi在组织扩张上始终保持高度克制。

通过 NVIDIA NIM API 调用 Kimi K2.5 视觉模型分析图像,非常适合为 MiniMax M2.5、GLM-5 等非视觉模型赋予视觉能力。
内部运营中,Kimi坚持灵活高效的“小团队”作战模式。作为估值逾300亿美元的独角兽企业,其员工总数仅约300人,堪称国内头部大模型创业公司中规模最小的一支。
“精兵简政”正是杨植麟主动选择的发展策略。他公开强调:“在几家主流大模型创业公司中,我们始终维持最少人数,同时确保‘卡’与‘人’的比例最高——这对保障创新活力至关重要。我们无意盲目扩编,规模失控可能对创新构成致命打击。”
《中国企业家》了解到,Kimi内部不设OKR考核体系,无部门壁垒,甚至没有传统意义上的职能部门划分;总监、副总裁等职级标签已被彻底取消。整个组织架构极度扁平化,几位联合创始人直接对接数十位一线成员。杨植麟的微信签名仅有四字:直接沟通。
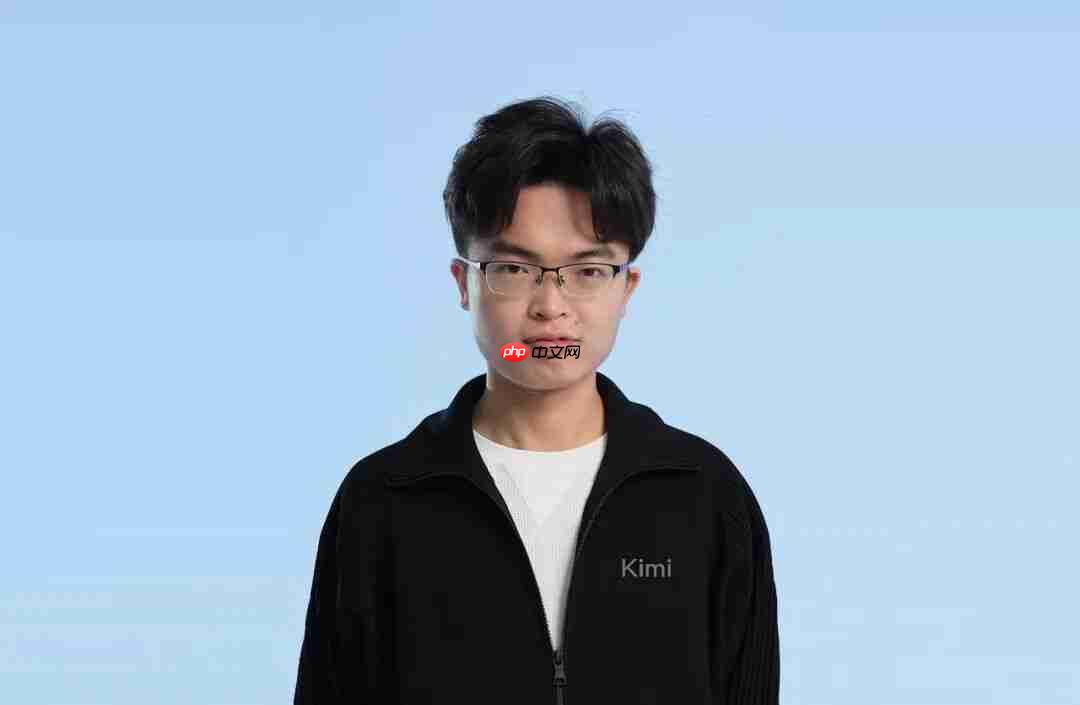
Kimi创始人杨植麟
多位接近Kimi的人士向《中国企业家》透露,杨植麟在谈及模型设计时,反复强调一个关键词——“品味”(taste)。当算力与数据日趋同质化,这种对技术路径的审美判断与价值取舍,正成为Kimi构建差异化护城河的核心引擎。
总裁张予彤如此诠释Kimi的人才标准:“我们青睐具备抽象思维能力、略带偏执气质、且执行力极强的人——当你有一个好想法,是否愿意为它尝试1000次?多数人试到第10次就放弃,但Kimi需要的是那些坚信自己判断,并在反复实践中不断校准认知的极少数人。”
“Kimi创立初期便汇聚了一批AI核心技术的原创者,他们又持续吸引志同道合的同行加入。”在杨植麟看来,技术仍是大模型竞争中最根本的变量,而Kimi对顶尖技术人才的吸引力,正是其长期竞争力的根基所在。
03
拒绝标签的LLM
2025年12月底,当MiniMax、智谱等竞对陆续敲定IPO进程时,资本市场目光再度聚焦Kimi。杨植麟对此态度淡然,他在全员邮件中明确表态:公司现金流充沛,上市并非当下优先事项。
但大模型赛道风云激荡,玩家数量正加速收敛。
2026年5月7日与8日两天内,中国大模型领域在48小时内密集披露超百亿美元融资进展。媒体评价称:“资本并非涌入行业,而是加速向最后几家头部玩家聚拢。”Kimi虽已验证技术实力,但商业变现能力仍需持续兑现。
K2.5发布后的3月,Kimi ARR迈过1亿美元门槛;4月,该数字翻倍至2亿美元。“很长一段时间里,K2.5处于严重供不应求状态。”接近Kimi的消息人士告诉《中国企业家》。
6月12日,Kimi正式推出桌面端AI Agent产品Kimi Work,支持300个Agent并发运行,并内置Cron调度器;产品还实现金融数据直连能力,Agent可直接读写本地文件,所有操作均在设备端完成,数据全程不出本地。
在加快商业化落地的同时,算力布局、人才储备、资源调配,以及与互联网巨头之间的竞合关系,也正等待Kimi交出答案。
杨植麟的态度始终如一。“我们并非为竞争而生。”他在早期一次采访中直言。2025年底,他进一步阐释:“行业发展已进入新阶段——从最初百花齐放,到如今强者恒强,未来各家所走的路,将愈发不同。”
开源生态中的技术流动,也为这种“和而不同”的格局提供了生动注脚。DeepSeek发布V4模型时,其技术报告中特别致谢Kimi开源的Muon优化器。杨植麟对此回应平静而坦然:“这正是开源的价值所在——我们受益于社区,也愿将成果回馈社区。”
未来的Kimi将走向何方?杨植麟在2025年底的内部信中,言语坚定、气韵独特,既饱含技术自信,亦透出不可复制的“taste”。
“2026年,Kimi将成为一个‘与众不同’且‘不被定义’的LLM。无论是在他人尚未涉足的技术无人区,还是需要一点偏执坚守的审美判断,我们都相信,更多由Kimi定义的创新,终将为人类文明的加速演进贡献不可替代的独特价值。这份独特性,正是我们存在的终极意义。”
本文来自微信公众号 “中国企业家杂志”(ID:iceo-com-cn),作者:孙欣,36氪经授权发布。