


昨日,火山引擎正式推出豆包音频生成模型1.0(doubao-seed-audio 1.0),具备以文本或音频任一模态为输入、端到端输出完整音频内容的能力。该模型的关键创新在于:仅需一条prompt,即可同步生成对白、音效与背景音乐等全部音频要素,全面取代传统依赖人工多轨剪辑的制作流程。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
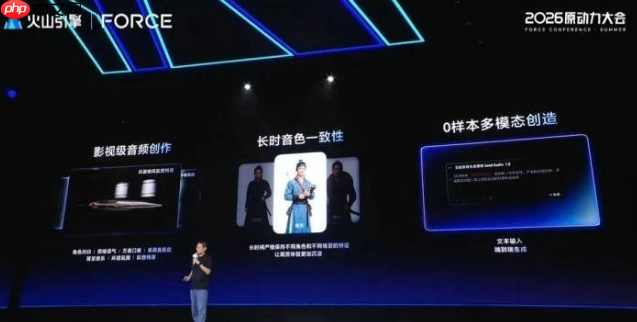
一句话化身“音频导演”,全程免后期
以往,要产出专业级音频成品,往往需分别生成对白、音效与配乐,再手动对齐时间轴、逐轨混音,操作复杂且高度依赖剪辑经验。而豆包音频生成模型1.0将整套流程浓缩至单条指令中:用户可在同一Prompt里明确设定多个角色的台词内容、语气倾向、情绪起伏与节奏变化,精准嵌入笑声、呼吸、停顿、方言口音等细微表现;与此同时,背景音乐与环境音效亦同步生成,输出即为可直接发布的成品音频。创作者只需输入一段文字描述,便可即时获得可用于上线的有声剧、播客节目或品牌宣传音频。
长音频不“跳戏”,角色声线始终如一

立即进入“豆包AI人工智官网入口”;
立即学习“豆包AI人工智能在线问答入口”;
在长时音频创作中,最棘手的挑战之一便是声音一致性——角色在开头与结尾是否听感统一?豆包音频生成模型1.0通过文生音频与参考音频的深度融合,在长段落中实现音色高度稳定,创作者无需反复校验、逐段调音。当前版本单次支持最长2分钟音频生成,并可通过连续延展机制保障长程输出中的音色连贯性,充分适配有声书、深度播客及系列广播剧等应用场景。
值得一提的是,模型还实现了音色与表达风格的解耦调控:同一音色可灵活适配喜怒哀惧等多种情绪状态与语境设定,甚至支持“一声分饰多角”——让同一个基础声线,在不同角色身份下展现出差异化演绎能力,大幅增强角色配音与创意音频内容的生产弹性。目前,火山方舟平台已启动API内测招募,个人用户可在体验中心领取每月30分钟的免费创作额度;豆包音频生成模型1.0也将陆续集成至剪映、即梦、番茄等旗下产品中。











