





日本搞了个对标Fable 5的AI模型,但我觉得有点扯
这家名叫 Sakana AI 的公司发布了名为 Sakana Fugu 系列编排器模型,某种程度上说,这个 Fugu 都不能称之为模型,而是一个分发器。
因为这个 Fugu 本身并不是大模型基座,而是根据不同任务类型去调用其他模型能力。
比如,用户发出一个编程任务,Fugu 去调用 Claude Opus 4.8;用户发出一个数学任务,Fugu 去调用 GPT-5.5。
当然,实际的执行过程肯定比我说的更复杂,但核心逻辑大致如此。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
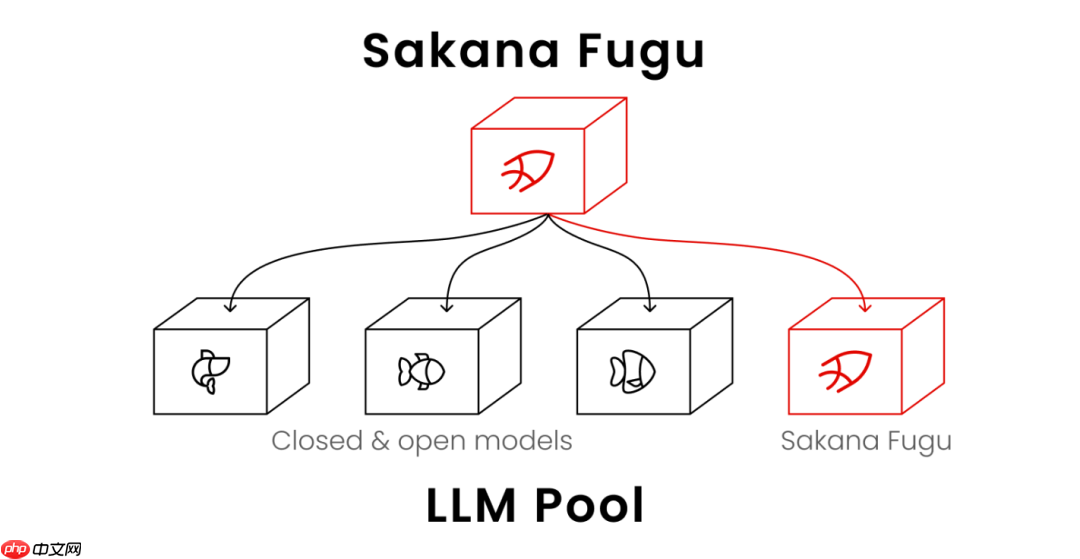
所以,Fugu 自己其实并不生成模型能力,它只是模型能力的整合调度者——说白了,是“AI界的物流中转站”。
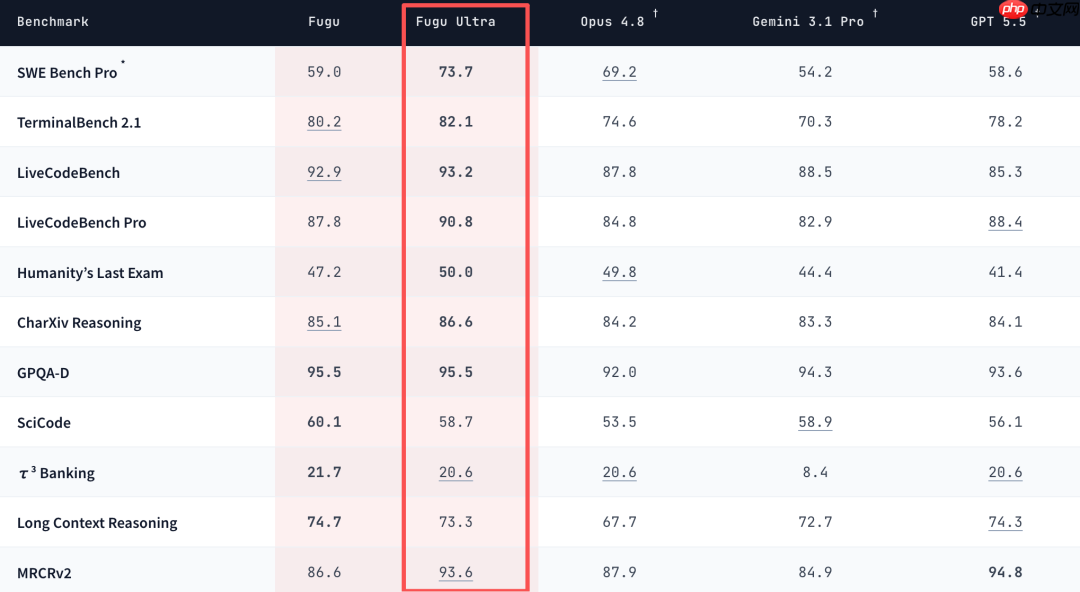
在这种技术架构下,他们还与包括 Opus 4.8 和 GPT-5.5 在内的多个主流模型进行了联合跑分测试。
从结果看,Fugu Ultra 在多项指标中均优于 Claude Opus 4.8。
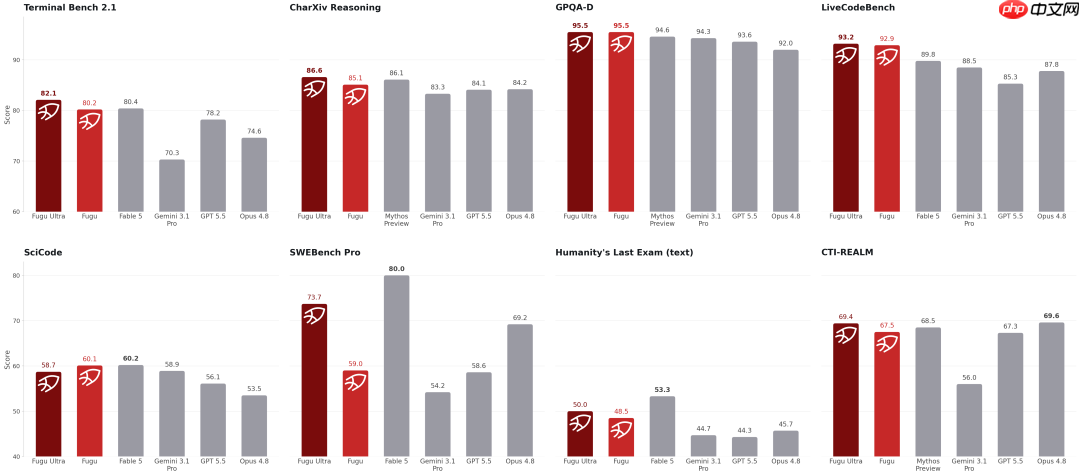
更值得注意的是,Fugu Ultra 在工程、科学和推理类基准测试中,性能已逼近甚至部分超越当前公认的顶尖模型——Fable 5 与 Mythos Preview。
看到这里我忍不住想:这不就是把“调度能力”包装成“模型能力”吗?
明明底层能力全靠外挂,却在榜单上宣称自己“超越对手”——面子撑得足,里子却是借来的。
当然,这并不意味着它没价值。卖水者也要有水厂的运营思维。在我看来,Fugu 的真正壁垒在于其任务识别、语义拆解与动态路由能力。
如今各大模型虽强,但专精各异:Claude 擅长逻辑推演,GPT 精于通用理解,Gemini 强在多模态,而 CodeLlama 在编程任务中常有奇效。
没有一个模型能通吃所有场景,而 Fugu 正是瞄准了这一现实缺口——它像一位资深项目经理,接到需求后先做WBS分解,再按模块分包给最合适的“外包团队”。
它会判断用户输入属于科研、编码、数学推理还是跨模态任务,并据此决定是否启用视觉、语音或代码专用模型;
甚至在同一问题内部,也能将子任务分流至不同模型协同处理——比如先让 GPT-5.5 解析题干,再交由 Claude Opus 4.8 进行严谨推导,最后由 Gemini 完成可视化呈现。
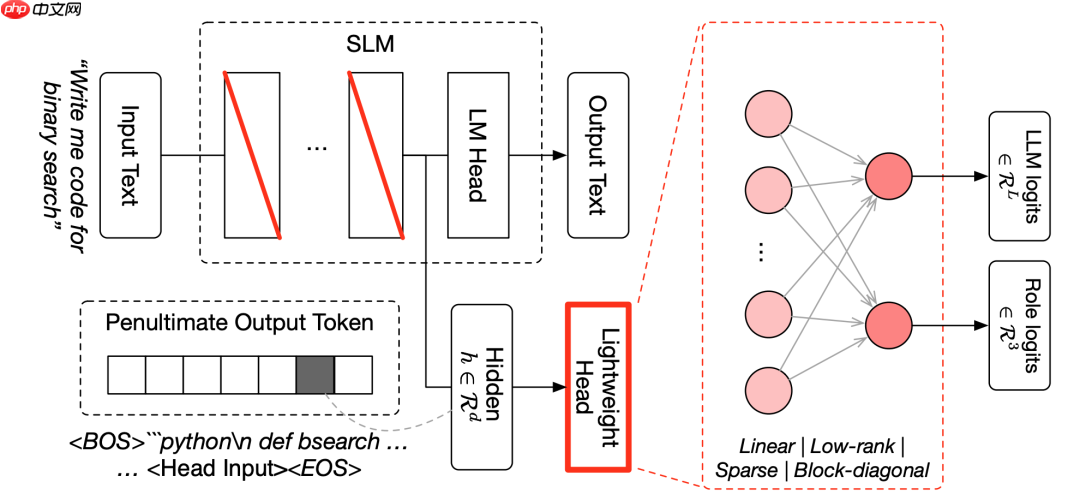

这种“集众智、避短板”的协同范式,正是它能在测评中脱颖而出的关键。本质上,Fugu 不是模型,而是模型集群的操作系统。
价格方面,Fugu Ultra 的输入成本为每百万 token 5 美元,输出则高达 30 美元;若上下文长度突破 272k,费用还将阶梯式上浮。
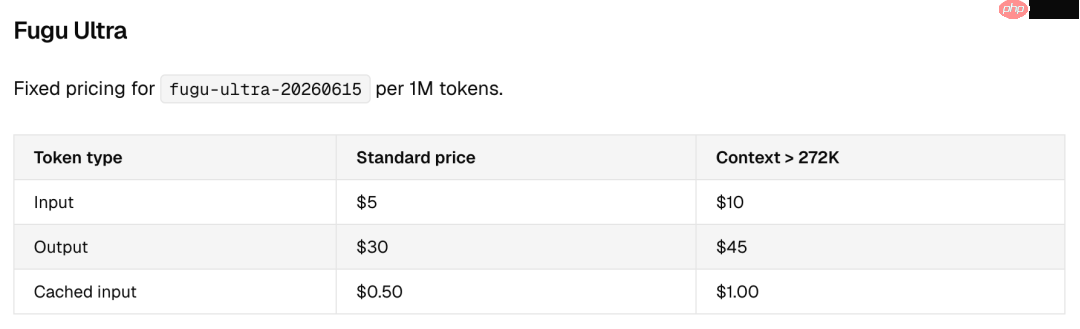
目前仅支持 API 接入,配套提供专属密钥与标准化开发文档。
今天聊这个案例,其实是想点破一个趋势:AI 竞争的主战场正在迁移——
过去拼的是“谁家模型更大、参数更多、训练更久”,未来比的将是“谁能更懂场景、更准识别需求、更快完成适配”。
模型能力的边际收益正在收窄,而应用层的创新空间才刚刚打开。
Fugu 就是个典型样本:它没重造轮子,却重新定义了轮子怎么用。有点像当年的导航App——地图数据来自高德、百度、四维图新,但它用路径规划算法把碎片能力串成了完整服务。
虽然我个人对其长期生态位持保留态度(毕竟入口一旦做大,上游模型厂商未必乐见“中间商赚差价”),但它的方法论极具启发性:
好产品不等于新技术,而是把已有技术精准嵌入真实问题的毛细血管里。
识别信号,比实现方案更难;
看见需求,比满足需求更重要。
AI浪潮奔涌而来,但越是在自动化泛滥的时代,那些擅长定义问题、权衡取舍、连接技术与人性的产品经理,反而愈发不可替代。
当机器负责执行,人更要守住判断——这才是真正的护城河。
最后顺手查了下,“Fugu”在日语中意为河豚。
看来小日子不仅想做调度中枢,还想当那条身怀剧毒却鲜美无匹的终极食材——
一鱼吞百味,一口定乾坤。
本文来自微信公众号 “唐韧”(ID:RyanTang007),作者:唐韧,36氪经授权发布。














