


提示词质量决定AI代码评审效果:需明确目标、提供完整代码与上下文、指定检查项与禁令、强制结构化输出。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
在Cursor中做代码评审时,提示词质量直接决定AI反馈的准确性与实用性,写得模糊会导致AI泛泛而谈、忽略关键缺陷,写得太宽泛则容易漏掉边界条件或安全漏洞。
明确评审目标和上下文
第一步:在提示词开头用一句话锁定本次评审的核心目标。例如“请重点检查这段HTTP路由处理逻辑是否存在未校验的用户输入导致的路径遍历风险”,而不是“请评审这段代码”。目标越具体,AI越不容易跑偏。
第二步:粘贴完整可运行的代码块,不要截断函数头或缺失依赖声明。如果涉及多个文件,用注释标明文件路径,比如// auth/middleware.go,否则AI会误判作用域。
第三步:补充必要上下文——当前框架版本(如Gin v1.9.1)、部署环境(如运行在Docker容器内且无SELinux)、已知约束(如“该服务禁止使用第三方日志库”)。缺少这些,AI可能推荐不兼容的修复方式。
指定评审维度和禁止行为
方法一:用短句罗列必须检查的项,每项独占一行,用破折号引导:
– 检查所有从query、form、path提取的参数是否经过白名单校验
– 确认error返回前是否已记录trace ID
– 验证数据库查询是否使用参数化语句,禁止字符串拼接SQL
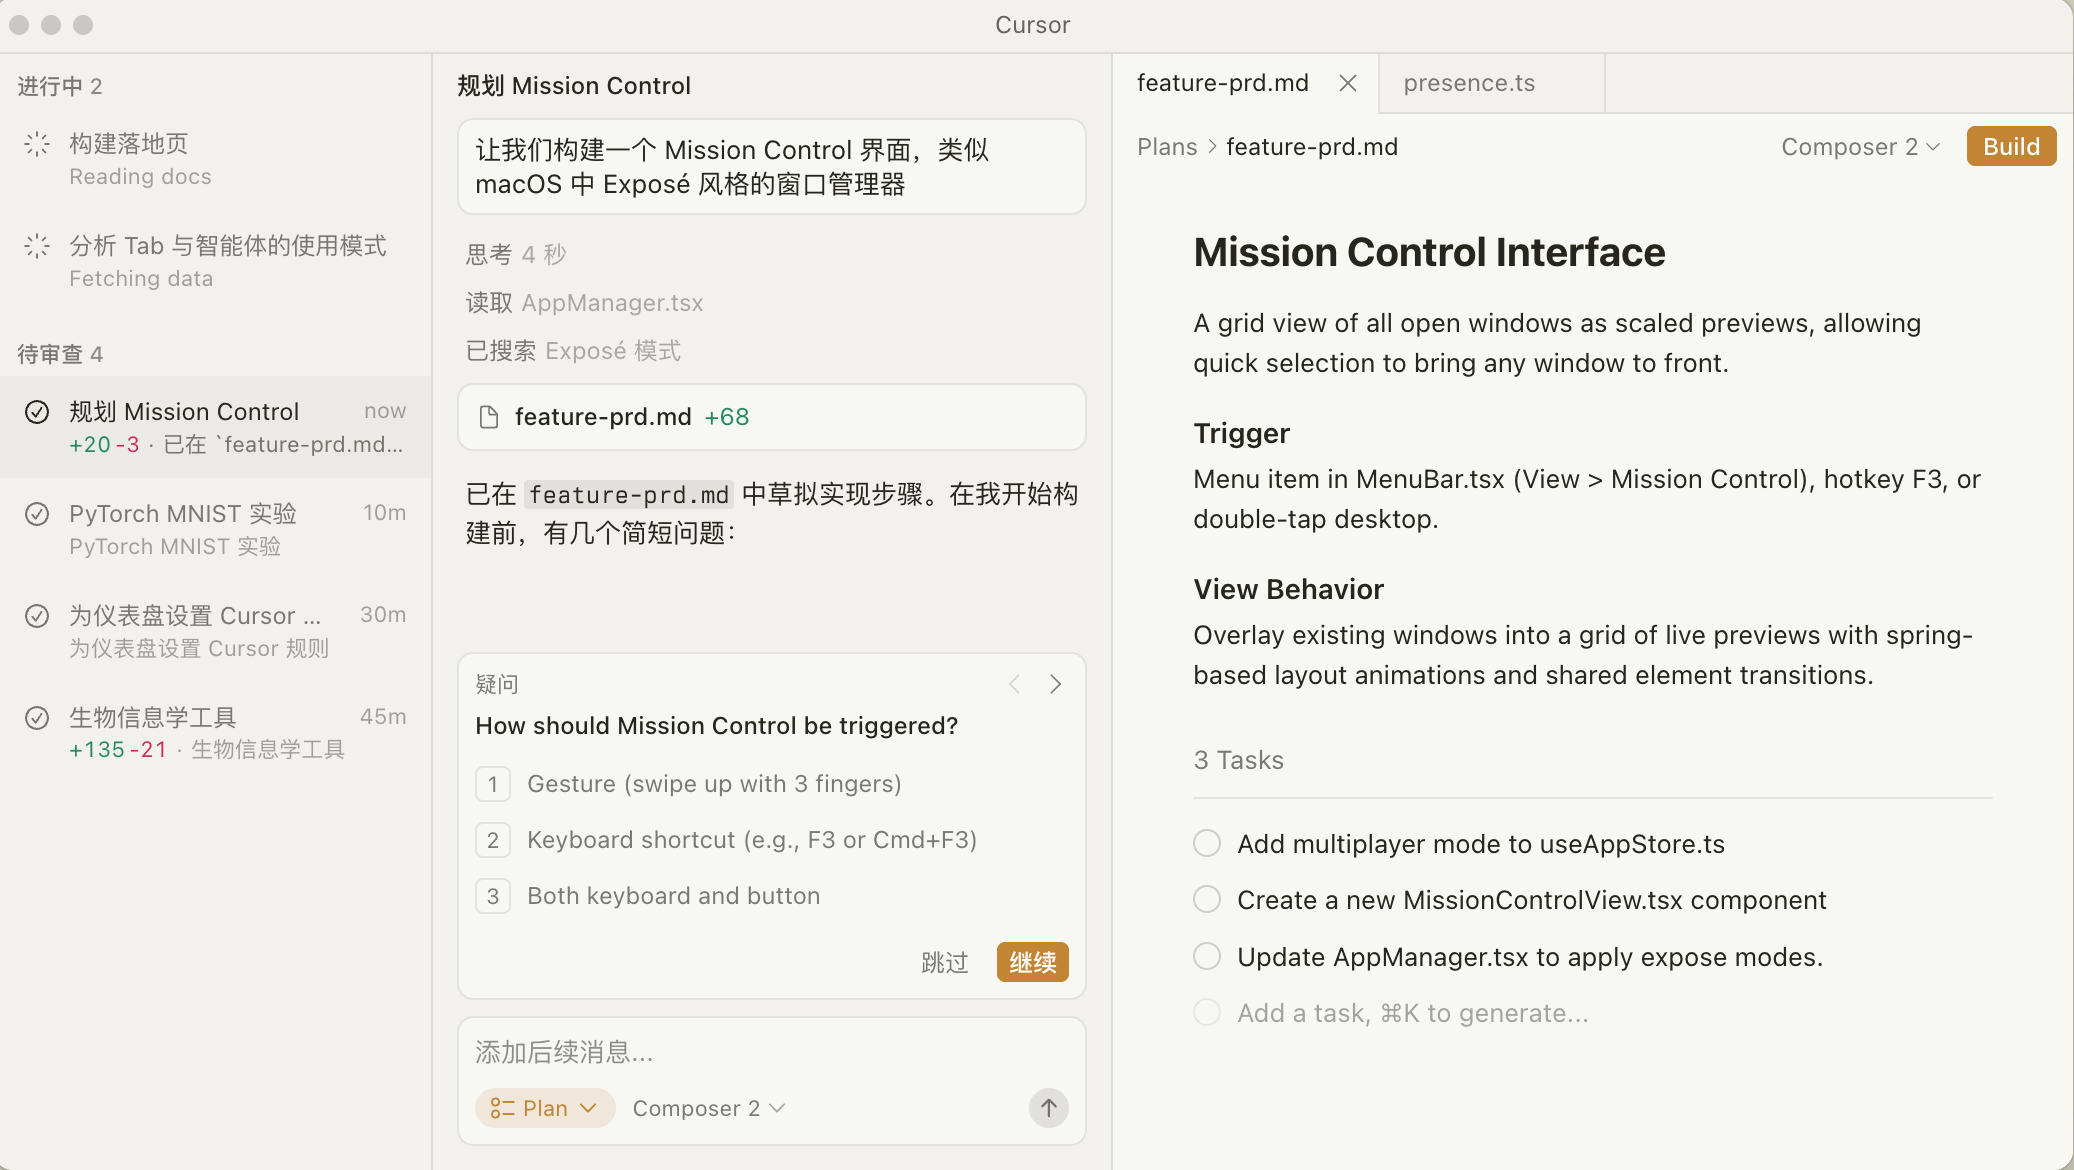
Agents 正在你的整个代码库中处理越来越复杂、运行时间更长的任务。本次版本引入了新的 agent 框架改进,以实现更好的上下文管理,并在编辑器和 CLI 中带来了许多提升使用体验的修复。
方法二:明确禁用AI的自由发挥。加上这句话:“【不许推测未出现的业务规则,不许建议重构整个模块,只基于所给代码指出可验证的问题】”。否则AI常会跳出上下文,虚构需求或过度设计。
要求输出格式严格可控
在提示词末尾强制约定输出结构:“请按以下顺序输出:① 问题行号;② 原始代码片段(最多3行);③ 风险类型(如‘XSS’‘竞态’‘空指针’);④ 修复建议(给出可直接粘贴的代码补丁,含import变更)”。
这一步不能省——默认输出往往混杂描述性文字和建议,无法被开发直接定位和应用。Cursor的AI若没被格式约束,会把“建议增加单元测试”这种无效信息和真实漏洞并列输出。
最后加一句:“发现0个问题时,只回复‘✅ 未发现高危或中危问题’,不要解释原因。”避免AI为凑字数编造低价值提醒。











