AI生成代码的隐患往往潜伏于表面无误的代码之中,可能造成数据泄露或资产受损。Narwhal AI Code Risks开源项目系统梳理了真实事故案例、早期风险征兆及典型危害路径,助力开发者前置识别潜在威胁,规避同类失误。
2026年,代码生成速度持续加快,而人工审查却日益缩水。
越来越多场景下,用户将需求输入对话框,AI解析上下文后自动补全函数、拉取依赖、调整配置,并顺手产出测试用例。
待反应过来时,一段代码已悄然进入代码仓库,静待合并。
开发者已逐渐形成新范式:先让AI产出可运行版本,再针对性地排查与修正。
但在软件世界中,最具杀伤力的代码恰恰是那些看似平庸无奇的存在——语法无误、接口合规、测试全绿、注释详尽。
它仍可能引入虚构依赖包、授予过度权限、暴露数据库连接信息……甚至在提示词注入攻击下,驱使具备系统调用能力的Agent将敏感数据悄然导出至内网之外。
真正致命的,并非报错红灯亮起;而是所有监控指标均显示“一切正常”。
AI编码的风险曾零散分布:某篇安全博客隐含一个漏洞实例,某个GitHub Issue记录一段可疑线索。当另一支团队遭遇相似问题时,又不得不从头追溯风险源头,耗费大量人力开展实证分析。
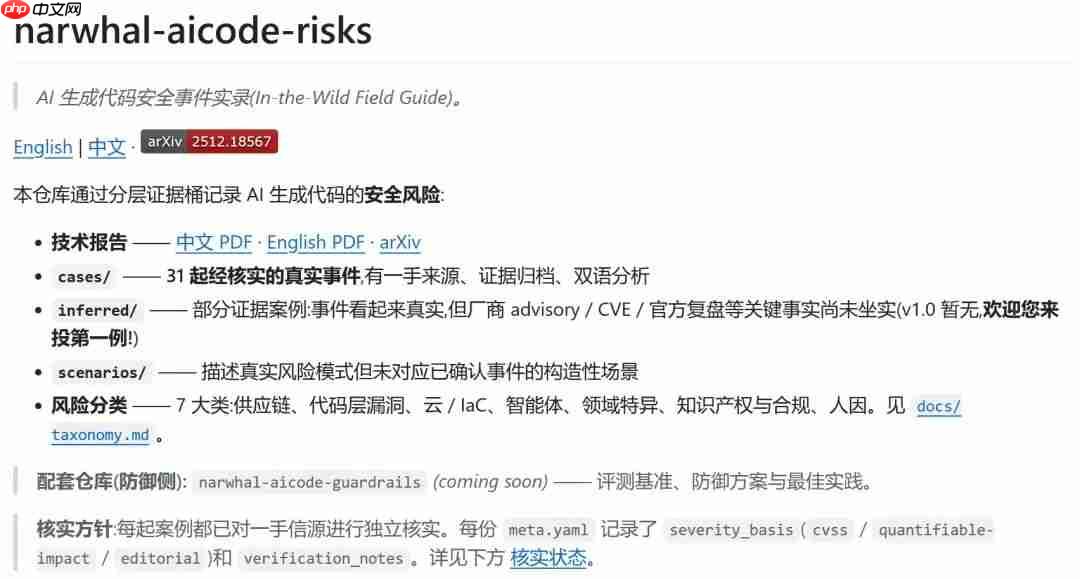
而北京大学Narwhal-Lab最新开源的Narwhal AI Code Risks项目,已完成碎片化信息的整合归类,按“真实事件”“早期信号”与“典型风险路径”三大维度组织,面向研究者开放查阅。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文链接: https://www.php.cn/link/2f096f9c5b7e2483fcc661e9ca9a24ec
当28项检查全部通过,系统依然悄然偏航
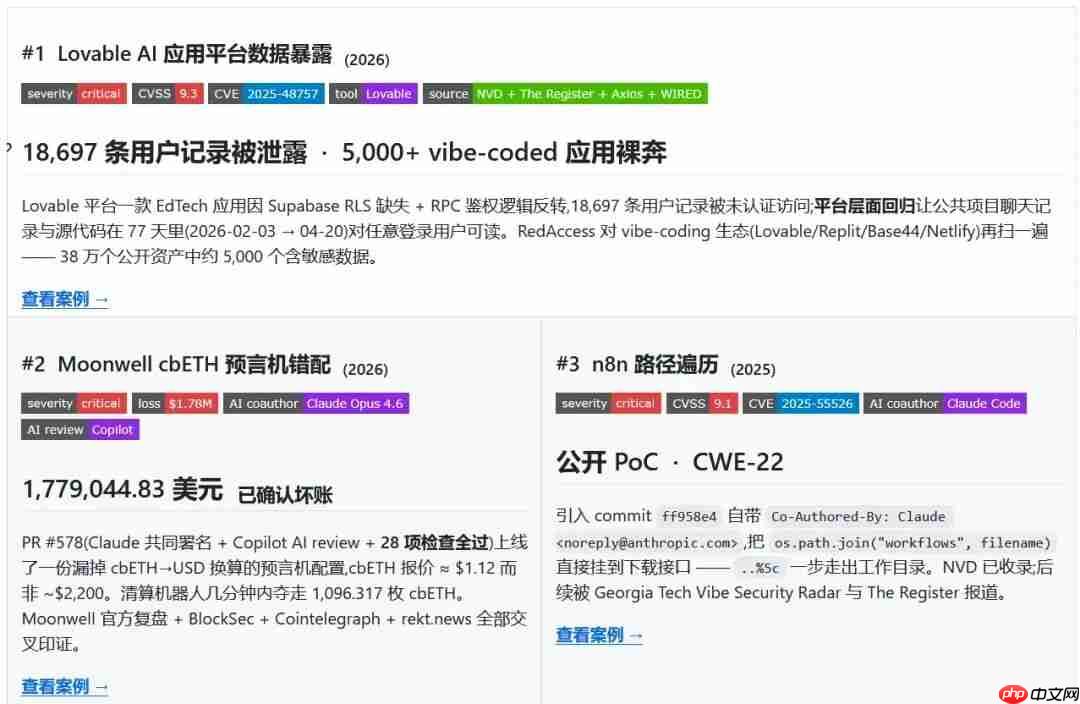
第一条线索源自一份已合并的Pull Request:PR署名栏赫然列出Claude Opus 4.6、Copilot及四位人类开发者。28项自动化检查全部亮起绿灯:无人察觉异常。
随后,清算机器人仅用数分钟便提取了价值1,778,044.83美元的抵押资产。
问题根源在于配置文件中将cbETH价格错误设定为与ETH的换算比例(约1.12美元),而非其实际市价(近2,200美元)。
一个语义层面的价格偏差,就这样顺利穿越开发、审核与合并全流程,最终在金融系统中酿成真实损失。这正是Moonwell cbETH预言机配置事故最令人警醒之处。
症结恰在于代码无语法错误,人类开发者亦未及时拦截异常流程。相反,整个交付过程显得完整且顺畅——这正是一次标准的工程实践。
但正是这种暗流涌动的“正常”,使其成为典型的安全事件样本。
AI编程的风险,并不总以编译失败或测试报错的形式显现。
更多时候,它披着“正确答案”的外衣,安静渗入工程链条:代码能执行、检查能通关、PR能合入,但业务逻辑早已脱离现实语义。
在低风险项目中,此类语义漂移或许仅导致返工;而在金融系统、企业级数据平台等高敏场景下,它将直接触发数据外泄、权限滥用与资产损毁。
当AI参与编码、配置修改、代码评审,乃至与人类共同署名提交PR时,我们是否真正掌握每一次偏航的发生机制?
绿色通行信号,照不到所有角落
早期AI辅助编程多限于局部补全。若语法有误,编译器会拦截;单元测试会失败;CI流水线会拒绝构建。
如今的AI Coding能力边界不断延展,而监管机制却尚未同步演进。

使用 @youdotcom-oss/teams-anthropic 将 Anthropic Claude 模型(Opus、Sonnet、Haiku)添加到 Microsoft Teams.ai 应用程序中。可选集成 You.com MCP 服务器以进行网页搜索和内容提取。
它可读取项目文件、修改配置项、安装第三方依赖、生成云基础设施脚本,还能借助Agent自主规划跨任务流程。
AI不再仅是旁观者式的工具递送员,而已深度嵌入软件工程更长的交付链路。
原本清晰的工程职责边界,正被AI Agent重新编织为一条更绵长、更难溯源的风险通路。
分散的记录,需要一份公共航行日志
安全事件极少在初始阶段即具备完整结论。部分事件证据确凿,可作为真实案例纳入索引;部分尚处于社区截图、研究员讨论或初步披露阶段,仅适合持续追踪;另有一些虽不对应单一事件,但风险模式已高度明确,适合作为前瞻性推演依据。
Narwhal AI Code Risks将资料划分为三层结构:cases/、inferred/ 与 scenarios/。
cases/ 收录具备公开信源与完整证据链的真实事件;inferred/ 存储尚未完全坐实但值得长期关注的早期预警信号;scenarios/ 汇总暂未绑定具体案例、但风险传导路径清晰的典型模式。
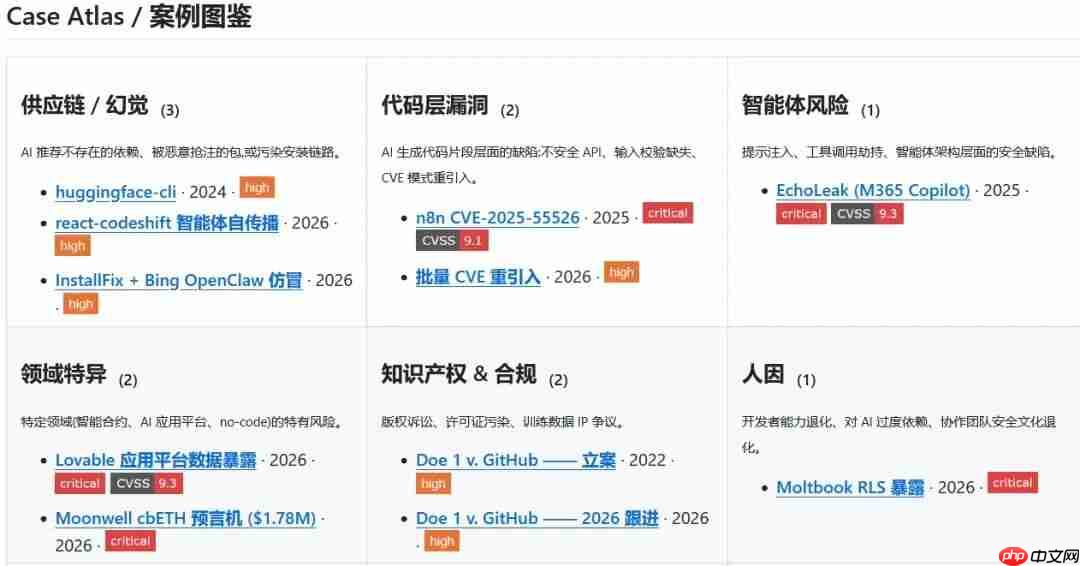
若缺乏此类公共记录,AI编程风险极易沦为互联网上的短期记忆。
今日热议某恶意包名,明日聚焦某次数据暴露,数月后又被新一轮工具热潮覆盖。待同类问题再度浮现,团队仍如盲人摸象般闯入未知风险海域。
Narwhal AI Code Risks所做之事,正是将这些零散风险切片固化下来,确保后来者能翻阅同一份底稿。
沿着七类索引,看见风险的来路
AI介入编码引发的问题,远不止于源码本身。它潜藏在依赖关系中、权限配置里、Agent工具调用间,更根植于人类对AI输出的信任惯性中。
Narwhal AI Code Risks当前将风险划分为七大类别:供应链风险、代码级漏洞、云与基础设施配置风险、Agent相关风险、垂直领域特有风险、知识产权与合规风险,以及人为因素风险。
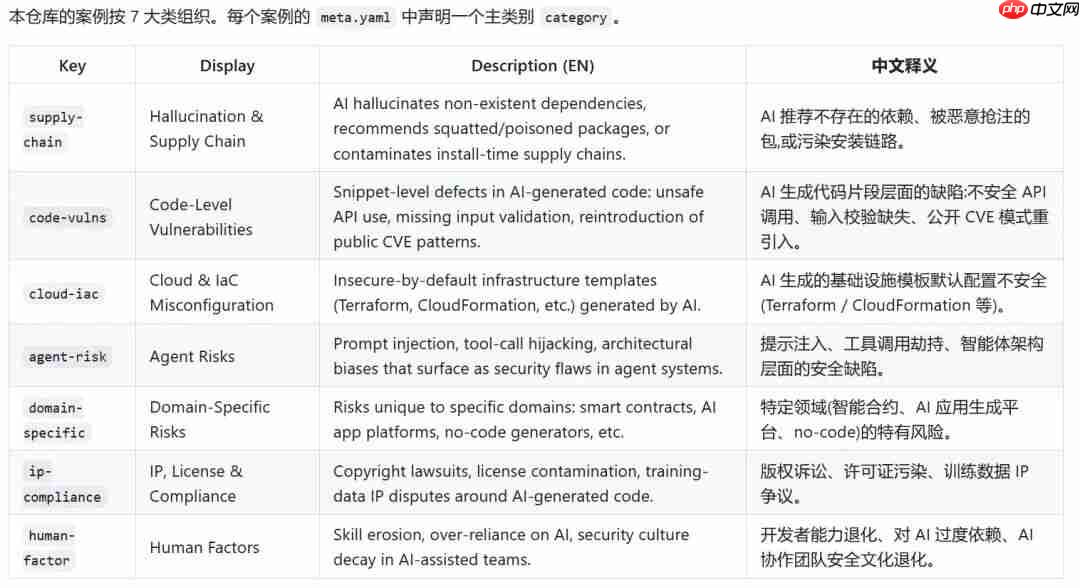
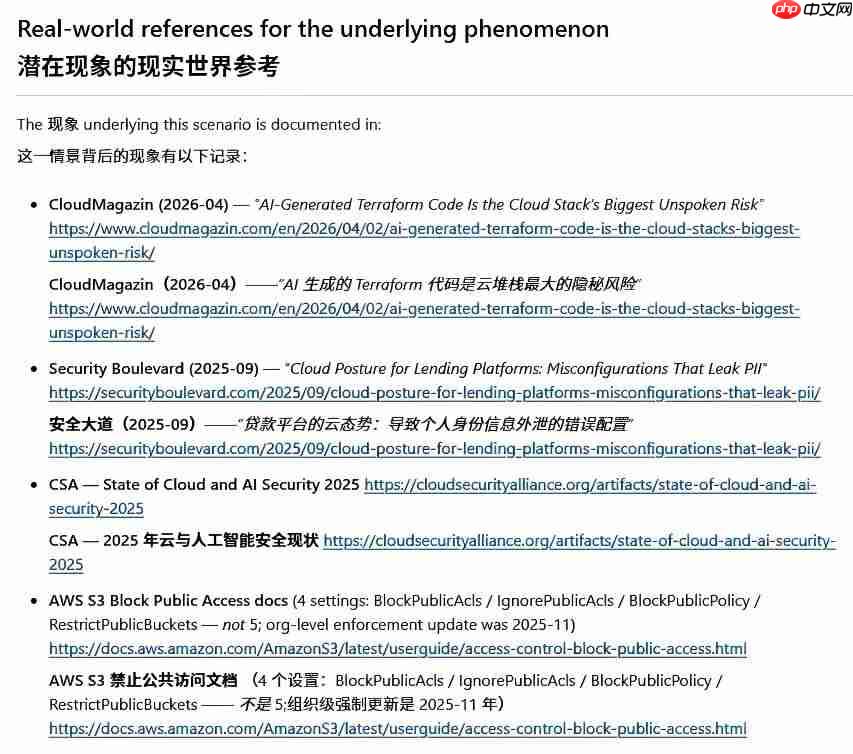
在供应链风险中,AI可能推荐根本不存在的依赖包;在代码级漏洞中,AI或将路径遍历、输入校验缺失、鉴权绕过等问题重新写入业务逻辑;在云与基础设施配置中,AI为求快速运行常赋予过宽权限、设置公开存储桶或暴露非必要端口;Agent风险则更为复杂——不仅生成文本,更开始执行真实动作。AI产出物正持续为生产系统埋设隐患。
AI引擎正在点火,而航行日志才刚刚翻开
当AI逐步深入真实业务场景,相关风险防控不应仅停留于事后复盘或碎片化讨论。
Narwhal AI Code Risks的核心价值,在于将风险案例转化为可复用的知识资产。
开发者可用其识别相似隐患;安全研究人员可将其作为实证样本库;工具厂商可从中提炼检测规则与评测基准;开源社区亦可持续补充新案例、新证据与新风险类型。
AI引擎轰鸣作响,每一次偏航都应留下精确坐标。风险不会因视而不见而消散,但经验可以被沉淀与传承。真正珍贵的并非单次漏洞发现,而是让后来者免于重蹈覆辙。
Narwhal AI Code Risks正在为AI应用元年的软件生态,编写一份开源的航行日志。
参考资料:
https://www.php.cn/link/2f096f9c5b7e2483fcc661e9ca9a24ec
本文来自微信公众号“新智元”,作者:LRST,36氪经授权发布。