





Nginx并发超限时按层级降级处理,不主动报错而是触发内核级限流:accept队列满(somaxconn不足)导致SYN丢弃、worker文件描述符达上限无法accept、worker_connections耗尽无槽位分配;需通过ss、netstat、/proc/limits等交叉验证真实瓶颈。
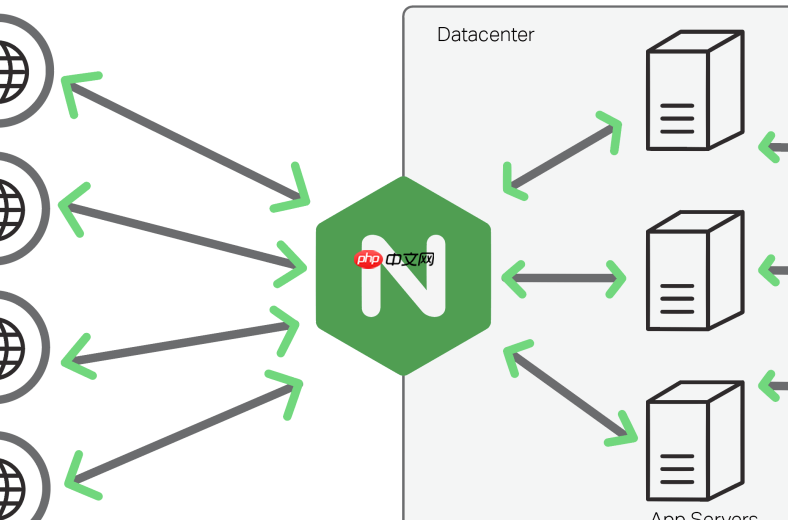
当并发连接数超过 Nginx 的配置限制时,它不会直接报错或崩溃,而是按层级降级处理——从拒绝新连接,到静默丢弃、排队等待,甚至触发内核级限流。关键在于:**Nginx 本身不“硬拦截”,但系统和配置共同构成了一道多层防线**。
连接被拒绝的典型表现
客户端发起连接时收到 Connection refused 或 timeout,通常不是 Nginx 主动拒绝,而是底层已无法接纳:
- 监听 socket 的 accept 队列满(
net.core.somaxconn不足),新 SYN 包被内核直接丢弃 - Nginx worker 进程打开的文件描述符已达上限(
worker_rlimit_nofile或系统nofile限制),无法调用accept() - 所有 worker 进程的
worker_connections已耗尽,且没有空闲连接槽位可分配
排队与缓冲机制的实际作用
Nginx 本身不缓存未 accept 的连接,但 Linux 内核会维护一个半连接队列(SYN queue)和全连接队列(accept queue):

-
listen 80 backlog=65535设置的是 accept queue 长度,必须 ≤net.core.somaxconn - 若队列已满,后续
SYN包会被内核丢弃,客户端重试后可能超时 - 启用
multi_accept on可让单次事件循环尽可能多地从队列中取连接,减少排队积压
静默降级:Nginx 不报错但自动妥协
很多问题看似“没报错”,实则是配置未生效导致的隐性降级:
-
worker_rlimit_nofile设为 100000,但系统ulimit -n只有 4096 → Nginx 启动时会日志警告,并自动将worker_connections降至 4096 级别 -
worker_processes × worker_connections = 100 万,但物理内存不足 → 连接结构体内存超限,导致 OOM Killer 干掉 worker 进程 - 未启用
epoll或multi_accept→ 单次只能 accept 一个连接,高并发下大量连接卡在队列尾部,响应延迟飙升
如何验证是否真的超限
不能只看 Nginx 错误日志,要结合系统指标交叉判断:
-
ss -s查看sockets in use和tw(TIME_WAIT)占比,若established接近worker_connections × worker_processes且synrecv持续存在,说明连接已饱和 -
cat /proc/$(pgrep nginx)/limits | grep "Max open files"确认 worker 进程实际生效的 nofile 上限 -
netstat -s | grep -i "listen overflows"若数值持续增长,说明 accept 队列溢出,需调大somaxconn和backlog











