


如今,ai 模型的能力似乎越来越强:在棋类对弈中轻松击败世界冠军,在各类主流 benchmark 上频频刷新 sota 记录。但为何仍难以真正承担起人类日常工作中那些复杂、连续、有实际经济价值的任务?
由加州大学伯克利分校主导,并联合全球 250 多位来自工业界与学术界的资深专家共同完成的研究,直指问题核心:“症结不在 AI 本身,而在于当前的评估方式已严重滞后。”现有通用基准,已无法有效反映模型在真实、长周期、高价值职业场景中的实际表现。
为此,研究团队正式推出全新评测基准——Agents’ Last Exam(ALE)。“最后一场考试”之名,既寓意其设定了能力准入门槛,也象征着它代表了当前 AI Agent 所需攻克的能力前沿边界。唯有当 AI Agent 能稳定通过 ALE 的全面考核,才意味着它真正具备了承接现实专业工作的潜力;此时 benchmark 上的进步,才真正具备实践意义。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
论文链接:https://www.php.cn/link/8488edf17e796d6b837dca8a46444721
考试结果一目了然:尽管主流大模型在传统测评中屡获高分,但在 ALE 最具挑战性的任务层级中,所有系统的平均完整通过率仅为 2.6%。这清晰表明,当前 Agent 在应对复杂、多步骤、跨工具的专业任务时,依然存在显著能力断层。
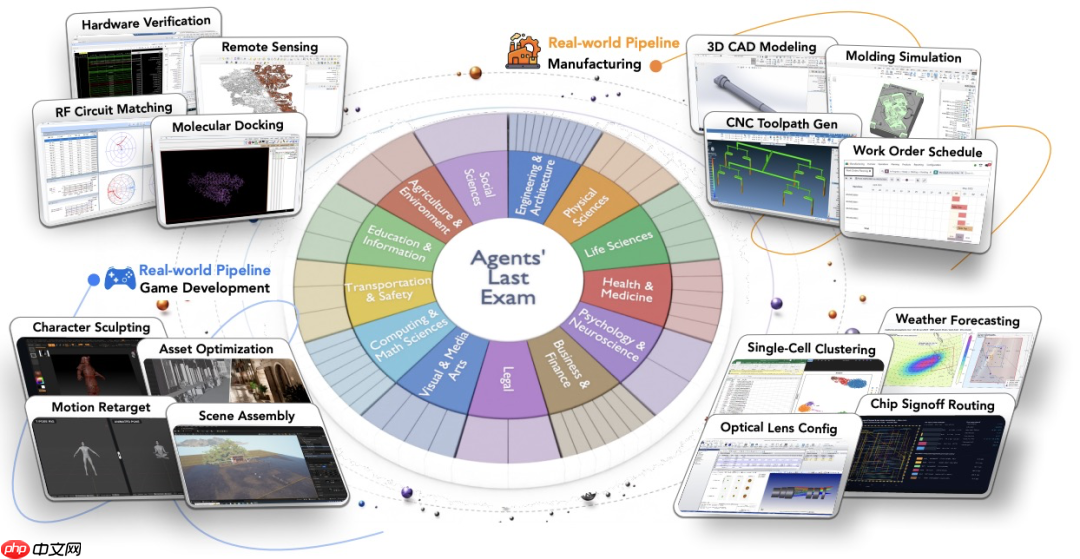
图|Agents’ Last Exam 覆盖大量真实行业任务与端到端工作流。
“最后一场考试”究竟考什么?
Agents’ Last Exam(ALE) 是由 250 余位一线从业者与领域专家协同构建的 AI Agent 综合评测体系,聚焦于衡量 AI 在长期性、可落地、具经济回报的真实职业场景中的综合能力。
为贴近人类真实办公方式,研究团队系统采集了 1490 项实操任务,横跨制造业、法律服务、医疗健康、视觉创意等多个关键行业。所有任务均源自从业者每日所面对的真实需求:例如,要求 Agent 在 Blender 中建模并渲染 3D 产品图;或在 DaVinci Resolve 中完成绿幕抠像、调色与多轨合成。
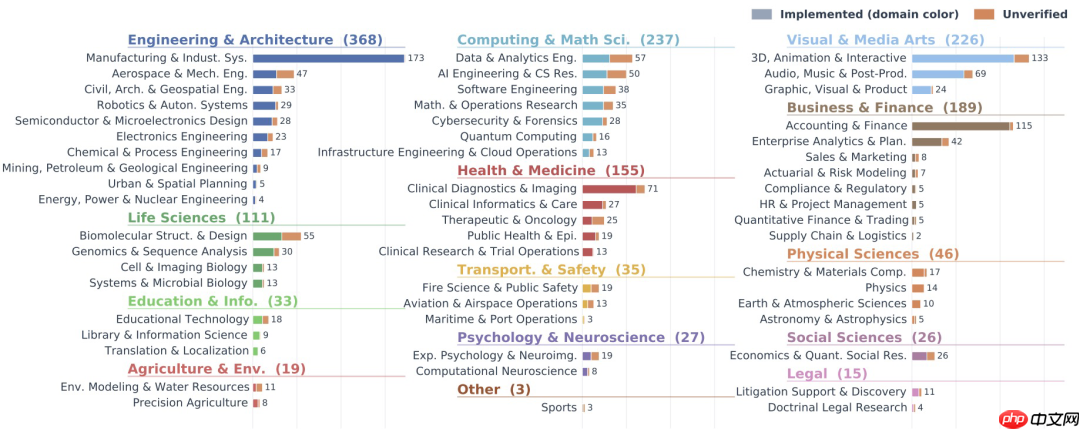
图|ALE 分类体系下 1490 个任务实例的领域分布。
相较于传统问答式或单步推理型 benchmark,这类任务对 Agent 提出了更严苛的要求。研究团队将能胜任此类任务的系统定义为 Generalist Computer-Use Agent(GCUA):它不仅要理解图形界面交互逻辑,还需熟练使用命令行、管理文件系统、编写调试代码、调用本地及远程工具,并自主串联整套工作链路。
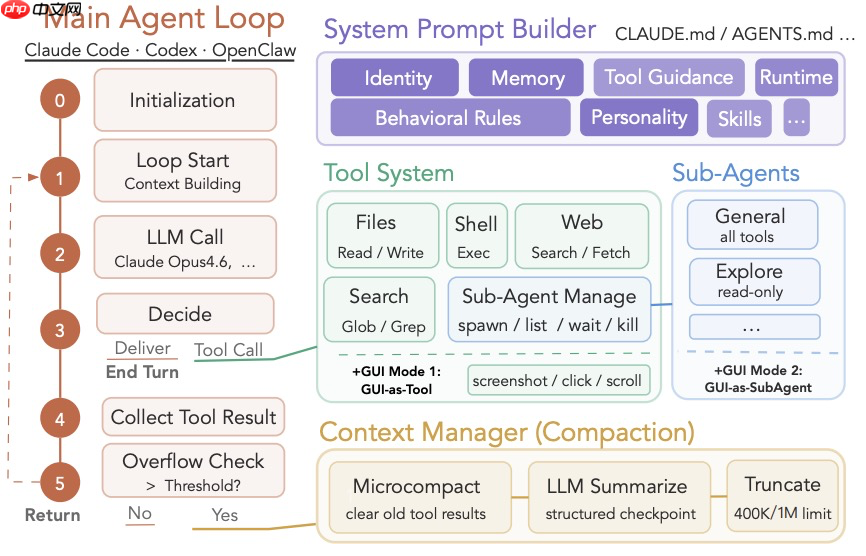
图|典型的 GCUA 架构示意。
为确保评测的真实性与可复现性,ALE 构建了一整套支持自动执行与自动评分的仿真环境。运行时,任务脚本负责初始化环境、加载目标、配置资源并最终校验输出;Agent 则依据自然语言任务描述,持续进行环境观测 → 动作决策 → 行动执行的闭环。任务结束后,系统直接比对产出物与标准答案,93.2% 的任务支持全自动判分,无需人工介入。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
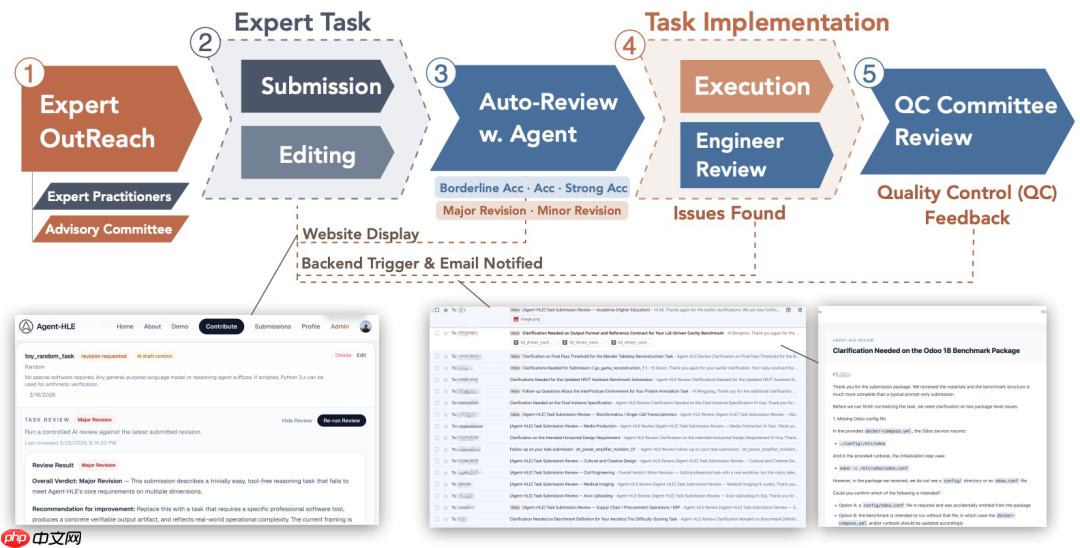
图|ALE 任务构建与执行流程示意图。
这场考试的成绩如何?
研究团队强调,在最难等级的任务集中,当前表现最优的组合是 Codex + GPT-5.5,其完整通过率也仅达 8.6%;而所有主流系统的整体平均完整通过率为 2.6%。
报告中列举了若干典型失败案例:在音乐乐谱转译任务中,AI 仅导出 MIDI 文件,却遗漏总谱 PDF 与界面截图,最终得分为 0;在注塑成型仿真任务中,Agent 成功在 Moldex3D 中完成模拟并导出结果,却未能准确提取关键工艺参数,得分仅为 0.4762;而在达芬奇绿幕合成任务中,AI 虽生成视频,但未满足色彩一致性、边缘精度等硬性指标,同样被判 0 分。
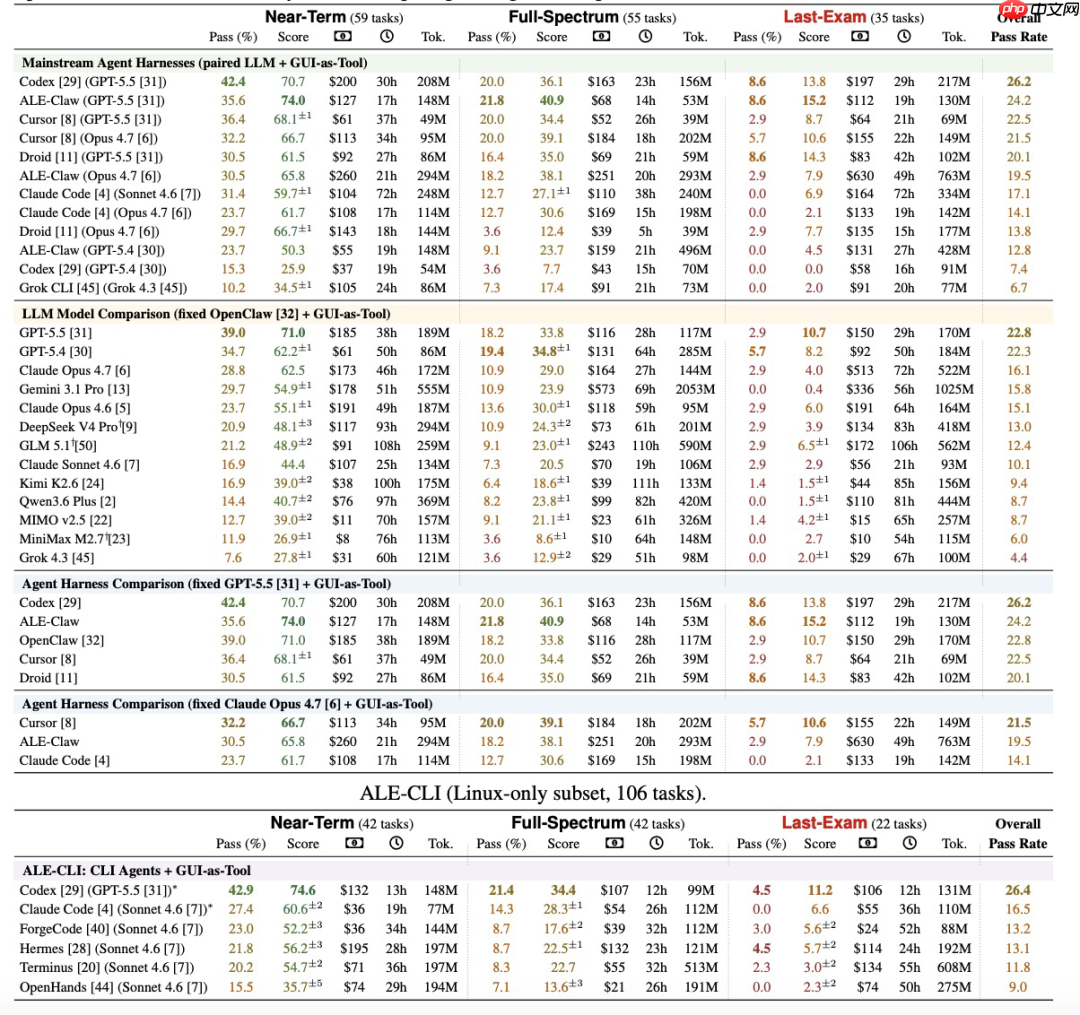
图|ALE 主要实验结果汇总。
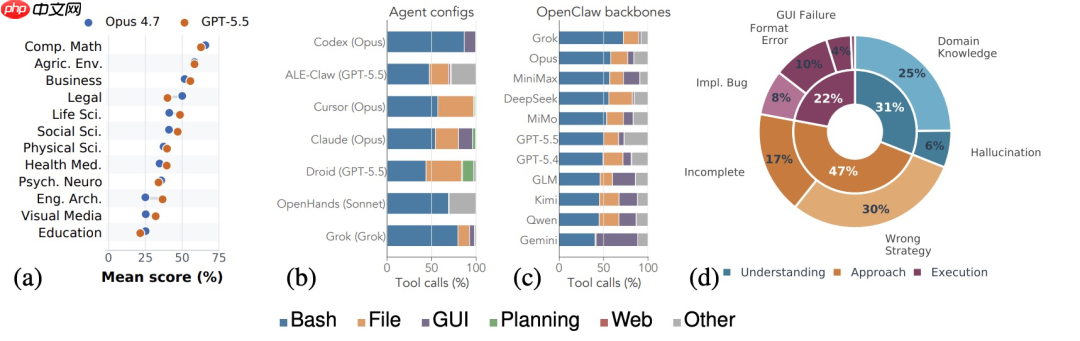
图|各维度失败归因分析概览。
研究团队进一步对失败原因进行了结构化归类。以 Claude Code + Opus 4.7 为例,31% 的失败源于任务理解偏差,47% 源于策略方法错误,22% 属于执行层面失误。其中,“理解+方法”类问题合计占比近八成。由此推断,当前系统的核心瓶颈在于领域专业知识的深度整合能力,而非底层操作或工具调用等执行技能。
此外,研究还对比了模型与 Agent 框架各自的影响权重。结果显示:更换基础模型带来的性能波动远大于更换框架本身。当固定 Agent 框架仅切换模型时,最高与最低通过率相差达 18 个百分点;而固定模型仅更换框架时,差异幅度仅为 5–6 个百分点。换言之,模型能力的贡献度约为 Agent 框架的三倍。
局限性与后续演进方向
研究团队坦承,ALE 当前以美国劳工统计局 SOC 2018 职业分类为骨架,主要覆盖软件密集型、高度数字化的职业类型;现阶段所有任务均部署于 Linux 或 Windows 虚拟机环境中。
同时,任务在各行业的分布尚不均衡。部分领域样本丰富,如法律领域含 15 个任务;而能源与核工程仅有 4 个,城市与空间规划为 5 个。目前公开发布的任务集,仅占全部构建任务池的一部分。团队曾以 Claude Code + Opus 4.7 进行验证:公开子集与完整任务池在各领域通过率的相关系数仅为 0.89,说明仍有可观的未见任务空间待探索。
不过,研究团队明确表示,ALE 并非静态基准,而是一个持续演进的开放生态。未来,任务库将持续拓展至新兴工作流与更多垂直行业;当前保留在私有池中的高质量任务,也将按计划定期释放至公开集,保障评测的广度、深度与时效性。
本文来自微信公众号 “学术头条”(ID:SciTouTiao),作者:学术头条,36氪经授权发布。











