


近日,anthropic 工程团队公开了其在打造三款 ai 应用 —— claude.ai、claude code 与 claude cowork 过程中,构建安全隔离体系的实践总结与反思。这三款产品分别服务于大众用户、软件开发者及企业级客户,其隔离机制与威胁建模各有侧重,但均以“环境层隔离优先”为根本设计信条。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
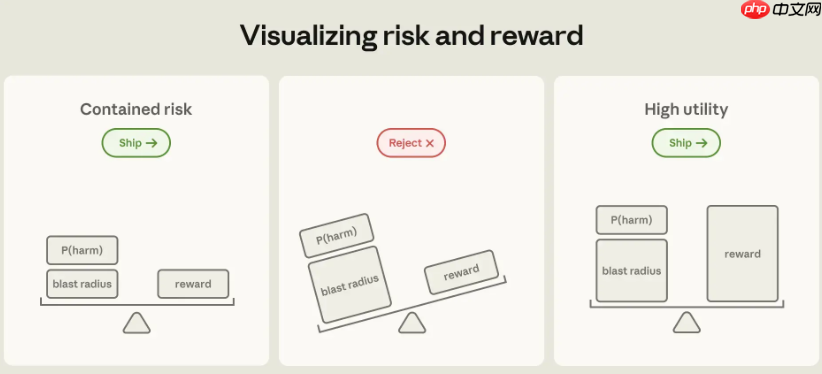
面向普通用户的 claude.ai,采用基于 gVisor 的轻量级临时容器架构。每次用户开启对话,系统即动态创建专属容器;会话终止后,该容器随即被彻底清除。该机制有效压缩了 AI 实例间的交互窗口与权限边界,大幅收窄潜在攻击面——即便遭遇异常,危害亦被严格约束于单次会话生命周期内。
面向开发者的 Claude Code,则依托操作系统原生沙箱能力重构访问控制逻辑。默认状态下,运行环境完全离线,杜绝了不必要的网络请求触发权限弹窗。实测数据显示,此举使用户遭遇的授权提示频次下降达 84%,显著优化操作流畅度。如确需联网(例如拉取依赖或调用外部服务),开发者可通过显式授权开启临时网络通道。
面向高合规要求的企业客户,Claude Cowork 采用了虚拟机级强隔离方案,实现与宿主机资源的物理级解耦。尽管该方案提供了业界领先的纵深防御能力,但也相应削弱了与本地系统(如日志采集、终端管控等)的协同效率,对安全可观测性提出了更高要求。
文中还披露了若干真实发生的安全案例,其中最具代表性的是一类利用社交工程实施的提示词注入攻击:在 24 轮红队测试中,攻击成功率高达 96%。此外,亦存在攻击者盗用合法 API 密钥实施数据外泄的情形。这些事件持续推动 Anthropic 对隔离策略、权限模型与人机协同机制进行迭代升级。

Anthropic 提炼出三条核心安全准则:第一,优先在环境层落实隔离,模型层仅作辅助引导;第二,隔离粒度须与用户自身的风险识别与响应能力相适配;第三,审慎定义各系统组件的职责边界与信任假设。这些原则不仅深度指导其产品演进路径,也为 AI 安全工程实践提供了普适性参考。
划重点:
? 环境层隔离先行:依据使用场景差异,差异化部署容器、沙箱与虚拟机等隔离手段,筑牢安全底座。
?️ 用户角色精准适配:claude.ai、Claude Code 和 Claude Cowork 分别聚焦终端用户、技术开发者与组织管理者,功能与安全策略高度对齐其行为特征与责任边界。
⚠ 攻击面持续暴露:钓鱼诱导型提示注入等高成功率威胁,倒逼安全架构向更主动、更细粒度、更具韧性的方向演进。











