


如果要在一句话里概括独立大模型赛道这两年发生的事,可以这样说: “AI六小龙”这个标签出生于2023年4月,死亡于2025年下半年。 事实之一是,六家变成了四家。 零一万物2025年放弃了万亿参数以上的超大基模预训练,百川智能的转身更早一些。2025年4月10日成立两周年的全员信里,王小川承认:“过去两年百川战线过长,接下来将收缩战线,押注医疗AI。” 留下来的四家公司,必须重新论证自己存在的理由。 但挑战来的快的多。 2025年1月20日,DeepSeek-R1发布,七天之后,英伟达股价单日下跌16.97%,市值蒸发约5900亿美元,创下美国上市公司单日市值损失的纪录。但DeepSeek那一周真正撕开的口子,不是英伟达的股价,而是中国大模型行业的核心叙事——当一家不在六小龙名单上的公司,用1/100的训练成本做出对标顶级闭源的开源模型,过去两年所有围绕“中国版OpenAI”的烧钱、投流、估值飙升,都需要重新论证它们的合理性。 这并不容易,2026年的开年,留下来的四家公司在港股完成了独立大模型赛道两年来最重要的一次身份转变。智谱1月8日敲钟,香港公开发售获1159.46倍认购;MiniMax 1月9日敲钟,1837.17倍认购,再次刷新纪录。月之暗面5月被《晚点LatePost》披露完成20亿美元D轮融资,投后估值突破200亿美元;阶跃星辰被《每日经济新闻》披露即将完成近25亿美元融资,目标基石定价百亿美元区间。 看上去大家都有光明的未来,但事实上,四家公司的市值差距,远比“AI四小龙”这个统一标签暗示的要大——虽然汇率会带来一些口径问题,但基本上,智谱市值是MiniMax的两倍;月之暗面虽然估值飙升,但仍然只有智谱的三成多;阶跃星辰技术阵容看似最豪华,目标估值却最低。 这种差距的背后,是当中国大模型行业的真正生产力战场从“超级应用”迁移到“Coding”的结构性变化,这场迁移在不同时间、不同程度地塑造了每一家公司的命运。 而这场迁移的源头,是一份2025年12月发布的报告。 ——导语
100万亿token告诉我们的事
2025年12月4日,openrouter和a16z联合发布了一份名为《the state of ai: an empirical 100 trillion token study with openrouter》的报告。这份报告基于openrouter平台过去13个月超过100万亿token的真实使用数据。
报告里有一组数据,把2025年中国大模型行业争论一整年的“超级应用幻觉”彻底击穿了——编程在付费模型token使用量中的占比,从2025年初的11%,飙升到2025年11月的50%以上。
这意味着,过去两年里所有人在中国大模型行业内卷的那些战场——长文本心智、AI助手日活、投流获客成本、估值飙升——都不是这场革命真正的token经济学引擎,真正的引擎是Coding。
从这个角度看,中国的头部大模型公司,距离全球顶流模型还有差距——在编程类API调用量中一度占据超60%份额的,是Anthropic的Claude。这个数字本身就是一记重击——它告诉所有中国独立大模型公司:Coding主战场的全球第一梯队,实际上仍由美国闭源巨头占据。
但中国公司也并未缺席。
立即进入“豆包AI人工智官网入口”;
立即学习“豆包AI人工智能在线问答入口”;
打开2025-2026年的主流Coding评测榜单——SWE-bench Verified、SWE-Bench Pro、Terminal Bench 2.0、Multi-SWE-Bench、SWE-rebench——中国名字会反复出现:阿里巴巴的Qwen3-Coder系列在SWE-Bench Verified接近70%,也在SWE-rebench上长期居开源前列,DeepSeekV3、R1、V3.2持续在榜,四小龙里押注Coding最早最深的几家——智谱GLM-5、Kimi K2.5、MiniMax M2.5,也在榜单上。
虽然,阿里的Qwen3-Coder不属于本文讨论的“独立大模型”范畴,但它的存在恰恰证明了一件事:Coding就是真正的主战场——连一家年营收过万亿的互联网巨头也倾全力做这件事。
而独立大模型公司能不能在这个主战场上拿到位置,直接决定了它们的市值排位。智谱、月之暗面、MiniMax、阶跃星辰这四家公司在2026年5月的市值差异,几乎完美对应它们各自押注Coding的时间先后、投入深度、以及决策风格。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
要看清这件事,得从四个人开始。
四代人
2026年1月8日下午,港交所敲钟现场,智谱AI的CEO张鹏站在台上。
但张鹏不是这家公司最有“创始人感”的人。智谱真正的灵魂人物是唐杰——清华大学计算机系教授,中国知识图谱与图神经网络领域的顶级学者,1977年生,2026年正好49岁。他没有出现在敲钟台上,但他是这家公司从清华KEG实验室走到港交所的所有决策核心。
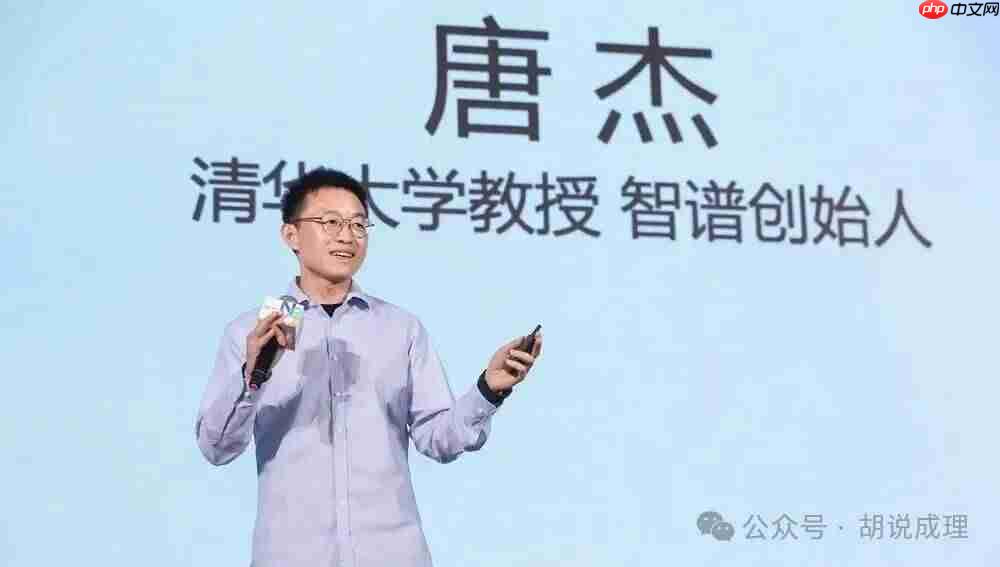
这位49岁的清华教授,带着一家以学术血统起家的公司,在中国大模型行业的至暗时刻完成上市,然后用开源Coding评测的第一名,逼迫整个行业接受“AI不应该免费”。
24小时后,MiniMax在港交所敲钟。台上是闫俊杰——1989年生,创业那年32岁。他从商汤副总裁的位置出来时,所有人都以为他会继续走“中国版商汤”的路——B端、政企、计算机视觉。但他做了相反的选择:C端原生、生而全球化、全模态并行。
到了 2026 年 2 月 12 日,中国大模型行业迎来了历史上最戏剧化的一天——两家直接竞争对手,同一天,发布同一类型的旗舰模型。
这不是巧合。智谱和MiniMax早在2025年Q4就分别确定了2月12日左右作为新模型的发布窗口。两家都知道对方会在这个时间发布。但两家都不愿意先发或后发——先发会被对方比较,后发会被认为是被动跟随。
最后的结果是同一天,几乎同一小时。
智谱选择凌晨——GLM-5正式发布是2026年2月12日凌晨。MiniMax选择上午——M2.5发布是同一天上午。这种“凌晨vs上午”的时间差,本身就是一种竞争策略——智谱用凌晨发布抢占海外媒体的早间关注,MiniMax用上午发布抢占国内媒体的当日头条。
发布后的24小时里,两家公司的官方账号、合作媒体、KOL几乎同时刷屏。智谱主打“开源Coding第一,涨价”;MiniMax主打“1美元1小时,成本革命”。两家公司同时刷屏的盛况,只在2025年初DeepSeek-R1发布时出现过。
闫俊杰感到心情沉重,他37岁,大厂技术高管出身,带着一家“反向押注”的公司在港交所拿到1837倍认购,但市值只有智谱的一半。
而杨植麟没有在港交所敲钟。他还在等。他1992年生,清华大学计算机系本科,卡内基梅隆大学博士。在清华期间,他以满分通过所有程序设计课程,年级第一毕业;在CMU,他仅用4年就拿到了通常需要6年才能完成的博士学位——这种背景在中国独立AI公司创始人里几乎独一份。
2024年,他被媒体称为“中国AI最年轻的明星创业者”。2025年中段,DeepSeek出来之后,他从公开舆论场消失了172天。2026年3月19日,他在英伟达GTC大会主舞台用流利英文做了40分钟技术演讲——本届GTC唯一受邀现场演讲的中国独立大模型公司创始人。马斯克在社交媒体上评价这场演讲“令人印象深刻”。
34岁的天才少年,带着月之暗面在3个月内完成3轮融资,估值从43亿美元飙升至200亿美元。但杨植麟最大的挑战是,他自己仍然是这家公司技术叙事的几乎全部承重墙,他没有一支有足够“板凳深度”的团队。
阶跃星辰的情况最特别。CEO姜大昕是前微软全球副总裁,1976年前后生人,2025年入选IEEE Fellow——这是中国独立大模型公司里最学院、最资深的技术决策者之一。但2026年1月,阶跃宣布前旷视科技联合创始人、千里科技董事长印奇出任公司董事长。
印奇1988年生于安徽芜湖,毕业于清华姚班,师从图灵奖得主姚期智。23岁创办旷视科技。他是“AI 1.0时代”四小龙操盘手之一,带着旷视上市失败的伤痕——商汤股价持续承压、依图终止科创版注册、旷视撤回IPO——从那个修罗场里走出来,38岁的他在阶跃重新出牌——一家公司,两个决策者:50岁前后的微软系科学家做CEO,38岁的连续创业者做董事长,这是中国独立大模型公司里唯一的双头结构。
唐杰、闫俊杰、杨植麟、姜大昕+印奇——这是中国AI界四代不同的人,他们分别代表着学术派老一代、大厂中生代、海归少壮派和连续创业者+技术派的复合体。他们出生年份的跨度从1976到1992,中间差着16岁。他们的人生轨迹之间几乎没有交集——直到2023年那个被杨植麟称为“窗口只有一个月”的春天,他们各自带着完全不同的判断走进同一条赛道。
三年之后,2026年5月的港股市场,把他们各自的判断转换成了不同的数字。
谁先看见了Coding
这四个人之间最大的判断差异,不是技术路线,不是商业模式,而是一件简单的事——他们各自在什么时候,开始意识到Coding是真正的主战场。
这条时间线,几乎决定了2026年五月那个下午港交所收盘那一刻的市值排位。
最先看见的是唐杰。智谱从2022年押注通用大模型开始,就坚持一件事——每一代基础模型都按“对标GPT顶级闭源”的标准做,而不是按“产品需要什么模型就做什么模型”做。在2023-2024年的中国大模型语境里,这种判断显得不合时宜。所有人都在抢用户、抢入口、抢心智,只有智谱看起来在“做技术”。
回头看,这种“不合时宜”恰恰是智谱2026年市值最高的根本原因。2026年2月12日凌晨,智谱发布GLM-5。744B总参数、40B激活参数的MoE架构,在SWE-bench Verified上拿下77.8分——当时的开源模型历史最高分(但之后MiniMax M2.5的80.2%已超越)。Artificial Analysis综合智能指数上,GLM-5排名全球开源模型第一。
更重要的是一个月后发布的GLM-5.1——据Z.ai官方报告,在使用Claude Code作为评估框架的Coding评测上拿到45.3分,达到Claude Opus 4.6评分的94.6%。4月,GLM-5.1在SWE-Bench Pro上拿到58.4分,据BenchLM公布的榜单全球第一,超过Claude Opus 4.6和GPT-5.4。
这些数字背后是四年的累积。当其他几家公司在2024年还在打投流大战的时候,智谱已经在悄悄做基础模型质量的长跑。这是唐杰作为50岁清华教授的判断逻辑——学术派最擅长的就是看长线,牺牲短期声量。
第二个看见的是杨植麟,但他是被叫醒的。
2025年1月20日DeepSeek-R1发布之后的172天里,Kimi几乎从公开舆论场消失。Kimi预训练负责人杜羽伦后来在访谈里回忆那段时间的氛围:“市场上的声音是,Kimi的故事讲完了。”
2025年7月11日,杨植麟用Kimi K2回答了这个质疑。MoE架构、一万亿总参数、32B激活参数,据多个第三方评测,K2在SWE-bench Verified上拿到65.8%——当时开源SOTA。Perplexity CEO公开表示,基于K2的良好表现,公司可能用它进行后训练。
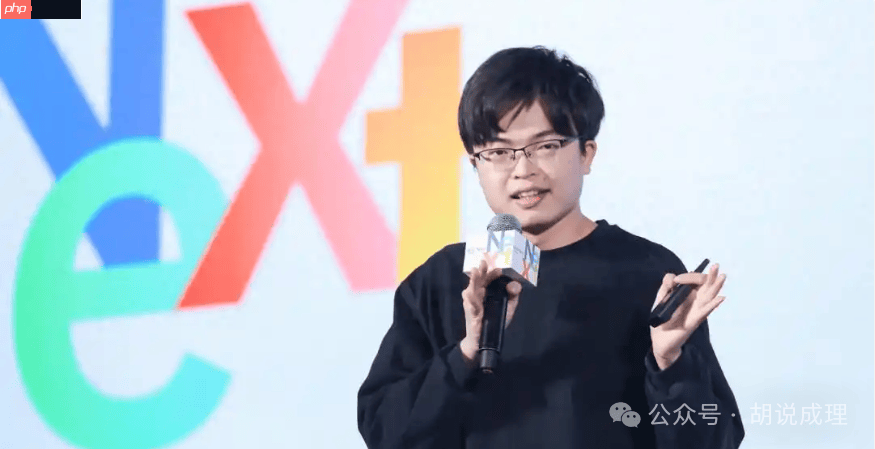
Kimi K2不是月之暗面公司战略最初的核心,它是被DeepSeek强迫做出的转身——从“中国版超级应用Kimi”转身到“开源SOTA基础模型”。这种被迫的清醒,让月之暗面在2025年下半年到2026年上半年的Coding竞赛里追上了第一梯队,但因为起步晚了智谱整整三年,代价就是估值仍然落后。
第三个看见的是闫俊杰。MiniMax M2系列发布于2025年10月——这是MiniMax公司历史上第一个明确按“Coding+Agent”导向设计的基础模型。比Kimi K2晚了3个月,比智谱GLM-4.5的Coding路线晚了将近一年。
这种“晚”不是偶然,是闫俊杰2021年那个判断的延续代价。当他从商汤副总裁出来创业的时候,他押注的是C端娱乐+全模态+出海——Talkie、星野、海螺AI。这条路在2024年看起来最聪明:Talkie全球下载量突破千万,超过Character AI,据《金融时报》报道,2024年为MiniMax创造7000万美元营收;MiniMax 2024年实现自负盈亏——这在中国独立AI公司里独一份。
但全模态助手的路线让MiniMax在基础模型质量,尤其是Coding能力上,错过了一整年。当2025年10月M2发布时,MiniMax需要在不到6个月时间里追平智谱和Kimi三到四年的积累。
追赶的速度很惊人。2026年2月12日(和智谱GLM-5同一天)发布的M2.5,据MiniMax官方评测,在SWE-Bench Verified上拿到80.2分,Multi-SWE-Bench第一,BFCL多轮函数调用76.8分。但市场认知和市值并没有跟上。
一个值得注意的反常现象是:转身更晚的MiniMax,2026年5月市值(2500亿港元)反而高于转身更早的月之暗面(约1550亿港元等值)。这似乎与“看见Coding越早市值越高”的逻辑相悖。细究之下,原因并不复杂:MiniMax的C端出海业务在2024-2025年已经跑通自负盈亏,Talkie的年营收和用户规模为它提供了独立于Coding的价值底盘。月之暗面虽然转身更早,但没有额外的现金奶牛支撑,资本市场对它的估值更为谨慎。换句话说,Coding主战场决定上限,但基本盘决定下限。
第四个,姜大昕和印奇,其实是看见了,但没来得及。一支由ResNet作者、IEEE Fellow、前字节Infra负责人组成的团队,不可能不知道Coding的重要性。但阶跃在2024-2025年把资源分散到了基础大模型、多模态、端侧、语音、视频等多个方向——不是不想做Coding,是做不过来。
其中,2024年,阶跃发布了超过10个自研基座模型,模型迭代速度行业第一。但打开SWE-bench Verified、Terminal Bench、SWE-rebench这些主流Coding评测榜单,几乎找不到Step系列模型的名字。
阶跃在2025年Coding主战场上的失位,不是偶然。这是一支技术派团队的“什么都想要”——基础大模型、多模态、端侧、Agent、语音、视频,每一条线都做,但每一条线都没有第一。
直到2026年1月,印奇加入,阶跃才完成了战略转向——从“基础大模型为王”到“AI+终端”。这不是顺势而为,这是承认——在Coding主战场上,阶跃似乎已经有点掉队了。
而2026年5月的市值排位,几乎就是这条时间线的倒过来。
时间线不会撒谎。看见Coding的时间早晚,直接决定了这些公司在Coding时代能拿到多少东西。
四种决策风格的代价
但只看时间线,会错过故事的另一半。
四家公司的决策风格——更准确地说,这四代人各自的决策模式——同样在塑造2026年5月那个市值排位。每一种风格都有自己的优势,但每一种风格也都在2025-2026年付出了它自己独有的代价。

智谱虽强,但也有学院派的运营天花板。
智谱2026年2月21日发布致歉信。这是GLM-5上线第9天。
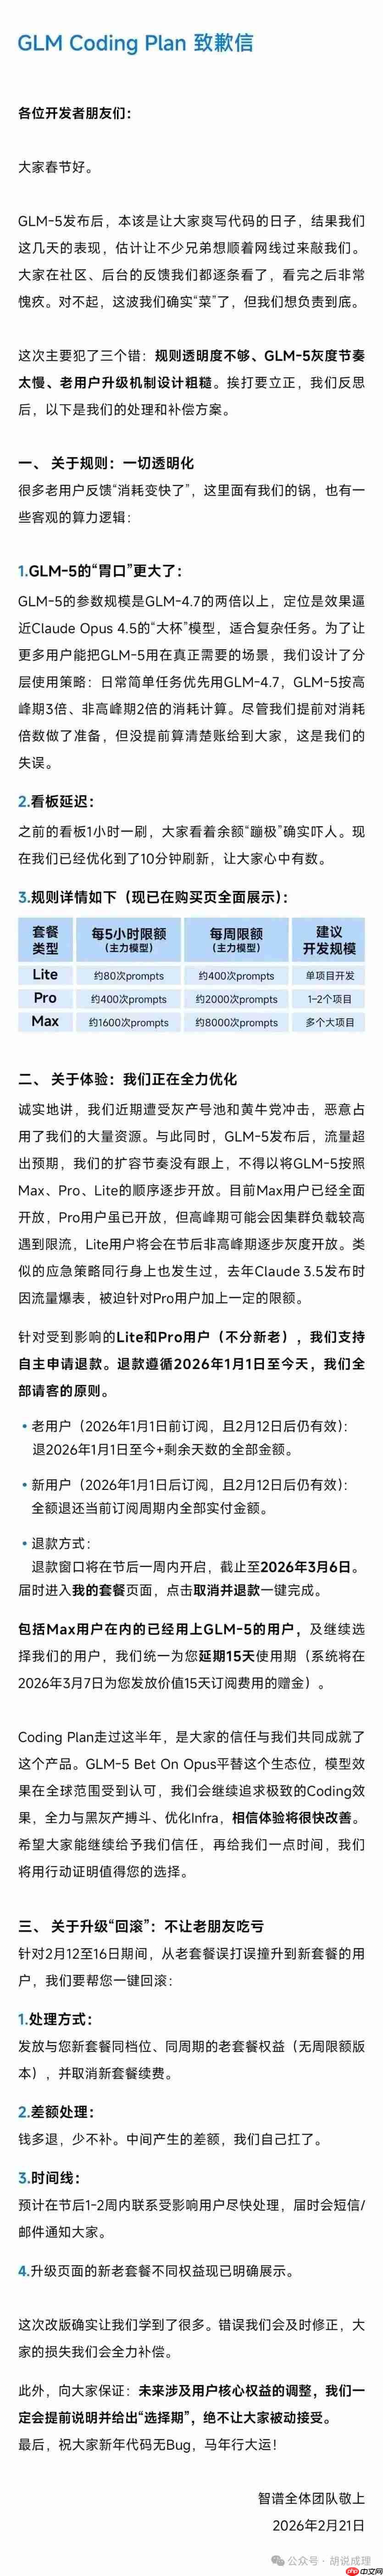
公司承认“主要犯了三个错:规则透明度不够、GLM-5灰度节奏太慢、老用户升级机制设计粗糙”。GLM-5的参数规模是GLM-4.7的两倍以上,公司预估的算力消耗倍数没算准,导致大量用户被限流、API超载。
这是中国独立AI公司港股上市后第一封公开致歉信。一家在港股市值5100亿港元的公司,刚拿到大模型市场议价权,八天后就撞上了自己运营能力的天花板。
这是学院派的代价吗?
唐杰作为清华教授出身,他擅长的是看技术长线、判断研究方向、领导团队做出代际突破——这些智谱都做到了。GLM-5的开源Coding第一就是证明。但学院派最不擅长的,恰恰是2026年中国大模型公司必须做好的另一件事:像一个互联网产品公司一样,把每一次大规模产品上线的运营节奏、流量预估、用户分层、客服响应做到精确。
至今,大部分业内人士都会告诉你,智谱的服务稳定性仍是个大问题。
GLM Coding Plan上线即售罄。这是好事,也是坏事——好的是市场用真金白银投票;坏的是公司没准备好接住这次投票。致歉信发布的当天,智谱股价单日暴涨42.72%——可见,当时的市场对智谱技术的认可,远远超过对它运营失误的不满。
但这种“市场宽容”不会永远存在。当智谱不再是“开源Coding第一”的时候,当它在2025年还很多次被Kimi K2.5、MiniMax M2.5、DeepSeek V3.2在不同子项上反超的时候——智谱的运营天花板就会变成它估值的天花板。
智谱故事里还有一个被大多数稿件漏掉的硬细节。GLM-5系列全程在10万张华为昇腾910B芯片上训练,零英伟达GPU,使用华为自研MindSpore框架。这件事的背景是,2025年1月,智谱被美国列入实体清单。
一家在美国制裁下,用国产芯片训练出全球开源Coding第一模型的公司。这是2025-2026年中国AI最被低估的一件事。
但它也意味着智谱的算力护城河,某种程度上是“被迫”挖出来的。如果美国制裁的尺度发生变化,这条护城河的战略价值会重新被评估的。
杨植麟则有一种“天才少年带来的梯队脆弱”是最大弱点。
2026年3月18日的GTC演讲被马斯克评价为“令人印象深刻”。极短时间内,目标估值500亿美元的硅谷编程工具Cursor被开发者扒出,新发布的“自研模型”Composer 2实际套壳Kimi K2.5,Cursor创始人公开道歉。
这是月之暗面2026年最高光的一周。
但月之暗面真正的脆弱性,藏在这种高光的另一面——业内一个长期没有公开讨论但反复被提及的判断是:月之暗面的技术叙事,几乎完全靠杨植麟一个人撑起来。
公开报道里很难找到月之暗面除杨植麟之外的技术梯队代表人物。联合创始人周昕宇、吴育昕在2025年11月Kimi K2 Thinking发布后参加了Reddit AMA,但行业普遍认为,月之暗面的关键技术决策权高度集中在杨植麟手上。这和智谱的“学院团队制”、阶跃的“姜大昕+张祥雨+朱亦博三位一体”、MiniMax的“闫俊杰+研究院体系”形成鲜明对照。
至今不为人所知的是,月之暗面除杨植麟外,核心算法决策人是谁?周昕宇、吴育昕在K2和K2.5的关键技术决策中起到了什么作用?
这就是问题所在——天才少年的优势是判断敏锐、决策果断、技术理想主义浓厚。杨植麟在GTC演讲中提出的Kimi进化逻辑——“Token效率、长上下文、智能体集群三个维度的技术增益相乘”——是真正前沿的判断。他在Reddit AMA上承认“我们用的是配备Infiniband的H800 GPU,虽然不如美国的高端GPU,但我们充分利用了每一张卡”,这种坦诚也是这种创始人风格的力量。
但天才少年模式的代价是单极风险。一旦杨植麟出现任何变化——健康、判断失误、被挖角、内部矛盾——月之暗面的技术叙事会立刻失去重心。
更深的问题是商业模式。在与字节豆包、DeepSeek、腾讯元宝等产品的竞争中,月之暗面是唯一一家没有大厂或金融集团现金奶牛支撑的独立创业公司。
这就是为什么“短期不急于上市”的承诺,在2026年5月被一笔20亿美元D轮融资和港股IPO接洽彻底改写。
杨植麟在2026年内部信里写下那句最有野心的话:“接下来公司最重要的目标是超越Anthropic等前沿公司,成为世界领先的AGI公司。”
这句话在2025年中段那个低谷时刻是不敢说的。2026年4月月之暗面ARR超过2亿美元,他有了说这句话的资本。但这种“在天才创始人身上下注”的模式,本身就是月之暗面市值不能再上一个台阶的根本约束——投资人愿意为天才付钱,但不会为单极风险付太多钱。
闫俊杰的标签是“大厂派的迟到觉醒”——在2026年3月的财报电话会上做了一个值得记下来的发言。这位曾经把全模态押到底的创业者,开始把M3和Hailuo 3称为公司的“核心壁垒”,但他在更靠前的位置加了一句:“多个模态融合是持续提升智能的前提。过去四年,我们把每个模态都做到了行业领先。”
这句话有一个微妙的潜台词。
MiniMax在过去四年里把每个模态都做到了“行业领先”,但“行业领先”不等于“代际突破”——而后者才是2025年Coding时代的真正门票。
闫俊杰是大厂技术高管出身——前商汤副总裁、研究院副院长。这种背景的创业者最擅长的是体系化、规模化、跨地区运营。这就是为什么MiniMax能在2021到2024年用一条“反向押注”的路跑通C端付费、跑通海外市场、跑通自负盈亏——这些都需要大厂派的体系化能力才能做到。
但大厂派也有自己的代价——他们对市场的判断,往往滞后于技术理想主义者半步到一步。当杨植麟2024年就在押注超级应用、唐杰从2022年就押注基础模型质量、印奇2024年就开始布局“AI+终端”的时候,闫俊杰仍然在专注地把Talkie做成美国下载榜第四。
这种判断滞后,在2024年没有任何代价——甚至看起来是优势。但2025年DeepSeek把游戏规则改了之后,这种滞后就变成了真实的市值差距。
MiniMax M2.5在技术上已经追平第一梯队。1美元可以让M2.5连续运行1小时——这是真正的“成本结构革命”。但市场认知和市值并没有跟上。2026年5月13日,MiniMax港股市值2500亿港元——只有智谱5100亿港元的一半。
差距在哪里?不在模型质量,在心智占位。当智谱的GLM-5在2026年2月发布时,海外开发者已经把“中国Coding模型”等价于“DeepSeek+GLM+Kimi”。Kimi K2也已经被Cline、Claude Code、RooCode、OpenHands等主流代码智能体广泛集成。
MiniMax M2.5虽然技术上不输,但在主流代码智能体的集成深度和开发者社区心智上慢了至少两个季度。这两个季度的差距,在Coding时代的“赢家通吃”逻辑里,被资本市场放大成了市值上的50%差距。
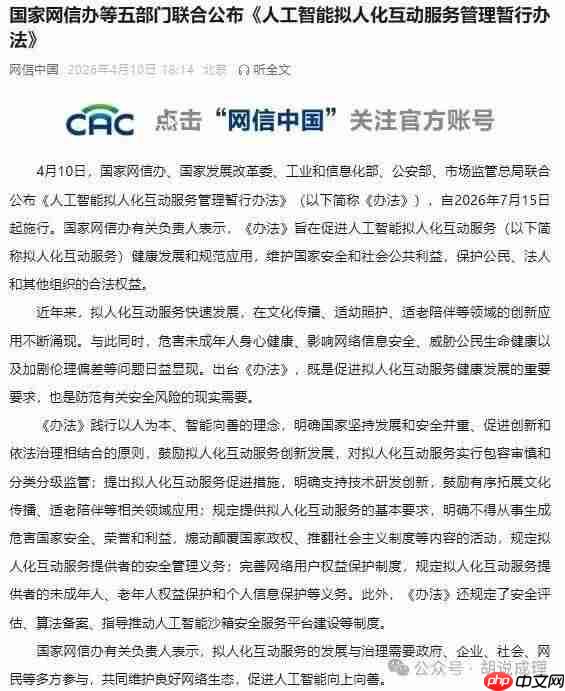
更深的挑战在2026年4月10日浮出水面。中国发布《人工智能拟人化互动服务管理暂行办法》——第14条禁止向未成年人提供“虚拟亲属、虚拟伴侣”等虚拟亲密关系;第22条规定用户规模超100万的产品触发安全评估。海螺、星野、Talkie全部在适用范围内。
MiniMax是中国独立AI公司里最早盈利的、最早走通C端付费的、最早大规模出海的。但它的所有红利,正在被它2021年的判断本身一点一点收回——当行业从C端娱乐迁移到B端生产力,当基础模型质量取代多模态融合成为新的衡量标尺,大厂派的体系化优势变成了反应迟缓。
阶跃星辰的故事在四家里最低调,也最沉重。
姜大昕、张祥雨、朱亦博——这三个人凑在一起,在2024年的中国独立大模型公司里几乎找不到对手。ResNet作者+IEEE Fellow+前字节AI Infra负责人,理论上应该做出中国最强的基础大模型。
但他们没有做到。
打开SWE-bench Verified、Terminal Bench、Aider Polyglot、SWE-rebench这些主流Coding评测榜单,几乎找不到Step系列模型的名字。打开Claude Code、Cline、RooCode、Cursor、OpenHands、Kilo Code这些主流的代码智能体,也几乎找不到Step模型作为推荐选项。
这是阶跃故事最沉重的一笔。一个由ResNet作者、IEEE Fellow、字节前Infra负责人组成的团队,在2025年Coding时代,失去了基础大模型质量竞争的核心位置。
为什么?
很难验证的一些事实是——阶跃内部在2024-2025年关于C端转向、Coding押注的具体分歧,以及姜大昕和张祥雨在技术路线上是否有过公开记录之外的辩论。
但公开能看到的答案是——技术派的判断模式,本身就和“在一条主战场上做到第一”的逻辑天然冲突。技术派最容易陷入的陷阱是“什么都想做”——因为每一条技术路线在他们眼里都很有趣、都很有挑战、都值得投入。
阶跃做了所有人都做的事——基础大模型、多模态、长文本、小模型、语音、视频、Agent、端侧——但没有把任何一条做到全球第一。这是一种“博而不精”。在2024年还不致命,因为整个赛道都在博;但到了2025年Coding主战场清晰之后,这种博而不精就变成了致命伤。
印奇2026年1月加入,本质上是为这种博而不精做出一次外科手术式的纠正。他的判断很直接:“AI 1.0时代最大的教训是拿着锤子找钉子,技术与场景割裂。到了AI 2.0时代,必须构建‘技术-产品-商业’的完整闭环。”
但即便有了印奇,阶跃的“AI+终端”转向也不是纯粹的胜利,而是一种妥协——承认在通用基础大模型的核心战场上已经追不上头部,只能去找一条没人能跟你抢的窄路。
这条窄路在4个月内显现了成绩:据观察者网2026年1月披露,手机预装机量突破4200万台,覆盖国内约60%的头部手机品牌;与吉利合作的座舱AgentOS量产上车,3个月销量近4万辆;据《财经》披露,阶跃2025年营收近5亿元,2026年预计约12亿元。
这是连续创业者印奇的擅长。他在AI 1.0时代带过旷视从纯算法到综合解决方案的转型;他在AI 2.0时代要把阶跃从纯技术到“AI+终端”再走一遍。但这一次,他和姜大昕一起,要在一个比AI 1.0更残酷的赛道里证明同样的事。
连续创业者的代价,是必须把不甘心放在一边,接受妥协的合理性。这在2026年的阶跃身上叠加成了一种沉重的清醒:估值最低,但路线最实。
当然,押注Coding的时间早晚并非市值差异的唯一变量。 智谱能最早押注,本身也因为它有政企B端现金流支撑;月之暗面能在DeepSeek之后快速转向,也因为它一直保持着较高的融资能力和人才密度;MiniMax虽然转身最晚,但其C端出海的现金牛业务为它提供了独立于Coding的价值底盘。换句话说,时间线是结果,也是原因——但无论如何,那条时间线上四家公司的位置,与2026年5月的市值排位高度吻合,仍然是一个值得审视的事实。
如果印奇能够连续兑现自己的想法,阶跃星辰并非没有翻身的一天。
本文来自微信公众号“胡说成理”,作者:胡喆,36氪经授权发布。











