





摘要:长期以来,全球大模型的定价主导权掌握在硅谷厂商手中。deepseek 凭借卓越性能与极具竞争力的价格,在海外开发者群体中引发显著替代效应。
近日,一张AI主题漫画在社交平台广泛传播——画中人物虽以梁文锋为原型,却经过夸张的漫画化处理,外形酷似超人等经典超级英雄形象。网友戏称:这正是“海外开发者心目中的梁文锋”。
这张漫画意在传达一个关键节点:就在上周末(7月31日),DeepSeek V4 Flash正式版上线后,凭借前所未有的性价比优势,实质性重塑了全球开发者的AI技术选型格局。
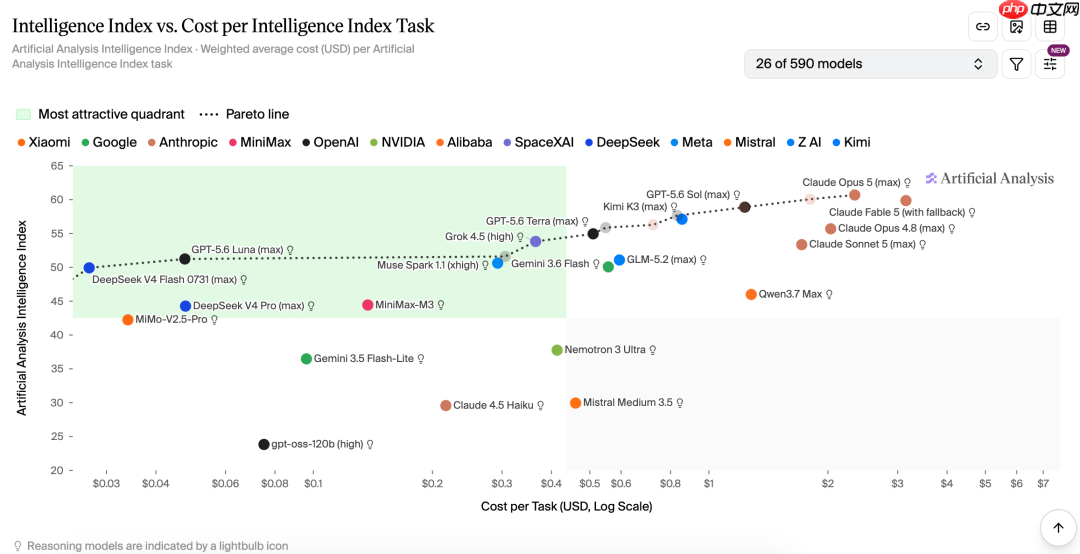
海外独立大模型评测社区Artificial Analysis在完成上百款模型实测后,逐步演化出一张标志性能力-价格分布图。而DeepSeek-V4-Flash,正成为这张图表中一条清晰、不可逾越的分界线。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
OpenRouter最新周度公开数据显示,DeepSeek-V4-Flash已跃居平台单模型调用量首位;V4-Pro则稳居前五。全球开发者正加速将生产环境中的推理请求,大规模迁移至这家中国AI企业的API服务。
OpenCode CEO Jay(贾亚库马尔)于8月1日发文证实:DeepSeek V4 Flash上线首日,其平台调用量激增30%;同期,OpenCode Go新增订阅用户亦增长30%。
过去多年,全球大模型市场的游戏规则由硅谷巨头一手制定。OpenAI、Anthropic、谷歌不仅定义了性能基准,更牢牢掌控着定价权。高昂的推理成本,无形中筑起一道AI创业的高墙。海外中小开发者若想获得稳定、高质量的大模型服务,往往只能被动接受闭源厂商设定的高价。
如今,行业拐点已然到来。依托持续进化的模型能力与极致优化的云端API定价,DeepSeek在全球开发者市场划下了一道明确的“斩杀线(Kill Line)”。
DeepSeek V4 Flash再度登顶,国产大模型包揽榜单前五
所谓“斩杀线”,并不仅是一条性能分水岭,更是性能与成本达成最优平衡的关键阈值:在同一能力层级中,定价明显高于DeepSeek的模型,将持续流失中小型开发者;而性能不及DeepSeek、价格却更高的产品,则将迅速丧失生存空间。
据OpenRouter最新周期Token调用公开数据,DeepSeek-V4-Flash荣登单模型调用量榜首;第二至第五名依次为:小米MiMo-V2.5、腾讯Hy3、DeepSeek V4 Pro与智谱GLM5.2。若汇总全部国产模型总调用量,已连续多周超越美国闭源厂商模型调用总和。其中,来自美国与欧洲的开发者流量占比接近50%,大量Agent自动化项目、代码辅助工具及长文本处理应用,已主动将默认模型切换为DeepSeek。
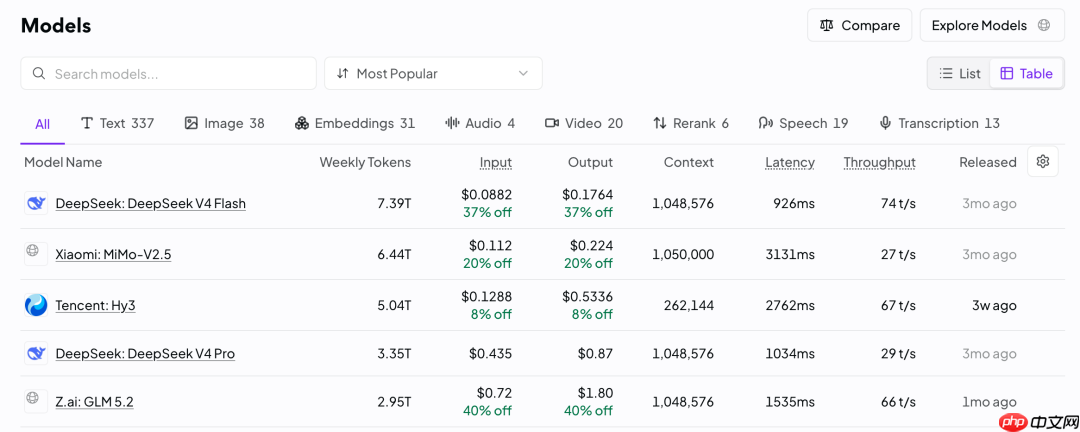
与此形成鲜明对照的是,Claude主流版本与Gemini旗舰模型的调用增速持续放缓,传统海外闭源头部模型的市场份额正不断收窄。多位海外AI初创创始人在X平台坦言:团队全面迁移到DeepSeek后,月度推理支出下降达60%至85%。对于尚未盈利、现金流高度紧张的小微AI公司而言,如此幅度的成本削减,直接关乎项目存续。
当前市场正加速分化为两个生态圈层:大型跨国企业出于数据合规性与供应链安全考量,仍倾向采购OpenAI、谷歌等本土厂商服务;但对成本极度敏感、响应速度要求更高的中小开发者群体,已开启系统性迁移浪潮。
不少行业观察者指出,OpenRouter的数据揭开了行业表象之下的一层真相:过往许多团队选择硅谷大厂模型,并非因其性能无可替代,而是长期缺乏兼具一线能力与合理价格的替代选项。一旦高性价比的优质模型出现,需求端的选择便迅速转向。
当然,第三方聚合平台的数据存在天然局限。调用量高低不等于企业实际营收规模,大量请求集中于低价的Flash轻量版;同时,平台样本难以覆盖政企级大客户市场。但毋庸置疑的是,开发者始终是AI产业创新的源头活水——赢得开发者,即赢得未来应用生态生长的根基。
仍是无可争议的性价比标杆
就在DeepSeek发布V4 Flash当日,Artificial Analysis完成了对128款大模型的横向实测。“斩杀线”一词由此诞生。开发者普遍共识是:单纯低价难具长期竞争力,纯粹追求高性能亦无法撬动存量市场;唯有在准一线性能基础上,实现断层式价格优势,才能持续对竞品形成有效挤压。

使用固定的 Next.js/Tailwind/Prisma 技术栈构建并记录独立 SaaS 项目,仅将 FastAPI 用于 Python 工作负载,并遵循严格的架构规范。
回溯DeepSeek的定价演进路径,其价格壁垒构建逻辑清晰可见:2026年5月,DeepSeek-V4-Pro宣布永久降价75%,将短期促销固化为长期基准价,一举击穿当时全球高端推理模型的价格底线;随后V4-Flash正式推出,叠加对话缓存机制与峰谷差异化计费策略,使缓存命中场景下的输入Token成本进一步下探。
横向对比当前主流大模型公开云端API定价(按百万Token计,单位:美元),差距显而易见:DeepSeek V4-Flash输出单价为0.28美元/百万Token;即便经历多轮调价后的GPT-5.6 Luna,输出单价仍高达约1.2美元/百万Token。Claude Sonnet、Gemini同档旗舰模型的定价,普遍为DeepSeek的数倍乃至近十倍。
这组数字已在海外开发者社群中形成普遍认知:绝大多数面向C端及中小B端的商业场景中,为微小性能提升承担数十倍推理成本,完全不具备商业合理性。任何位于该“斩杀线”之上的竞品,仅剩两条出路:主动大幅降价,或彻底退出普惠开发者市场,转而聚焦预算充裕、重视供应链稳定性的高端企业客户。
面对流量持续外流,OpenAI紧急下调GPT系列模型价格;欧洲厂商Mistral重启商业化策略,以开源免费+云服务优惠组合稳住开发者基本盘;众多中小型开源模型服务商被迫重估成本结构,放弃依赖高API毛利盈利的旧有幻想。
尤为关键的是,DeepSeek“性价比之王”的声誉早已深入人心。其并非依靠短期补贴打价格战,而是通过底层工程持续精进——包括高效推理架构、动态KV缓存、流量峰谷智能调度、长文本专项优化等多重技术手段,系统性压低单Token推理成本。梁文锋在内部曾表示:“低价策略让更多开发者能用上DeepSeek”,这一理念在团队内获得广泛认同与鼓舞。
“性价比斩杀线”所引发的,是行业核心竞争逻辑的根本迁移:过去比拼的是参数规模、训练算力与Benchmark跑分;如今开发者最先核算的,已是“单位成本所能换取的有效输出量”。
引爆社媒的48小时
性能与价格的硬指标,最终沉淀为真实社区口碑。X平台、Reddit r/LocalLLaMA板块、HackerNews以及LMSYS竞技场,构成海外舆论主阵地。其中X平台聚集大量一线开发者与AI创业者,持续发布深度实测内容,推动DeepSeek热度持续升温,舆论呈现明显分层。
颇具意味的是,在DeepSeek V4 Flash正式版发布前一日,OpenAI刚刚官宣GPT-5.6 Luna API降价80%;次日,评论区即有人贴出DeepSeek对比图,亦有用户留言感谢中国大模型,“正是中国模型让OpenAI开始紧张”,这对开发者而言无疑是利好。
不少个人开发者也坦诚表达对DeepSeek的好感:不仅因价格亲民,更因响应迅捷、交互流畅,整体使用体验“极为顺滑”。
华尔街分析师观点则略显分化。乐观派认为,DeepSeek掀起的价格竞争正加速AI应用落地,显著降低全球创新门槛;悲观派则担忧长期价格战可能压缩全行业利润空间,削弱企业持续投入模型研发的财务基础。
DeepSeek所划定的这条性价比斩杀线,本质上代表两种全球大模型发展路径的正面交锋。
其一是以硅谷巨头为代表的路径:重金投入闭源旗舰模型训练,维持较高毛利率,重心锚定大型企业客户,依赖高价值ToB订单盈利,优先冲击技术能力上限,对普惠开发者市场的价格调整反应相对迟滞。
其二是以DeepSeek为代表的路径:通过工程优化极致压缩推理成本,兼顾开源生态建设与云端商业化服务,坚持薄利多销策略,优先抢占开发者心智,借规模效应摊薄边际成本,以高性价比快速扩大全球市场份额。
两条路径并无绝对优劣之分,但DeepSeek的崛起印证了一个核心事实:大模型竞争早已不止于比拼烧钱能力。算力投入只是入场券,推理效率、商业化定价能力与生态协同策略,同样具备改写市场格局的力量。
这场由性价比驱动的全球大模型格局重构远未终结。价格博弈只是序章,接下来,模型能力迭代节奏、全球化服务能力覆盖、本地化合规解决方案,以及可持续的商业化盈利模式,才是真正决定谁能长期立足的关键战场。就在本周一(8月3日),MiniMax正式开源通用视频大模型H3,意图在多模态领域复刻DeepSeek的成功路径;同日,阿里巴巴千问Qwen3.8-Max大模型正式发布,总参数量达2.4万亿,系Qwen家族迄今最强版本,模型权重将于下周开放开源。
对全球数百万AI开发者而言,最直观的变化已然发生:可选项更丰富、使用成本更低、创新的门槛,正在被持续拉低。
本文来自微信公众号“凤凰网科技”,作者:Dale,36氪经授权发布。












