


从跳舞到干活的距离:机器人到底缺了什么?
机器人,不该再跳舞
今年四月的北京亦庄,一场马拉松改写了机器人速度的边界。
一台名为"闪电"的人形机器人,以50分26秒的净时成绩冲过了半程马拉松终点线——这个数字,比乌干达名将基普利莫,在今年3月在里斯本创造的人类男子半马世界纪录,整整快了7分钟。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
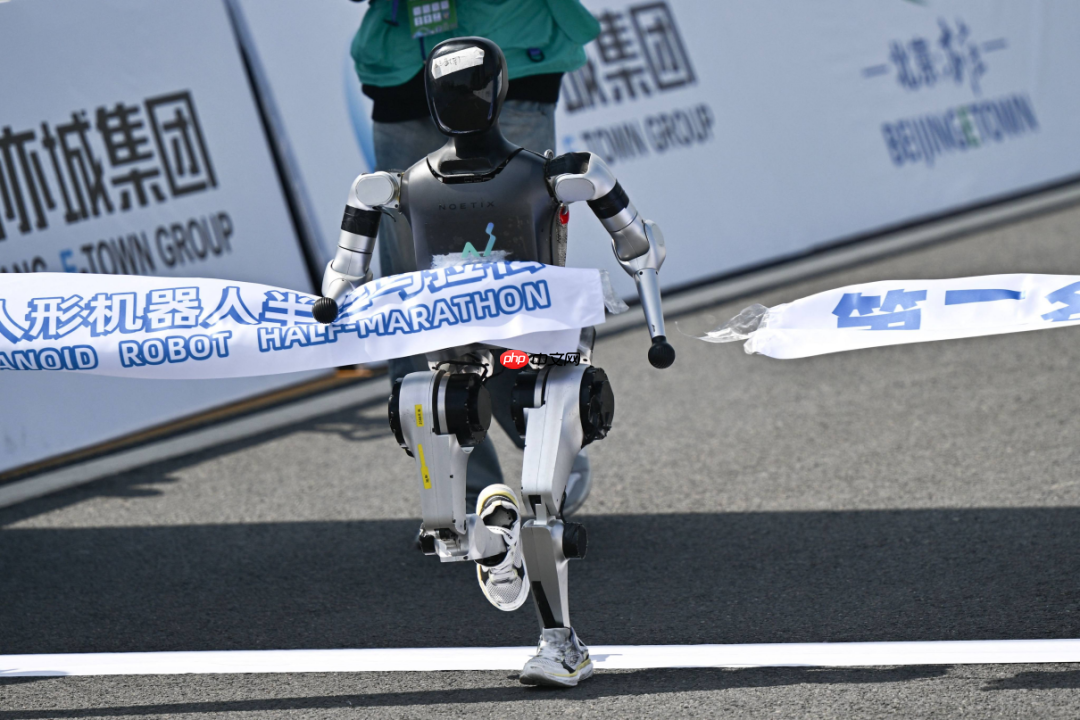
然而,赞叹之余,人们不禁要问:人形机器人这股风刮了这么久,我们看到了它们跳舞、翻跟头、跑马拉松,甚至上春晚,但什么时候,它们才能真正地"干活"?
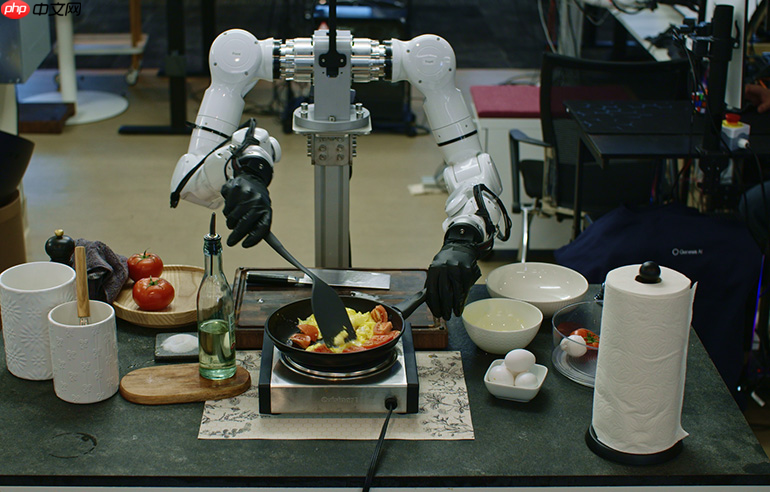
前几天,这个问题有了个突破性的答案:5月7日,华人机器人创业公司Genesis AI发布了首个机器人基础模型GENE-26.5,视频里的机器人完成了一连串丝滑的演示:单手打鸡蛋、双手配合切番茄、使用盐磨和打蛋器、用铲子翻炒蛋液,甚至打完鸡蛋后还会用毛巾擦手。
这个4分钟的长时序任务包含了20多个子任务,全程自主运行,1倍速展示,没有任何加速效果。最让人惊叹的是一个细节:在转移切好的番茄时,机器人不是简单地把刀当成铲子,而是用刀背和砧板形成支撑,再通过双手协同把番茄转移出去——这个动作已经和人类的操作方式几乎没有区别。
Genesis AI官方毫不讳言,这套系统的核心不是什么神奇的算法,而是数据。
GENE-26.5背后是超过20万小时的跨模态数据,包括高保真手套数据捕捉的手部动作和触觉信号、第一视角视频记录的人类自然操作、以及第三人称视频提供的大规模物理互动覆盖。
同样地,数据的重要性,在最近的红杉AI Ascent 2026大会上,得到了英伟达机器人方向负责人Jim Fan的最强背书。在会上,Jim Fan坦言:遥操已死,人类的传感器数据将长存。
几乎在同一时间,太平洋彼岸的中国厂商们,已经在数据这条赛道上悄悄下了重注。截至2026年,光轮智能已经交付了150万小时的机器人训练数据;智元机器人依托其自建的4000平方米数据采集工厂,累计采集了超过百万条高质量真机数据,并发布了全球首个百万级真机数据集AgiBot World;而宇树科技更是在今年4月,直接开源了189万条来自G1真机的动作数据,震惊了整个行业。
说白了,中美两国的头部玩家,都已经意识到,在当下人形机器人的竞争中,数据已经成了关键的变量,这场战争的胜负,将在未来数年内,决定整个行业的权力结构。
数据之重
很多人觉得,对于机器人而言,模型和算法框架才是最重要的。
但实际上,今天无论是VLA、Diffusion Policy还是模仿学习,都已经变成了行业的通用基础设施。中美两国的学术界和工业界,几乎在同一时间掌握了这些核心框架。算法的同质化,意味着单纯靠模型创新拉开差距的时代已经结束了。
但数据这个天花板,却因为真实世界的物理限制,成为了木桶上那块最短、也最难补齐的木板。你可以在一周内复现别人的模型,但你不可能在一周内积累别人花了三年时间采集的百万小时真机数据。
并且,在同样的算法、模型框架下,数据带来的"涌现"效果,往往是拉开差距的唯一关键。
一个具体的例子是:来自蚂蚁数科和宇树科技今年2月合作的一个实验。他们的任务简单到不能再简单:让一台G1机器人走到电脑前,伸手按下机箱上的电源键。
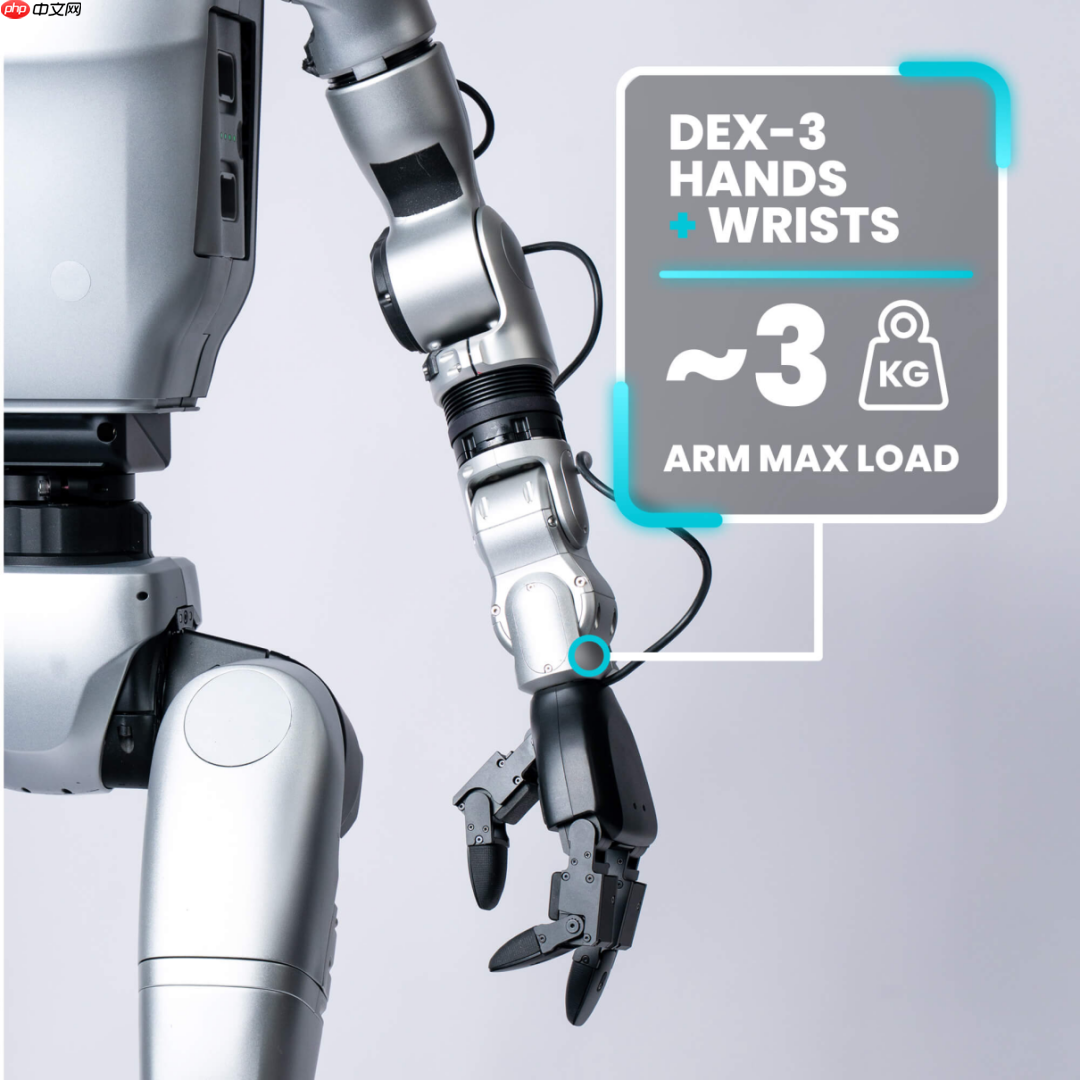
一开始,所有人都觉得这是个小儿科的任务。但实际测试的结果却让人大跌眼镜:连续100次测试,成功率只有45%。
问题出在哪里?问题出在机器人总是按歪——要么按到了旁边的USB接口,要么按到了机箱的边缘;要么力度太轻,按不下去;要么力度太重,直接把整个机箱推得往后滑。最搞笑的一次,机器人的手指卡在了电源键和机箱的缝隙里,拔不出来了。
工程师们尝试了所有能想到的办法:调整关节力矩、优化视觉识别精度、增加力反馈阈值……但折腾了一个星期,成功率最多也就提升到52%。
最后,他们放弃了所有算法上的"小聪明",转而用最笨的办法:让真人用一台手机+20美元颈挂支架,用不同的力度和角度,反复按同一个电源键,一共采集了200条完整的真机操作数据。
然后,奇迹发生了。
再次测试,同样的100次任务,成功率直接从45%跳到了95%。没有任何算法上的重大突破,没有任何硬件上的升级,仅仅是多了200条真实世界的数据,机器人的表现就发生了质的飞跃。
这就是数据的魔力。它不是在原有基础上的线性提升,而是一种指数级的质变。同样的硬件,同样的算法,多一倍的数据,可能就意味着多一倍的任务成功率,多一倍的泛化能力,
这个差距,一旦拉开,就很难追上。
路线之争
既然数据这么重要,那么我们到底需要什么样的数据?
简单来说,在这个问题上,当下的机器人行业,大致分成了两大路线。
一派是以英伟达为首的“仿真派”,他们信奉算力至上。依托Omniverse这样的数字孪生平台,他们在虚拟世界中构建出与真实世界物理规则完全一致的平行宇宙,让数百万台虚拟机器人在里面进行亿万次的试错和训练。
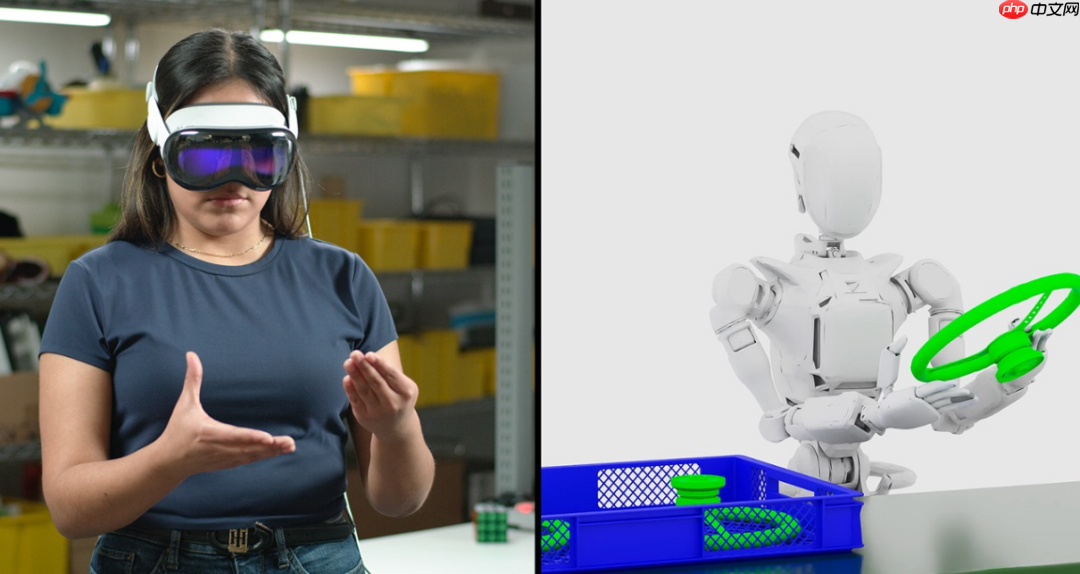
仿真派的优势显而易见:成本低、速度快、可无限规模化。但致命弱点也很突出:仿真永远存在“现实鸿沟”。无论你的物理引擎多么先进,你永远无法模拟出一块沾了油的抹布的摩擦力、一个有点变形的纸箱的承重能力,这些在人类看来微不足道的细节,在仿真中被无情地简化掉了。
另一派则是以中国厂商为代表的“真机派”,他们建数据工厂、铺机器人本体、让人类穿戴设备亲自操作,在真实的物理环境中,一寸一寸地采集每一个动作、触摸、碰撞的完整数据。
真机派的优势是包含了真实的力矩反馈、触觉阵列信号、碰撞轨迹和环境扰动。但它的劣势,却是成本相对高昂、采集极慢、资产极重。一台人形机器人本体动辄十万以上,一个中型数据工厂的建设成本上千万。
从总体上来看,两派经过一段时间的较量,已经大致分出了高下,斯坦福大学在今年4 月发布的《2026 AI Index Report》中,用一组冰冷的数据击碎了所有 "仿真万能论" 的幻想:在最理想的实验室条件下,一个在仿真环境中能达到 89% 任务成功率的机器人,一旦放到真实世界中,成功率会断崖式下跌到 12%。
这样的差距,就是横亘在仿真派面前的 "现实鸿沟"。
所以,现在即使是美国,也意识到了真机数据的重要性,只不过,他们做的并不是"重资产的真机数据",而是用全球劳动力成本洼地(印度、尼日利亚、阿根廷)+ 零工平台(Gig Economy)+ 自带设备(iPhone),走了一条"轻资产、高扩展"的人类传感器采集路线。
而这样的形态,实际上采集的是"人"的数据,不是"机器人"的数据。工人叠衣服的视频,记录的是人手的动作、人眼的视角。
中国也在转向人类传感器数据,但中国的优势在于:我们同时有"人类穿戴采集"和"产线嵌入采集"两种形态,而且后者是制造业场景自带的。
同一个技术判断,两种不同的组织形态。 这成了数据之争最隐蔽的变量。
投资悖论
尽管中美都将主力转移到了真机路线上,但是在具体投入上,手握全球最雄厚风险资本的美国,最终选择了轻资产的众包数据路线;
而资本体量远不及美国的中国,却义无反顾地押注了重资产的真机工厂路线。
美国的风投资金,把钱投给Scale AI、Micro1这样的众包平台,用15美元时薪招募全球零工,让他们把iPhone绑在额头上录制家务视频。这是一个“四两拨千斤”的故事:不需要建工厂、不需要买机器人、不需要养团队,只需要一个App和一个全球零工网络。
像是Generalist这个数据众包平台,现在全球注册零工已经超过了230万人,号称每天能生成超过10万小时的人类操作数据。
但问题是,这个模式有个致命缺陷:众包数据看起来便宜,实则暗藏着高昂的“标注税”和“清洗税”。
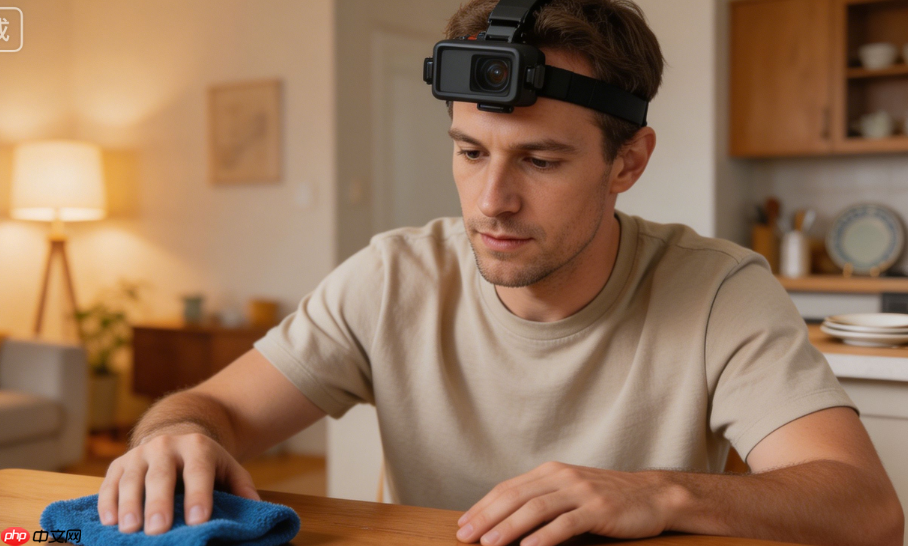
根据MIT Technology Review的报道,这些众包数据,只有约一半的视频能通过质量检查。
为什么?
因为这些视频缺乏力觉、触觉等机器人训练的核心传感器数据。你看到的是画面,但机器人需要知道的是:手指用了多大的力?
要让这些视频真正用于训练,需要大量的后期标注与处理。标注每一帧的动作类别、物体位置、接触关系——这笔"标注税",往往比采集本身更昂贵。
反观中国,虽然整体资本体量不如美国,但却走出了一条完全不同的道路。将真金白银地砸向了数据工厂、机器人本体和穿戴式采集设备。
这种“正规军”的打法,好处是通过工业级质控体系,让数据有效率差出几十个百分点,并且通过高度一致的采集硬件与规格,让人类采集的数据可以几乎无损地迁移到机器人身上。省去了原本需要大量人工干预的标注、清洗、格式转换工作。
举个例子,在北京亦庄的人形机器人数据基地,就覆盖了家居、商超、办公、工业、医药、30多个典型应用场景,并配有约200平方米专业光学动作捕捉场地。基地内有120多台不同构型机器人,配备头环式、夹爪式采集设备、动捕服、动捕手套。
这样的采集规模、质控,远不是美国那种靠众包零工头上绑摄像头的方式能比得了的。
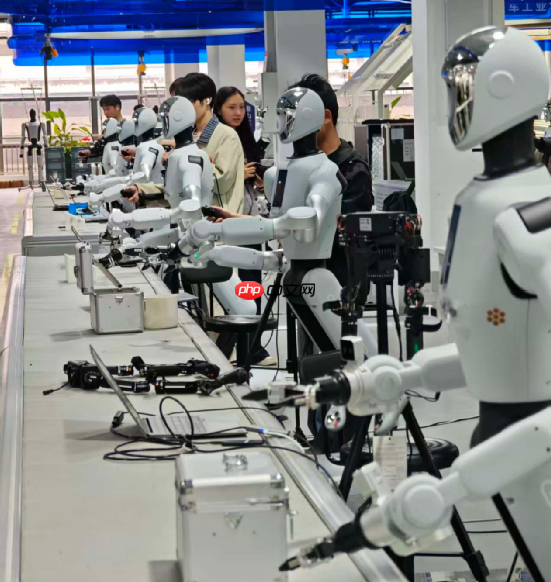
这类基地经过几个月打磨后,内部质检合格率可提升到约95%。
虽然在“人类传感器采集路线”上,中美都不需要高昂的机器人本体了,但真正的成本,已经从机器人本体,转移到了采集设备标准化、场景组织、数据清洗标注方面。
但对中国来说,这种看似“重资产”的路线,由于规模化,以及工业级质控的优势,成本还是被打下来了。
因为在新一代人类传感器路线里,真正差距的,已经不仅仅是不在“能不能便宜采”,而在“谁能把便宜采来的原始数据,变成模型真正吃得下的有效数据”。
于是,一个非常讽刺的局面出现了:美国虽然拥有全球最多的风险资本,但却投不出中国这样的真机数据规模。因为产业空心化,只能去第三世界找零工用摄像头来采集。
而由于采集设备的单一、简陋,加上零工的不专业,美国的真机路线只能走“低技术、低质量、碎片化”的众包道路,永远无法达到中国这样的工业化量产级别。
结语
如果从行业终局的角度,观察当下机器人的数据竞争,你会发现人形机器人的竞争本质上是一场关于“不可能三角”的博弈。
在任何一个给定的时间点,没有任何一家公司能够同时做到硬件最强、算法最优、数据最多——你只能强两头,必然弱一头。
过去十年,是硬件的时代。波士顿动力在硬件运动控制上做到了极致,它的Atlas能跑能跳能后空翻,但它弱在算法和数据,只能在实验室里完成预设动作,至今无法走进真实世界。
过去三年,是算法的时代。VLA模型的爆发让所有人看到了通用机器人的希望,但算法的护城河是最脆弱的。一篇论文、一次开源,就能让几个月的差距瞬间磨平。
而未来三到五年,唯一真正的、不可逾越的护城河,正在数据领域悄然形成。
更重要的是,数据会形成自我强化的飞轮:而在这一点上,中国比美国拥有无可比拟的优势。
中国拥有全球最丰富、最多样化的制造业场景,从3C电子的精密组装到汽车制造的焊接喷涂,从物流仓储的搬运分拣到餐饮服务的上菜收盘,无数的工厂和企业愿意为人形机器人提供试错的机会,
同时,得益于中国制造业的强大优势,人形机器人的生产成本远低于美国,这使得中国机器人产品,在人力成本高昂的国家具备显著的出口竞争力。
以智元机器人为例,其积极布局海外市场,2026年海外销售目标占比已超过30%。机器人价格的降低,促进了出口量的增长和应用场景的拓展,进而收集到更多真实世界的数据,这些数据又反哺算法迭代,进一步提升性能并降低成本,形成了一个强大的正向循环。
现在,这场人形机器人的数据之战才刚刚打响。
而历史已经证明,当一场技术革命进入到工业化落地的阶段时,拥有最完整产业链、最丰富应用场景、最强大制造能力的国家,往往会笑到最后。
本文来自微信公众号 “星海情报局”(ID:junwu2333),作者:星海老局,36氪经授权发布。















