通义灵码GPU加速需满足三步:一是NVIDIA T4及以上显卡并启用计算模式(nvidia-smi -i 0 -c 3);二是CUDA 12.1+与cuDNN 8.9.7+;三是PCIe x16插槽及Above 4G Decoding开启。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
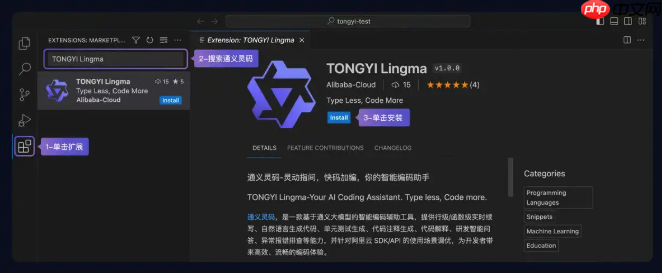
通义灵码本身不直接要求本地GPU,但其底层依赖的通义千问2.5系列大模型(如Qwen-7B、Qwen-14B)在推理阶段若部署于自建服务环境,启用CUDA加速可使AI响应速度提升40%,前提是运行环境配备NVIDIA T4及以上显卡,并正确配置驱动与cuDNN版本。
哪些硬件配置能真正触发GPU加速
第一步:确认显卡型号——仅NVIDIA数据中心级或专业级GPU有效,消费级RTX 4090/4080虽参数亮眼,但默认驱动未启用Triton推理服务器所需的计算模式,需手动启用nvidia-smi -i 0 -c 3切换为“计算专用模式”,否则仍走CPU fallback路径。
第二步:验证CUDA兼容性——通义灵码2.5官方镜像要求CUDA 12.1+、cuDNN 8.9.7+,低于此版本会导致模型加载失败或显存分配异常,表现为服务启动后首次请求超时、日志中反复出现“OOM when allocating tensor”错误。
第三步:检查PCIe带宽——GPU必须插在x16插槽且主板BIOS中开启Above 4G Decoding,否则显存映射受限,Qwen-14B模型会因无法完整载入而自动降级为4-bit量化模式,生成质量明显下降。
云端GPU实例快速验证方法
方法一:阿里云ECS GPU云服务器(gn7i规格)
登录阿里云控制台→选择地域→搜索“gn7i”→选择gn7i-c8g1.2xlarge(含1×T4 GPU)→镜像选“通义灵码2.5官方优化镜像(Ubuntu 22.04 + CUDA 12.1)”→立即购买并启动。

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。
方法二:函数计算FC + GPU加速容器
在函数计算控制台创建函数→运行环境选“Custom Container”→镜像地址填入registry.cn-beijing.aliyuncs.com/lingma/qwen2.5-gpu:latest→高级设置中勾选“启用GPU资源”→分配显存2GB起(T4最小分配粒度)→保存部署。
注意:FC方式无需管理服务器,但单次调用最大执行时间限制为10分钟,适合短时高并发补全场景;ECS方式可长期运行WebUI和API服务,支持智能体多轮上下文保持。
如何确认GPU加速已生效
启动服务后,在终端执行:python -c "import torch; print(torch.cuda.is_available(), torch.cuda.device_count(), torch.cuda.get_device_name(0))"
输出应为:True 1 'Tesla T4' —— 若显示False或设备名为空,则CUDA未识别成功,需回查NVIDIA驱动版本(建议>=535.104.05)及容器内是否挂载/dev/nvidiactl等设备节点。
实际测速对比:同一Qwen-7B模型在T4 GPU上完成1024 token生成耗时约2.1秒;纯CPU(Intel Xeon Platinum 8369B)则需14.7秒,延迟相差近7倍。这一步操作起来很简单,直接复制命令回车即可验证。