


Keepalived 高可用依赖 VRRP 协议和健康检查脚本(vrrp_script + track_script),而非监听进程信号;通过脚本探测服务状态并动态调整优先级,触发 VIP 漂移。
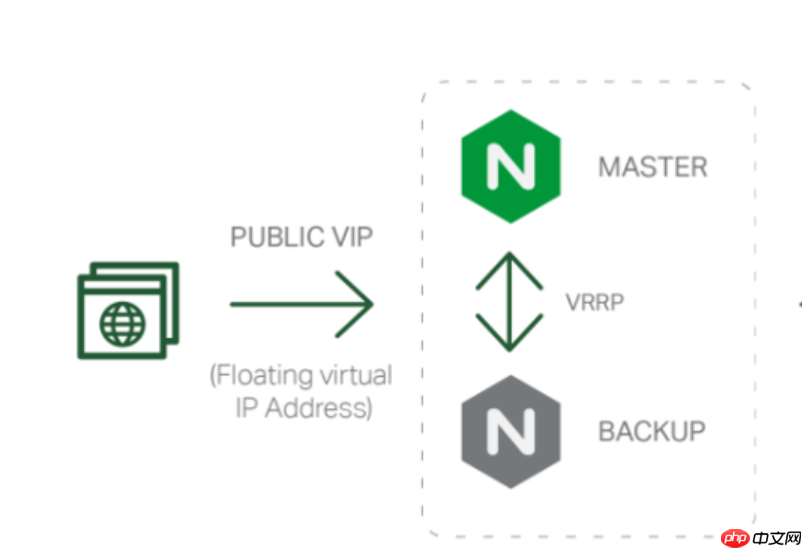
Keepalived 本身不依赖“Master 进程信号”来实现高可用,它的核心机制是 VRRP 协议和健康检查模块(Checkers),而非监听或响应操作系统级的进程信号(如 SIGHUP、SIGUSR1 等)。所谓“利用 Master 进程信号构建高可用监控”,是一种常见误解——实际落地中,真正起作用的是 Keepalived 的 vrrp_script + track_script 机制,配合外部服务状态探测脚本,而非直接捕获或转发进程信号。
Keepalived 不靠信号,靠脚本探测真实服务状态
Keepalived 主进程(master)启动后,会持续运行 VRRP 协议栈与 Checkers 模块。它不会监听 nginx、haproxy 或 kube-apiserver 的进程信号,而是通过你定义的 shell 脚本主动检测:
- 脚本每几秒执行一次(由
interval控制) - 脚本返回 0 表示服务健康,非 0 表示异常
- 一旦连续失败,Keepalived 自动降低自身优先级(
weight -20),触发 VRRP 投票重选,VIP 切换
例如检测 HAProxy 是否存活:
/etc/keepalived/check_haproxy.sh#!/bin/bash if ! timeout 2 curl -s http://127.0.0.1:10248/healthz > /dev/null; then exit 1 fi # 或更稳妥:检查进程 + 端口 + 健康接口三重验证 if ! pgrep -x "haproxy" > /dev/null || ! ss -tln | grep -q ":6443"; then exit 1 fi exit 0
为什么不能直接监听 Master 进程信号?
操作系统信号(如 SIGTERM)是发给单个进程的,而 Keepalived 的高可用逻辑必须跨节点协同。即使你在本地 kill -USR2 keepalived 主进程,也只能影响当前节点,无法通知对端 Backup 节点切换 VIP——这违背了高可用设计原则。VRRP 的心跳(组播/单播)才是跨节点通信的可靠通道。
- VIP 漂移决策基于 VRRP 状态机,不是信号触发
- 节点角色(MASTER/BACKUP)由 priority + VRID + 心跳超时共同决定
- 信号只能用于本地调试(如
kill -USR1 $(pidof keepalived)查看日志级别),不可用于生产联动
企业级联动的关键:把“服务状态”映射为“VIP 权重变化”
在 Kubernetes HA 场景中,典型做法是让 Keepalived 监控本地 kube-apiserver 的健康度,而不是监听其进程信号。例如:
- 脚本调用
curl -k https://localhost:6443/healthz验证 API Server 可用性 - 若返回非 200 或超时,脚本退出码为 1 → Keepalived 执行
weight -30 - 该节点 priority 从 100 降为 70,低于 Backup 节点的 90 → VIP 自动漂移到 Backup
- 原节点恢复后,脚本返回 0 → priority 恢复 → 若配置为抢占模式(
nopreempt关闭),VIP 回切
这种设计解耦了“进程生命周期”和“服务可用性”,避免因进程卡死、goroutine 僵尸但 PID 仍在导致误判。
进阶建议:用 systemd 事件补充脚本盲区
某些极端情况(如 keepalived 进程被 OOM killer 杀掉、磁盘满导致 fork 失败),脚本可能来不及执行就已退出。此时可结合 systemd 的 ExecStopPost 或 RestartSec 做兜底:
- 配置
Restart=always+RestartSec=5,确保 Keepalived 自身崩溃后快速拉起 - 在
ExecStopPost=/usr/local/bin/notify-vip-failover.sh中发送告警或清理残留 VIP - 但注意:systemd 重启 ≠ VIP 切换,仍需依赖 VRRP 心跳由对端接管
本质上,Keepalived 的高可用不是靠“信号接力”,而是靠“状态共识”。它把每个节点变成一个带投票权的观察员,用脚本做眼睛,用 VRRP 做神经网络,最终让 VIP 始终落在真正健康的节点上。











