


知名人工智能企业 stability ai 近日隆重推出其全新一代音频大模型
此次发布的模型系列覆盖轻量级至高性能多个版本,可灵活适配音乐制作、影视音效设计及互动媒体开发等多样化应用场景。尤为突出的是,模型原生支持任意时长音频生成,并集成了基于内补成像(inpainting)原理的智能音频编辑能力,极大拓展了内容创作的自由度与精准度。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
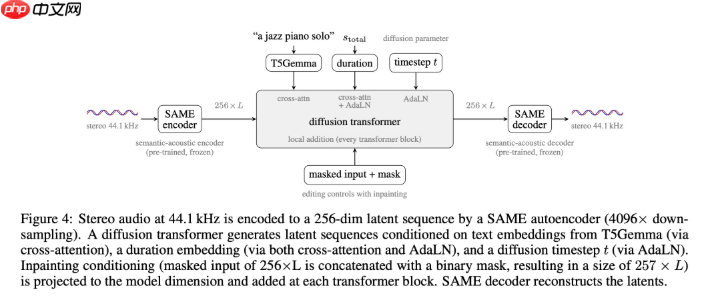
架构革新突破算力瓶颈
依托这一高密度压缩机制,模型可在主流消费级设备上稳定完成长时间、高复杂度的音频合成任务。这不仅大幅降低了专业级音频内容生产的硬件门槛,也让独立创作者在普通工作环境中实现广播级音质输出成为现实。
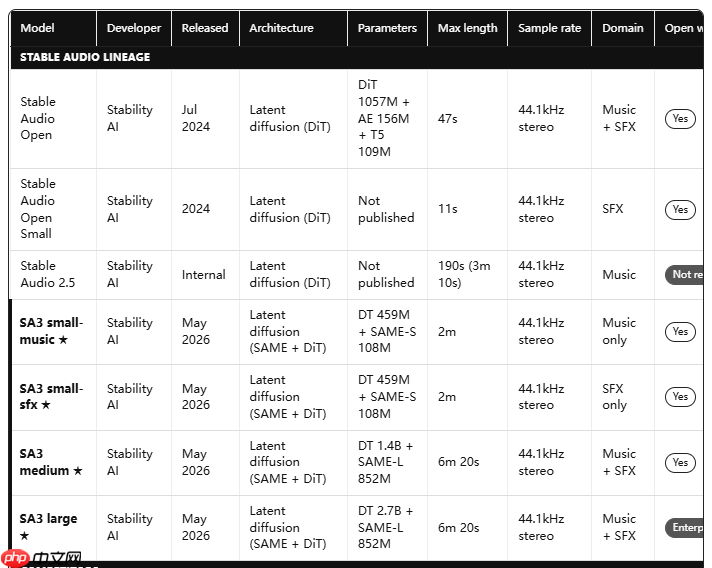
毫秒级响应重塑创作流程
借助 variable-length 动态建模技术,新模型可根据用户指定的音频时长实时调节计算资源分配,有效规避传统固定长度模型中存在的冗余运算问题。实测数据显示,在高端GPU环境下,仅需约0.62秒即可生成20秒高质量音频;而长达380秒的完整乐曲合成,也仅耗时1.31秒。
同时,通过独创的三阶段渐进式训练范式,















