


清华大学存储实验室携手腾讯混元ai infra团队近日共同宣布,于国际机器学习系统领域权威会议mlsys2026所主办的moe模型推理优化挑战赛中摘得全球桂冠。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
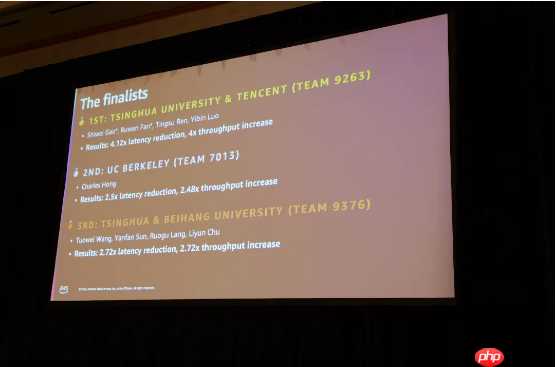
在万亿参数规模日益普及的背景下,混合专家(MoE)架构于异构加速芯片(NPU)上的推理效率遭遇显著瓶颈。为此,联合团队围绕赛事指定模型与目标NPU硬件,构建了一套端到端协同优化体系。方案创新性地提出面向专家粒度的双核任务划分策略——E-Shard;采用PSUM三维张量批量读取机制;设计输出结果分散至多个Memory Bank并行处理的GEMV执行路径;并借助标量计算单元前置介入,有效压缩初始数据搬运延迟。这一系列技术组合精准击中了数据搬运低效、中间激活重复加载等底层算子核心痛点。
此外,在注意力机制层面,团队重新规划片上内存数据排布,并深度耦合Transformer关键算子,达成比特级精度对齐,进一步释放硬件潜力。
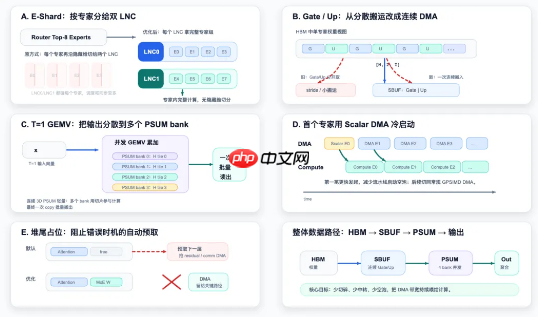
图3:MoE 优化结构示意图,涵盖E-Shard专家切分、连续DMA传输、PSUM/GEMV并发执行、冷启动流水线及预取控制机制。
本次竞赛中,双方还联合打造了基于智能体(Agent)架构的推理算子自动优化器“Knight”。该工具打通方案设计、代码生成与效果复盘的全流程闭环,显著扩大了可行优化策略的探索边界。实测结果显示:模型端到端推理耗时由14.91秒压缩至3.56秒,整体性能提升达4.1倍;单步解码延迟从12.63毫秒降至5.45毫秒;权重加载阶段DMA引擎利用率跃升至约80%。
力克斯坦福大学、麻省理工学院等世界顶尖高校代表队夺冠,不仅印证了我国科研团队在大模型底层系统适配与硬件感知算子优化方面的扎实功底,更为核心超大规模算力节点部署万亿参数MoE模型提供了可复用、可扩展的工程实践样板。














