


$upstream_addr能真实反映Nginx实际转发行为,仅在proxy_pass成功建立上游连接后填充IP:Port,支持重试多地址记录,结合配置策略与后端响应头可精准验证节点落点是否符合预期。
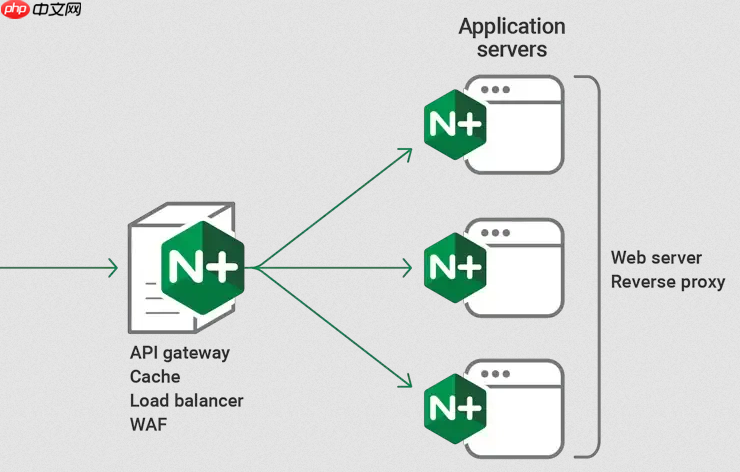
直接看日志里 $upstream_addr 的值,再比对你的 upstream 配置和实际期望的转发逻辑,就能判断请求是否真落到了该去的节点——它不是配置里的“可能”,而是 Nginx 实际连上的“已经发生”。
确认 $upstream_addr 是否真实反映转发行为
$upstream_addr 只在 proxy_pass 成功建立上游连接后才有值。如果为空或为 “-”,说明请求根本没发出去(比如 DNS 解析失败、upstream 名称写错、健康检查全挂等),此时谈“是否落入预期节点”没有意义。
- 有值且格式为 IP:Port(如 10.0.1.5:8000),说明连接成功,地址就是实际通信节点;
- 有多个值用逗号分隔(如 10.0.1.5:8000, 10.0.1.6:8000),说明发生了重试,第一个是首选,后续是 fallback;
- 若你用了 hash $request_id 或 ip_hash 等一致性策略,但 $upstream_addr 频繁变动,就要查是否后端节点被动态摘除、或哈希键(如 $request_id)本身不稳定。
比对 upstream 配置与日志记录是否一致
不要只看配置写了哪些 server,要验证 Nginx 是否真的按你设想的规则选中了目标节点。

- 比如配置中指定了 server 10.0.1.10:8080 weight=3 和 server 10.0.1.11:8080 weight=1,那么在大量请求日志中,前者 $upstream_addr 出现频次应约为后者的三倍;
- 若启用 ip_hash,同一客户端 IP 的多次请求,$upstream_addr 应始终固定(除非该节点已下线);
- 若用了 least_conn,可结合 $upstream_response_time 和 $upstream_addr 统计各节点当前连接数倾向——响应快、负载低的节点应更常出现在日志中。
借助后端返回头交叉验证
光靠 Nginx 日志还不够闭环。让后端服务在响应中带上唯一标识(如 X-Backend-ID 或 X-Node-Name),再和 $upstream_addr 对照,就能确认“Nginx 说它发给了 A,后端 A 也承认收到了”。
- 例如后端在响应头中返回 X-Backend-ID: be-a,而日志中 $upstream_addr 是 10.0.1.10:8080,再通过 map 指令把该地址映射为 be-a,二者一致即验证成功;
- 若出现 $upstream_addr 是 10.0.1.10:8080,但响应头里 X-Backend-ID 是 be-b,说明代理链路错位(比如中间还有一层反代未透传,或后端做了二次转发);
- 这种头透传建议用 proxy_set_header X-Forwarded-For $remote_addr; + 后端主动读取并回写标识,避免伪造。
排查常见“看似落入、实则异常”的情况
有些场景下 $upstream_addr 显示正常,但业务仍出问题,需进一步深挖:
- 地址正确但状态码异常(如高频 502):检查 $upstream_status 是否对应匹配,比如 $upstream_addr=10.0.1.10:8080 且 $upstream_status=502,基本锁定该节点进程崩溃或端口未监听;
- 地址正确但响应极慢:看 $upstream_response_time 是否远高于均值,同时确认该节点资源(CPU、内存、数据库连接池)是否打满;
- 地址正确但偶发失败:开启 proxy_next_upstream error timeout http_502,并观察重试路径中是否总是绕不开某台机器(如每次重试第二跳都是它),说明它是 fallback 中的“最后一道关卡”,也是最脆弱的一环。













