


从最初的imagenet图像分类任务,到如今蓬勃发展的扩散模型,计算机视觉在过去十年间始终围绕一个核心目标展开:赋予机器“看见并理解世界”的能力。然而,当感知精度逐步逼近人类水平,单纯提升准确率所带来的增益正日益减弱。在cvpr2026上,视觉智能的研究重心迎来关键跃迁:视觉本身不再被视为终极目标,而是成为支撑推理、决策与人机交互的底层桥梁。
摒弃“无差别推理”:走向动态适配与潜空间推演
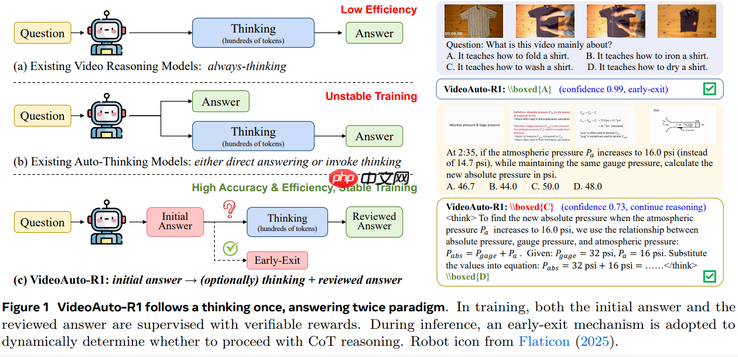
长久以来,多模态大模型普遍采用“思维链”(Chain-of-Thought, CoT)作为默认推理路径。但前沿工作揭示,这种“逢问必推”的策略存在显著冗余。以VideoAuto-R1为例,其提出的“按需激活推理”机制主张:对直观感知类问题直接输出结果,仅在涉及因果判断、时空推理等高阶任务时才启动推理模块。实证表明,该策略在不牺牲性能的前提下,将平均响应长度压缩了3.3倍。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
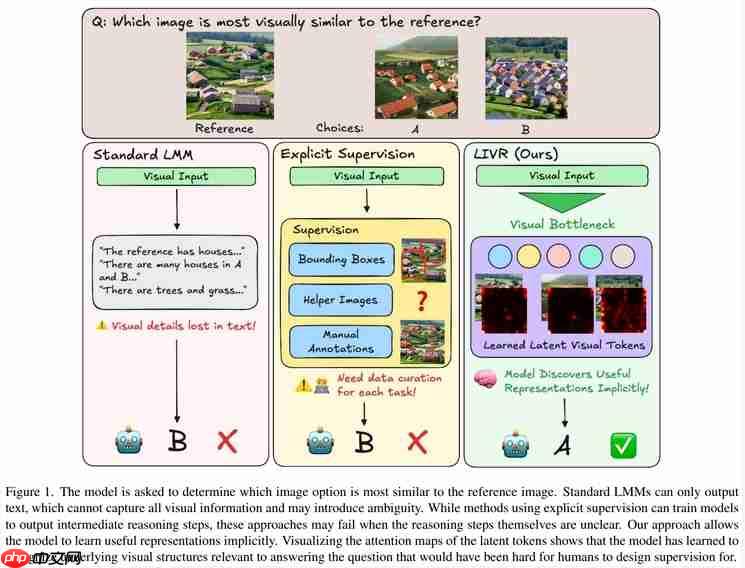
与此同时,推理的载体也在悄然转变。传统方法高度依赖语言化描述来建模空间关系,在处理拼图复原、几何构型分析等任务时频频受限。新兴范式则推动模型在“潜在表征空间”中完成端到端的隐式视觉推理——跳过显式文本转译,更贴合人类对复杂视觉结构的直觉式理解。
评估范式革新:戳破“选择题幻觉”
当前主流视觉语言模型评测仍大量依赖多项选择题(MCQA),但此类方式正被质疑掩盖真实能力短板。研究表明,模型常借助选项间的语义冲突、统计偏差或上下文线索实现“伪正确”,实际理解力可能被高估约20%。为此,学界正加速构建“可验证开放问答”(Verifiable Open-ended QA)新标准,要求模型必须生成可被图像证据直接支撑的答案,杜绝投机行为。
评测场景亦同步升级,由静态单图向多智能体协同环境延伸。VS-Bench等新一代基准强调模型需在合作博弈、资源竞争、角色分工等动态交互中,持续完成环境感知、意图识别与策略规划。这标志着视觉智能正加速脱离“被动观察者”定位,迈向具备主动判断与行为能力的“智能协作者”。
底层支撑强化:开源纵深拓展与真实数据奠基
模型生态层面,开源实践正迈向更高维度的透明性。Molmo2等新一代开源模型不仅释放全部参数权重,更完整公开训练数据构成、清洗逻辑与优化轨迹。其能力边界已突破单帧图像,覆盖长时序视频理解,并集成像素级定位能力,真正实现从“识别对象”到“指出位置”的质变跨越。
而这一切进化的根基,在于数据基础设施的实质性补强。面向文本驱动图像编辑任务,Pico-Banana-400K等超大规模真实场景数据集应运而生,有效扭转了此前严重依赖合成数据的失衡局面。该数据集涵盖多轮迭代编辑、用户偏好标注与操作合理性标注,为训练兼具常识判断力与逻辑连贯性的编辑模型提供了坚实支撑。
综观全局,视觉智能正处于历史性拐点:它正由孤立的感知模块,升维为贯通感知输入、认知加工与行动输出的统一智能体。这一演进绝非局部优化,而是涵盖推理架构、评估逻辑与数据供给的全栈式重构。












