





数据样本
date = [
 { "study_time": 1, "salary":  350, "absences": 5, "city": "san francisco" },
 { "study_time": 2, "salary": 1600, "absences": 4, "city": "london" },
 { "study_time": 3, "salary": 2450, "absences": 3, "city": "paris" },
 { "study_time": 4, "salary": 5150, "absences": 5, "city": "san francisco" },
 { "study_time": 5, "salary": 5800, "absences": 4, "city": "london" },
 { "study_time": 6, "salary": 6050, "absences": 3, "city": "paris" }
]
这些值的估计工资是多少?
{ "study_time": 13, "salary": ???, "absences": 5, "city": "san francisco" }
结果
使用多项式回归这个序列的值13将是:24814
但正确的值是:19550
错误:5264
如果我预测位置 49 它将是:182441
但正确的值是:77150
错误:105291
这是产生级数的“隐藏算法”:
x = 0
absences_base = 50
salary_base = 1000

data = []

for i in range(50):
    if x == 0:
        x += 1
        data.append({
            "study_time": i + 1,
            "salary": (i * salary_base + (300 * 2 * (i + 1))) - (5 * absences_base),
            "absences": 5,
            "city": "san francisco"
        })
    elif x == 1:
        x += 1
        data.append({
            "study_time": i + 1,
            "salary": (i * salary_base + (200 * 2 * (i + 1))) - (4 * absences_base),
            "absences": 4,
            "city": "london"
        })
    else:
        x = 0
        data.append({
            "study_time": i + 1,
            "salary": (i * salary_base + (100 * 2 * (i + 1))) - (3 * absences_base),
            "absences": 3,
            "city": "paris"
        })

for entry in data:
    print(entry)
{'study_time': 1, 'salary': 350, 'absences': 5, 'city': 'san francisco'}
{'study_time': 2, 'salary': 1600, 'absences': 4, 'city': 'london'}
{'study_time': 3, 'salary': 2450, 'absences': 3, 'city': 'paris'}
{'study_time': 4, 'salary': 5150, 'absences': 5, 'city': 'san francisco'}
{'study_time': 5, 'salary': 5800, 'absences': 4, 'city': 'london'}
{'study_time': 6, 'salary': 6050, 'absences': 3, 'city': 'paris'}
{'study_time': 7, 'salary': 9950, 'absences': 5, 'city': 'san francisco'}
{'study_time': 8, 'salary': 10000, 'absences': 4, 'city': 'london'}
{'study_time': 9, 'salary': 9650, 'absences': 3, 'city': 'paris'}
{'study_time': 10, 'salary': 14750, 'absences': 5, 'city': 'san francisco'}
{'study_time': 11, 'salary': 14200, 'absences': 4, 'city': 'london'}
{'study_time': 12, 'salary': 13250, 'absences': 3, 'city': 'paris'}
{'study_time': 13, 'salary': 19550, 'absences': 5, 'city': 'san francisco'}
如何预测准确值?
多项式回归是一种统计技术,可用于建模和预测两个变量之间的关系。然而,在这种涉及多个变量(学习时间、工资、缺勤和城市)的情况下,多项式回归可能不足以捕获时间序列中的所有模式。
所讨论的问题是时间序列的经典示例,我们需要根据过去观察到的模式来预测未来值。
这个问题可以通过机器学习来解决
- 分析变量之间的所有关系
- 测试多个假设以发现是什么产生了进展
此外,分析变量之间的所有关系并测试各种假设以发现产生进展的因素也很重要。这可能包括:
探索性分析:使用探索性分析技术更好地理解时间序列的性质并识别变量之间可能的模式或关系。
统计测试:进行统计测试以检查观察到的变量之间的关系是否具有显着性。
另一个解决方案是创建一个算法,用最基本的假设来做到这一点:
- 测试“关系和”对级数的影响: a+b->c、b+c->a、c+a->b、a+b+c->d 等(-> == 影响、产生)
- 测试“关系减法”、“关系除法”、“关系平方”等
这个用于测试“关系运算”的算法,它将是一种直接机器学习(或显式机器学习)方法。这意味着该算法不使用先进的机器学习技术,而是实现规则和逻辑结构来学习时间序列模式。
仅测试基本假设,局限性是:
- 过度拟合:算法可能过度专注于训练数据集中的特定模式,而不能很好地推广到新数据。
- 可扩展性有限:如果数据集非常大或复杂,算法可能无法实时测试所有可能的假设。
虽然机器学习模型可以:
- 学习复杂的模式并推广到新数据,而不需要明确指定它们。
但样本量又如何呢?
在寻找更复杂的解决方案之前,最好确保更简单的解决方案已经过充分的测试。
如果我们仅包含 3 行级数序列,我们可以使用多项式级数预测准确值
date = [
 { "study_time": 1, "salary":  350, "absences": 5, "city": "san francisco" },
 { "study_time": 2, "salary": 1600, "absences": 4, "city": "london" },
 { "study_time": 3, "salary": 2450, "absences": 3, "city": "paris" },
 { "study_time": 4, "salary": 5150, "absences": 5, "city": "san francisco" },
 { "study_time": 5, "salary": 5800, "absences": 4, "city": "london" },
 { "study_time": 6, "salary": 6050, "absences": 3, "city": "paris" },
 {'study_time': 7, 'salary': 9950, 'absences': 5, 'city': 'san francisco'},
 {'study_time': 8, 'salary': 10000, 'absences': 4, 'city': 'london'},
 {'study_time': 9, 'salary': 9650, 'absences': 3, 'city': 'paris'}
]
现在
- study_time = 13 => 预计薪资:19550
- study_time = 49 => 预计薪资:77150
所以这个问题可以用多项式回归来解决,只要数据样本足够
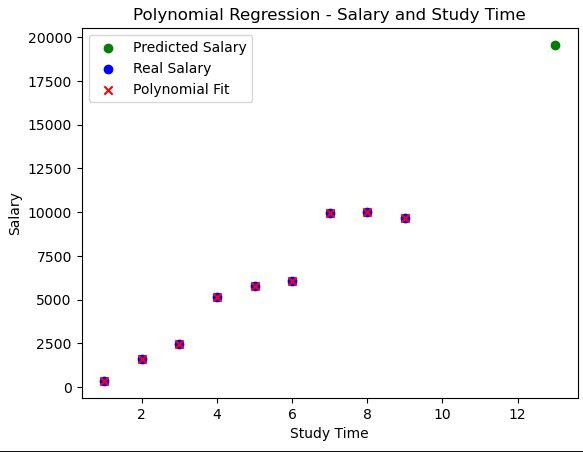
有趣的是,该模型只需要第 9 行之前的数据样本即可做出准确的预测。这表明时间序列中存在规则模式,可以用有限的数据量来捕获。确实有。
完整代码
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression

data = pd.DataFrame({
    "study_time": [1, 2, 3, 4, 5, 6, 7, 8, 9],
    "absences": [5, 4, 3, 5, 4, 3, 5, 4, 3],
    "San Francisco": [0, 1, 0, 0, 1, 0, 0, 1, 0], # dummy variables
    "London": [0, 0, 1, 0, 0, 1, 0, 0, 1], # dummy variables
    "Paris": [1, 0, 0, 1, 0, 0, 1, 0, 0], # dummy variables
    "salary": [350, 1600, 2450, 5150, 5800, 6050, 9950, 10000, 9650]
})

# Independent and dependent variables
X = data[["study_time", "absences", "San Francisco", "London", "Paris"]]
y = data["salary"]

# Creating polynomial characteristics of degree 2
characteristics_2 = PolynomialFeatures(degree=2)
x_pol_2 = characteristics_2.fit_transform(X)

# Fitting the linear regression model
model2 = LinearRegression()
model2.fit(x_pol_2, y)

# New data provided for prediction
new_data = pd.DataFrame({
    "study_time": [13],
    "absences": [5],
    "San Francisco": [0],
    "London": [0],
    "Paris": [1]
})

# Polynomial transformation of the new data
new_data_pol_2 = characteristics_2.transform(new_data)
predicted_salary = model2.predict(new_data_pol_2)

print("Predicted Salary:", int(predicted_salary[0]) )

# Plot
plt.subplot(1, 1, 1)
plt.scatter(new_data["study_time"], predicted_salary, color='blue', label='Real Salary')

plt.scatter(data["study_time"], y, color='blue', label='Real Salary')
plt.scatter(data["study_time"], y_pol_2, color='red', label='Polynomial Fit', marker='x')
plt.title("Polynomial Regression - Salary and Study Time")
plt.xlabel("Study Time")
plt.ylabel("Salary")
plt.legend()
plt.show()













