








看完了简明教程和笨办法学python,想写爬虫,无从做起,需要继续看什么书和练习
回复内容:
说说我的经历吧我最早是爬虾米,想看看虾米听的比较多的歌是哪些,就爬了虾米全站的歌曲播放数,做了个统计
Python爬虫学习记录(1)——Xiami全站播放数
统计过豆瓣动漫的评分分布
豆瓣2100部动漫页面的网页源码(包括评分,导演,类型,简介等信息,附抓取代码)
爬百度歌词,做LDA
Python爬虫学习记录(2)——LDA处理歌词
百度音乐带标签,作曲,演唱者,类别的歌词数据
爬足彩网站所有盘口,找赢钱算法
Python爬虫学习记录(4)——传说中的足彩倍投法。。好像也不是那么靠谱
2011~2013.5全球所有足球比赛比分数据以及足彩各公司盘口
初期不需要登录的网站比较简单,掌握http get post和urllib怎么模拟,掌握lxml、BeautifulSoup等parser库就可以了,多用firefox的firebug或者chrome的调试工具看浏览器是怎么发包的。上面都是不需要登录不需要下文件就可以做到的。
之后你可能想要下载文件(图片,音乐,视频等),这个可以试试爬虾米歌曲
Python爬虫学习记录(3)——用Python获取虾米加心歌曲,并获取MP3下载地址
爬wallbase壁纸
最近做了个avfun的视频排行,每天定时抓几次acfun,然后下载视频到服务器缓存。
Python爬虫学习记录(5)——python mongodb + 爬虫 + web.py 的acfun视频排行榜
202.120.39.152:8888
然后你可能需要模拟用户登录,爬取需要登录的网站(比如人人,新浪微博)。如果只是小规模爬虫建议用浏览器cookie模拟登录
Python爬虫学习记录(0)——Python 爬虫抓站 记录(虾米,百度,豆瓣,新浪微博)
===========================
想说的是,不要为了学而学,可以看看有什么以前觉着很麻烦的操作,是不是能用爬虫简化。爬下来的数据是不是有排序筛选分析的价值。
2015-8-31,在csdn上更新了之前失效的百度空间链接,可能有些代码因为网站的改版不适用了,这里主要还是提供一些应用的想法。 看了大部分回答不禁叹口气,主要是因为看到很多大牛在回答像“如何入门爬虫”这种问题的时候,一如当年学霸讲解题目,跳步无数,然后留下一句“不就是这样推嘛”,让一众小白菜鸟一脸懵逼。。作为一个0起步(之前连python都不会),目前总算掌握基础,开始向上进阶的菜鸟,深知其中的不易,所以我会在这个回答里,尽可能全面、细节地分享给大家从0学习爬虫的各种步骤,如果对你有帮助,请点赞~
-------------------------------------------------------------------------------------------------
#我要写爬虫!
#Ver.1.2
#Based on: Python 2.7
#Author:高野良
#原创内容,转载请注明出处
首先!你要对爬虫有个明确的认识,这里引用毛主席的思想:

在战略上藐视:“所有网站皆可爬”:互联网的内容都是人写出来的,而且都是偷懒写出来的(不会第一页是a,下一页是8),所以肯定有规律,这就给人有了爬取的可能,可以说,天下没有不能爬的网站“框架不变”:网站不同,但是原理都类似,大部分爬虫都是从 发送请求——获得页面——解析页面——下载内容——储存内容 这样的流程来进行,只是用的工具不同在战术上重视:持之以恒,戒骄戒躁:对于初学入门,不可轻易自满,以为爬了一点内容就什么都会爬了,爬虫虽然是比较简单的技术,但是往深学也是没有止境的(比如搜索引擎等)!只有不断尝试,刻苦钻研才是王道!(为何有种小学作文即视感)||
||
V
然后,你需要一个宏伟的目标,来让你有持续学习的动力(没有实操项目,真的很难有动力)
我要爬整个豆瓣!...||
我要爬整个草榴社区!
我要爬知乎各种妹子的联系方式*&^#%^$#

||
V
接着,你需要扪心自问一下,自己的python基本功吼不吼啊?
吼啊!——OK,开始欢快地学习爬虫吧 !||
不吼?你还需要学习一个!赶紧回去看廖雪峰老师的教程,
2.7的。至少这些功能和语法你要有基本的掌握 :
- list,dict:用来序列化你爬的东西
- 切片:用来对爬取的内容进行分割,生成
- 条件判断(if等):用来解决爬虫过程中哪些要哪些不要的问题
- 循环和迭代(for while ):用来循环,重复爬虫动作
- 文件读写操作:用来读取参数、保存爬下来的内容等
||
V
然后,你需要补充一下下面几个内容,作为你的知识储备:
(注:这里并非要求“掌握”,下面讲的两点,只需要先了解,然后通过具体项目来不断实践,直到熟练掌握)
1、网页的基本知识:
基本的HTML语言知识(知道href等大学计算机一级内容即可)
理解网站的发包和收包的概念(POST GET)
稍微一点点的js知识,用于理解动态网页(当然如果本身就懂当然更好啦)
2、一些分析语言,为接下来解析网页内容做准备
NO.1 正则表达式:扛把子技术,总得会最基础的:||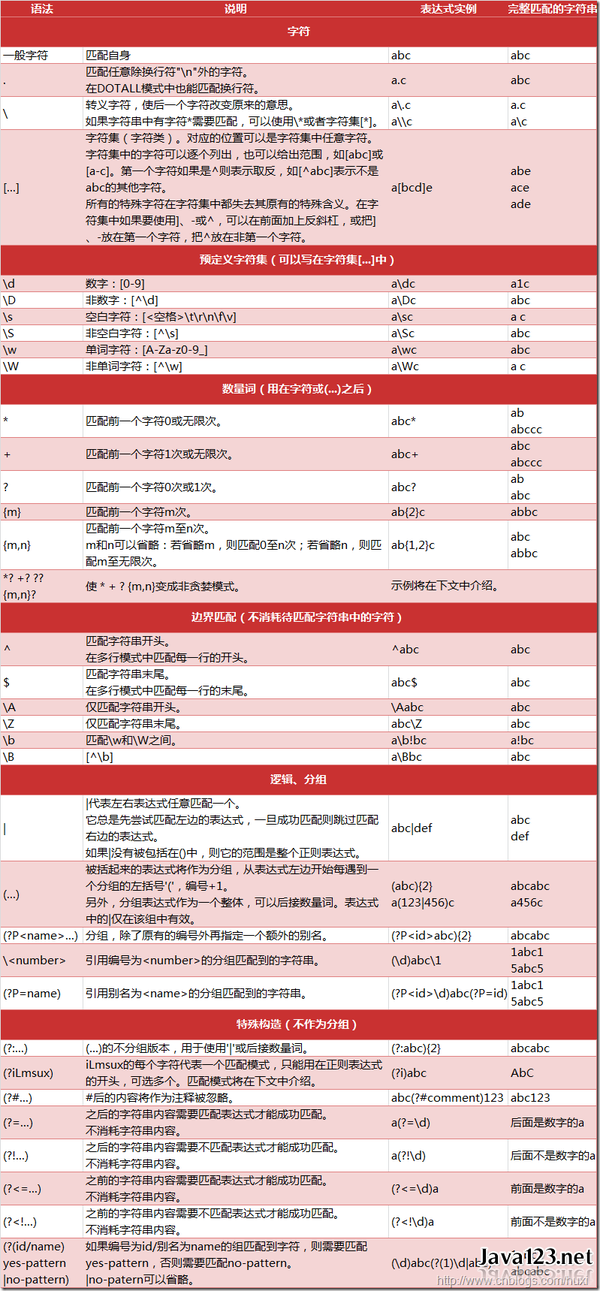
NO.2 XPATH:高效的分析语言,表达清晰简单,掌握了以后基本可以不用正则
参考:XPath 教程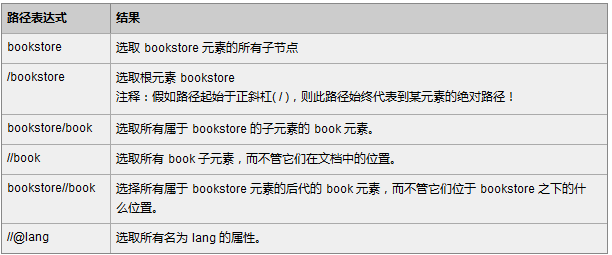
NO.3 Beautifulsoup:
美丽汤模块解析网页神器,一款神器,如果不用一些爬虫框架(如后文讲到的scrapy),配合request,urllib等模块(后面会详细讲),可以编写各种小巧精干的爬虫脚本
官网文档:Beautiful Soup 4.2.0 文档
参考案例: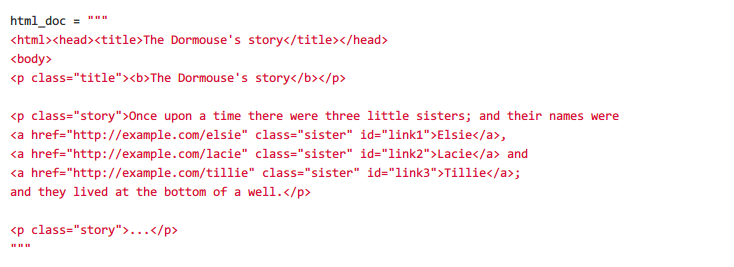
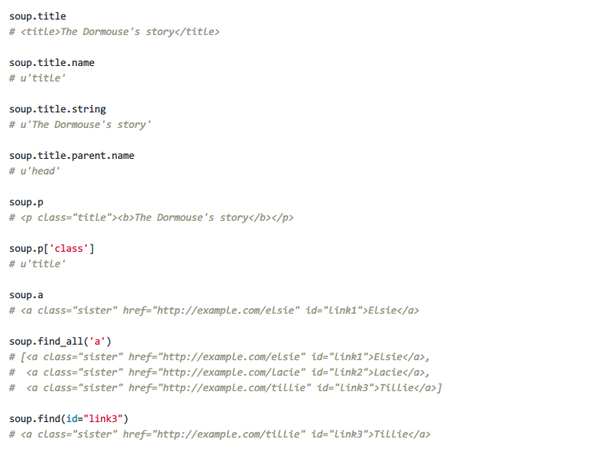
||
V
接着,你需要一些高效的工具来辅助
(同样,这里先了解,到具体的项目的时候,再熟悉运用)
NO.1 F12 开发者工具:||
- 看源代码:快速定位元素
- 分析xpath:1、此处建议谷歌系浏览器,可以在源码界面直接右键看
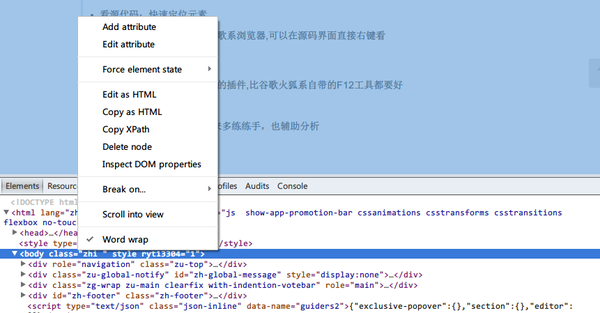
NO.2 抓包工具:
- 推荐httpfox,火狐浏览器下的插件,比谷歌火狐系自带的F12工具都要好,可以方便查看网站收包发包的信息
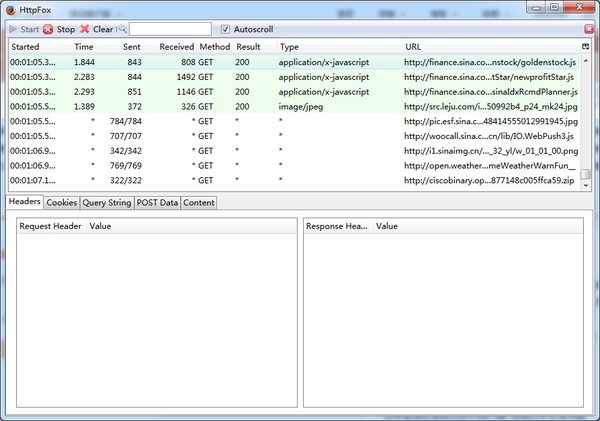
NO.3 XPATH CHECKER (火狐插件):
非常不错的xpath测试工具,但是有几个坑,都是个人踩过的,,在此告诫大家:
1、xpath checker生成的是绝对路径,遇到一些动态生成的图标(常见的有列表翻页按钮等),飘忽不定的绝对路径很有可能造成错误,所以这里建议在真正分析的时候,只是作为参考
2、记得把如下图xpath框里的“x:”去掉,貌似这个是早期版本xpath的语法,目前已经和一些模块不兼容(比如scrapy),还是删去避免报错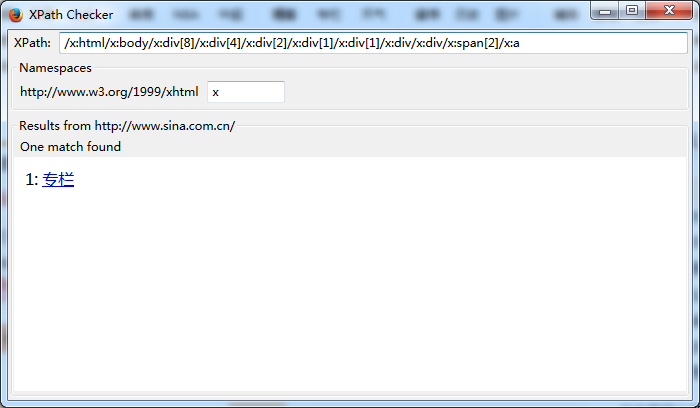
NO.4 正则表达测试工具:
在线正则表达式测试 ,拿来多练练手,也辅助分析!里面有很多现成的正则表达式可以用,也可以进行参考!
||
V
ok!这些你都基本有一些了解了,现在开始进入抓取时间,上各种模块吧!python的火,很大原因就是各种好用的模块,这些模块是居家旅行爬网站常备的——
urllib||
urllib2
requests
||
V
不想重复造轮子,有没有现成的框架?
华丽丽的scrapy(这块我会重点讲,我的最爱)||
||
V
遇到动态页面怎么办?
selenium(会了这个配合scrapy无往不利,是居家旅行爬网站又一神器,下一版更新的时候会着重安利,因为这块貌似目前网上的教程还很少)||
||
V
爬来的东西怎么用?
pandas(基于numpy的数据分析模块,相信我,如果你不是专门搞TB级数据的,这个就够了)||
||
V
然后是数据库,这里我认为开始并不需要非常深入,在需要的时候再学习即可
mysql||
mongodb
sqllite
||
V
进阶技术
多线程
分布式
V1.2更新日志:
修改了一些细节和内容顺序
Python入门网络爬虫之精华版python学习网络爬虫主要分3个大的版块:抓取,分析,存储
另外,比较常用的爬虫框架Scrapy,这里最后也详细介绍一下。
首先列举一下本人总结的相关文章,这些覆盖了入门网络爬虫需要的基本概念和技巧:宁哥的小站-网络爬虫
当我们在浏览器中输入一个url后回车,后台会发生什么?比如说你输入宁哥的小站(fireling的数据天地)专注网络爬虫、数据挖掘、机器学习方向。,你就会看到宁哥的小站首页。
简单来说这段过程发生了以下四个步骤:

Python 环境工具专业版功能概述Python 环境工具专业版是一项面向实际任务的技能。它将相关步骤、工具调用和结果整理方式集中到统一流程中,帮助使用者更快完成目标并减少重复操作。核心要点使用时应结合输入条件选择合适的执行方式,核对必要参数、依赖环境与输出内容,并按原始要求处理异常情况。该技能适合需要稳定复用相关能力的场景,可作为自动化工作流的一部分,也便于后续检查、调整和扩展。执行完成后建议检查结果是否符合预期,并保留必要记录。使用与执行同时注意输入完整性、执行条件和输出可用性。从功能定位来看,该技能
立即学习“Python免费学习笔记(深入)”;
- 查找域名对应的IP地址。
- 向IP对应的服务器发送请求。
- 服务器响应请求,发回网页内容。
- 浏览器解析网页内容。
网络爬虫要做的,简单来说,就是实现浏览器的功能。通过指定url,直接返回给用户所需要的数据,而不需要一步步人工去操纵浏览器获取。
抓取这一步,你要明确要得到的内容是什么?是HTML源码,还是Json格式的字符串等。
1. 最基本的抓取抓取大多数情况属于get请求,即直接从对方服务器上获取数据。
首先,Python中自带urllib及urllib2这两个模块,基本上能满足一般的页面抓取。另外,requests也是非常有用的包,与此类似的,还有httplib2等等。
Requests:
    import requests
    response = requests.get(url)
    content = requests.get(url).content
    print "response headers:", response.headers
    print "content:", content
Urllib2:
    import urllib2
    response = urllib2.urlopen(url)
    content = urllib2.urlopen(url).read()
    print "response headers:", response.headers
    print "content:", content
Httplib2:
    import httplib2
    http = httplib2.Http()
    response_headers, content = http.request(url, 'GET')
    print "response headers:", response_headers
    print "content:", content
动机上:我想把学校教育系统课程信息爬下来 操作上:先了解 HTTP协议,然后学习使用 Python Requests模块,再实战。
练习上:先在终端直接操作,试着抓抓http://www.baidu.com,再把自己写的爬虫发布到PIPy…然后,把教务系统2学期2000+门课抓下来,还尝试攻击了一个小伙伴的网站…把它搞挂啦!
具体可以看这篇博客,写一个 Python 爬虫
https://jenny42.com/2015/02/write-a-spider-use-python/
突然发现我这个其实不算爬虫,顶多算抓取网页。因为我没有学 xPath 和 CSSSelect 那些东西,没有把网站爬个遍…
你会发现,尽管我的爬虫技术还很烂…但是我做的大部分尝试都是有反馈的,比如发布模块可以看到下载次数(心想着这种坑爹模块也有人下载啊),抓教务系统数据很好玩(我发现全校有250个左右的同学重名)…把小伙伴的网站搞垮再去报Bug…但我觉得这样学习很有趣。
而且我觉得我对之后学:怎么抓需要验证码的网站,怎么把网站爬个遍之类的进阶技能也很感兴趣~ 刚开始只是简单的看了下 Python, 简单的写些小程序,小工具之类的,感受到了它的简洁与强大。
突然就想写个爬虫试试,那就爬我最喜欢的音乐网站落网,爬了从第一期到到现在的所有音乐,包括每期的图片。还另外写了一个自动下载当前最新一期的所有歌曲的脚本。还试着用工具 PyInstaller 打包成了 exe,分享给了我几个同样喜欢落网的朋友。↓这是我爬的成果。
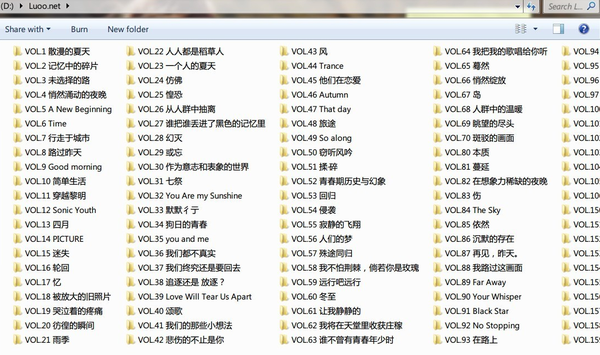
关于如何学,我只是个新手,谈不上指导,就说说我自己怎么做的吧:
- 首先基本的 Python 语法你要了解吧,推荐一本书《Python基础教程》,很适合入门。
- 其次分析你的爬虫需求。程序具体流程是怎么样的?把程序的大致框架搭起来。另外可能还有哪些难点?
- 然后了解一下一般写爬虫需要用哪些库,这些库可以很好的帮助你解决很多问题。推荐强悍的 Requests: HTTP for Humans 另外还有其他一些库 如 urllib2 BeautifulSoup 都可以了解下。
- 动手开始写了,遇到问题 Google 即可,Google 不行就上知乎问,我遇到的一个问题就是知乎私信大牛解决的。在写的过程中还会学到很多相关的知识,比如说HTTP协议, 多线程 等等。
比如知乎的一些好文章,你要保存下来,或者自动定期发送到kindle电子书
python爬虫 推送知乎文章到kindle电子书
python 暴力破解wordpress博客后台登陆密码
批量获取色影无忌图片 Python_小组(链接修复中)
用python破解某211大学BBS论坛用户密码(链接修复中)
感觉都是自己为了完成某种目的而且做得,这样动机会更加明确。 目前准备爬取股票信息,做研究使用(炒股啦)
更多 30天尝试新事情 第一次想写爬虫是为了抓取草榴的高点击率视频链接。代码如下。需要翻墙。
# -- coding: utf-8 --

import urllib2
import sys
from bs4 import BeautifulSoup

reload(sys)
sys.setdefaultencoding('utf8')                          #解决写入文件乱码问题

BaseUrl = "http://t66y.com/"
j=1

for i in range(1, 100):                                 #设置始末页码
  url = "http://t66y.com/thread0806.php?fid=22&search=&page="+ str(i)  #默认str会把字符串变成unicode,所以开头必须用sys来重置
  page = urllib2.urlopen(url)
  soup = BeautifulSoup(page, from_encoding="gb18030")   #解决BeautifulSoup中文乱码问题
  print("reading page "+ str(i))
  counts = soup.find_all("td", class_="tal f10 y-style")

  for count in counts:
    if int(count.string)>15:                            #选择想要的点击率
      videoContainer = count.previous_sibling.previous_sibling.previous_sibling.previous_sibling
      video = videoContainer.find("h3")
      print("Downloading link "+ str(j))
      line1 = (video.get_text())
      line2 = BaseUrl+video.a.get('href')
      line3 = "view **" + count.string + "** "
      print line1
      f = open('cao.md', 'a')
      f.write("\n"+"###"+" "+line1+"\n"+"<"+line2+">"+"\n"+line3+ "  "+ "page"+str(i)+"\n")
      f.close()
      j+=1
只推薦一個库不解释:Requests: HTTP for Humans 最开始看了写Simplecd那个人的博客开始了解原来Python写爬虫这么牛逼。
然后写了脚本1W+豆瓣电影的评分页面。之后实验室有项目,写了脚本爬了50W条微博,中途熟悉如何模拟登录骗过服务器是最有趣的部分。
总结,你看看之前人的博客就行了,简单的爬虫用不到多高深的技术,无非就是几个:
1.熟悉一下urllib的使用
2.了解基本的html解析,通常来说最基本的正则就够用了 不知题主的编程基础如何,基本上想写Python爬虫只需要看下前人的日志学习下urllib和BeautifulSoup就够用了。
另外如果有千人的实际例子看一下应该能比较直观的明白一个爬虫是怎么跑起来的。
在下不才,写过一个爬知乎数据的爬虫,开源于(各位亲走过路过的时候请给点个Star或Fork呗~):MorganZhang100/zhihu-spider · GitHub
该爬虫爬到的数据应用于:http://zhihuhot.sinaapp.com/
简单点说就是一个爬取问题的一些参数,进行分析,找出最可能会火的问题。据此回答问题的话,得赞速度比之前多20倍左右。
我对Python也不是很熟悉,不过一共只有几百行的代码,题主看看应该问题不大。
其实学任何东西,看得教程再多也比不上自己实习写几行代码来得有效果。只要开始写了,你就知道你需要什么了。

























