讲师中心 微信公众号
AI工具推荐 视频效率加速

单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速

老枫小哥_2602

老枫小哥_2602

发布时间:2024-07-09 10:53:34

|

488人浏览过

|

来源于机器之心

转载

微软的这项研究让开发者可以在单卡机器上以 10 倍的速度处理超过 1m 的输入文本。


大型语言模型 (LLM) 已进入长上下文处理时代,其支持的上下文窗口从先前的 128K 猛增到 10M token 级别。

然而,由于注意力机制的二次复杂度,模型处理输入提示(即预填充阶段)并开始产生第一个 token 可能需要几分钟时间。导致首个 token 生成的时间过长,从而严重影响了用户体验,这也极大地限制了长上下文 LLM 的广泛应用。 

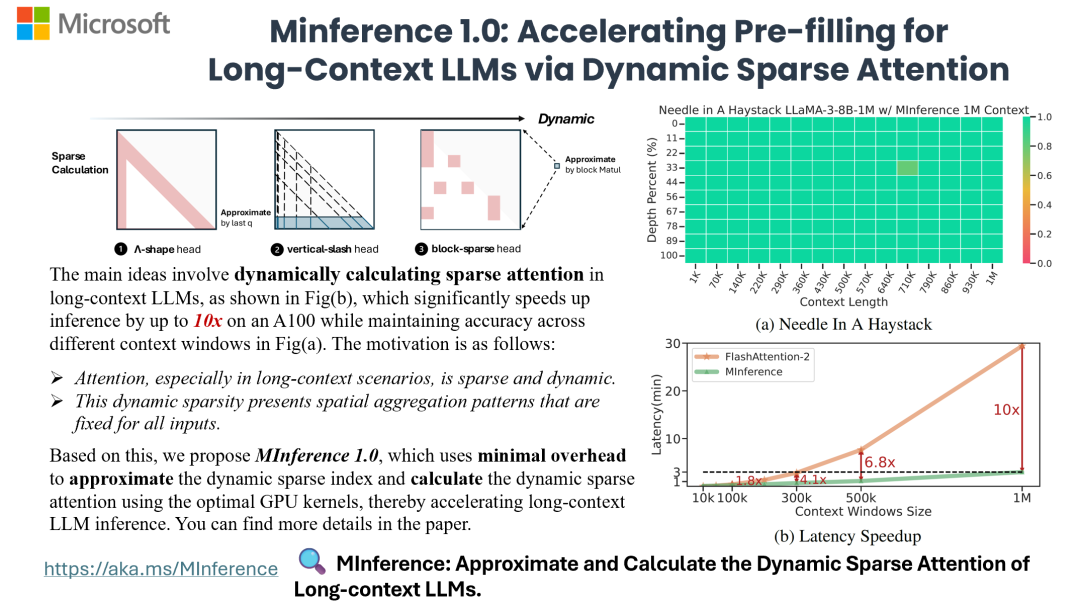
举例来说(如图 2a 所示),在单台装有 A100 的机器上为 LLaMA-3-8B 提供服务时,如果提示有 30 万个 token,模型需要 6 分钟才能完成预填充( pre-filling)阶段,如果提示增加到 100 万个 token,这个数字将增加到 30 分钟。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
自注意力计算的开销占到了总预填充延迟的 90% 以上,这使其成为 LLM 处理长上下文时的主要瓶颈。现有的加速预填充方法在应用于长上下文 LLM 时通常无法保持可接受的准确性或效率。

为了解决上述问题,来自微软、萨里大学的研究者提出了一种旨在加速长序列处理预填充的稀疏计算方法:MInference( Milliontokens Inference )。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
  • 论文地址:https://arxiv.org/pdf/2407.02490
  • 论文主页:https://hqjiang.com/minference.html
  • 论文标题:MInference 1.0: Accelerating Pre-filling for Long-Context LLMs via Dynamic Sparse Attention

MInference 可以直接应用于现有 LLM,无需对预训练设置进行修改或额外的微调。

通过对各种下游任务(包括 InfiniteBench、RULER、PG-19 和 Needle In A Haystack)以及模型(包括 LLaMA-3-1M、Yi-200K、GLM-4-1M、Phi-3-128K 和 Qwen2-128K)进行评估,实验证明 MInference 可有效将 A100 上的预填充推理延迟降低多达 10 倍,同时保持准确性。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速

☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速

Unified LLM Gateway - One API for 70+ AI models. Route to GPT, Claude, Gemini, Qwen, Deepseek, Grok and more

统一LLM网关 - 一个API对接70+AI模型,使用单一API密钥即可调用GPT、Claude、Gemini、Qwen、Deepseek、Grok等主流模型。

下载
                                    使用 MInference 1.0 ,长上下文 LLM(如 LLaMA-3-8B-1M、GLM-4-1M)在单个 A100 上的推理速度实现了 10 倍提升,并且准确度更高。

方法介绍

作者提出了 MInference,这个名字反映了他们希望在一台 A100 机器上实现百万(million)token 推理的雄心。

MInference 是一种无需训练的高效方法,用于基于动态稀疏注意力的长上下文 LLM 的预填充阶段。

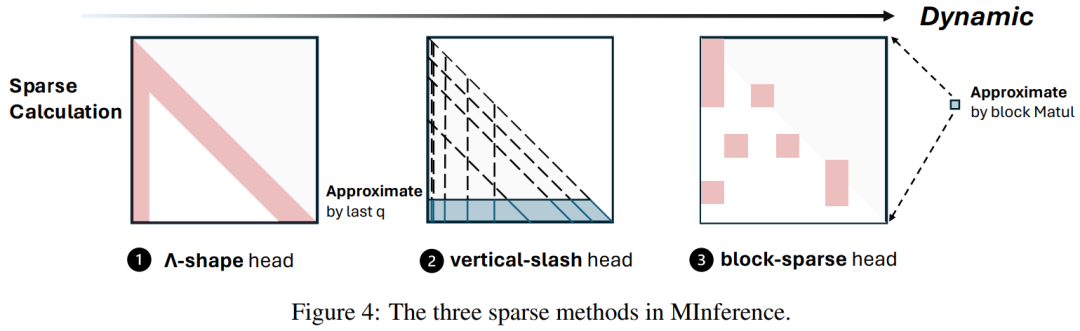
研究者认为注意力,特别是在长上下文中,是稀疏和动态的,即在不同的输入中,稀疏模式有很大的不同。这种动态稀疏性呈现出三种适用于所有输入的独特空间聚合模式:A 形(A-shape)、垂直 - 斜线(Vertical-Slash)和块状 - 稀疏(Block-Sparse)。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
MInference 首先使用内核感知稀疏模式搜索算法为每个头部离线确定最佳动态稀疏模式,如算法 1 所示。在推理过程中,它会根据头部的模式动态逼近动态稀疏指数,如算法 2、3 所示。最后,作者使用优化后的 GPU 内核执行高效的动态稀疏注意力计算,大大减少了长上下文 LLM 的预填充阶段延迟。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
例如,对于「垂直 - 斜线」模式,作者首先利用最后一个 Q 和 K 之间的注意力计算来估计垂直线和斜线的最佳指数。然后,他们利用动态稀疏编译器 PIT 和 Triton 构建垂直 - 斜线 FlashAttention 内核,加速注意力计算。对于 A 形、垂直 - 斜线和块状 - 稀疏模式,作者首先在注意力计算中使用 Q 和 K 的均值池。利用均值池和 MatMul 的交换属性,可以估算出块状 - 稀疏指数。然后,他们使用 Triton 构建块稀疏 FlashAttention 内核,加速注意力计算。有关内核的详细实现,请参阅附录 C.4 和代码。

在长上下文基准中的评估结果

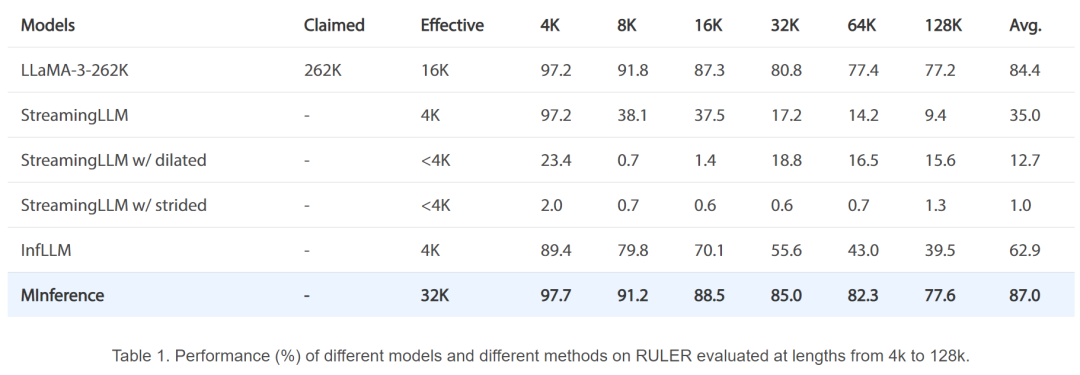
作者在一系列场景中测试了 MInference,包括 QA、编码、基于检索的任务、multi-hop QA、总结和数学任务。RULER 基准包括几个复杂的 multi-hop 或 multi-needle 任务,有效地反映了 LLM 的实际上下文窗口大小。如表 1 所示,MInference 有效地保留了 LLM 的实际上下文窗口处理能力,甚至将实际上下文窗口大小略微扩展到 32K。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
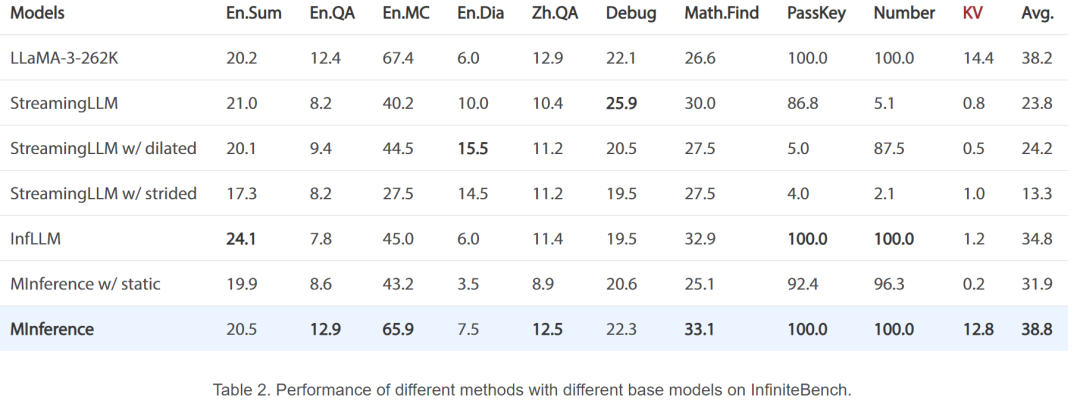
作者还使用平均 token 长度为 214K 的 InfiniteBench 在更广泛的任务中测试了 MInference,如表 2 所示。与 SoTA 基线相比,MInference 在所有任务中都始终保持了良好的性能。值得注意的是,在更具挑战性的检索任务(如 KV 检索任务)中,所有基线都无法做出准确预测,准确率低于 1.2%。但是,MInference 成功地保留了处理动态 KV 对检索的能力。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
为了进一步评估不同上下文长度和关键信息在提示中不同位置时的性能,作者使用「大海捞针」任务测试了各种模型和方法。如图 1 所示,MInference 在不同的模型、上下文窗口和提示信息位置下都表现良好,与原始模型相比,其性能保持不变甚至略有提高。在 LLaMA-3-8B 和 GLM-4-9B-1M 的情况下,MInference 在高达 1M 的上下文窗口中实现了完全绿色的性能。相比之下,即使在 70K 上下文窗口中,StreamingLLM 和 InfLLM 在提示的中间段性能也会下降到 20% 以下。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
作者还使用 PG-19 在语言模型任务中测试了 MInference,其中包括多达 100k 的 token。如图 2 所示,MInference 有效地保持了 LLaMA-3-8B 和 Yi-9B-200K 的困惑度,而所有基线都出现了不同程度的困惑度下降。此外,与标准的 StreamingLLM 相比,使用膨胀和步长配置的 StreamingLLM 更好地保持了困惑度性能。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
延迟和内核中的稀疏模式 

图 3 展示了本文提出的三种注意力模式以及 FlashAttention 的微基准测试结果。可以看出,Vertical-Slash 是三种模式中最慢的,但在 1M 上下文窗口下,相比 FlashAttention 仍然实现了 13 倍的加速。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
图 4 展示了 Vertical-Slash 头部内核中的稀疏索引。垂直线通过 PIT FlashAttention 使用 1x64 块计算,而斜线通过块级 FlashAttention 使用 64x64 块计算。
单卡A100实现百万token推理,速度快10倍,这是微软官方的大模型推理加速
参考链接:https://hqjiang.com/minference.html

热门AI工具

更多
火山引擎

火山引擎是一款面向企业的云计算与AI服务平台。

咔片AIPPT

一款在线AI演示文稿制作工具,可根据主题和内容需求辅助生成PPT结构与页面,提高演示材料制作效率。

UP简历
UP简历 Hot

一款AI办公效率工具,主要用于基于AI技术的免费在线简历制作工具,适合需要提升相关任务效率的用户。

VibeKnow
VibeKnow Hot

一款AI视频创作工具,主要用于全球首个AI知识视频创作平台,文档、文章、网页,一键生成视频,适合需要提升相关任务效率的用户。

LibLibAI
LibLibAI Hot

一款AI视频创作工具,主要用于国内领先的AI创意平台,以海量模型、低门槛操作与“创作-分享-商业化”生态,让小白与专业创作者都能高效实现图文乃至视频创意表达,适合需要提升相关任务效率的用户。

WorkBuddy

一款AI办公效率工具,主要用于腾讯云推出的AI原生桌面智能体工作台,适合需要提升相关任务效率的用户。

DeepSeek

DeepSeek是一款面向对话、写作、编程和推理场景的AI大模型工具。

蛙蛙写作

一款AI论文写作工具,主要用于超级AI智能写作助手,适合需要提升相关任务效率的用户。

豆包大模型

豆包大模型是一款由字节跳动推出的企业级大语言模型服务平台。

相关专题

更多
登录token无效
登录token无效

登录token无效解决方法:1、检查token的有效期限,如果token已经过期,需要重新获取一个新的token;2、检查token的签名,如果签名不正确,需要重新获取一个新的token;3、检查密钥的正确性,如果密钥不正确,需要重新获取一个新的token;4、使用HTTPS协议传输token,建议使用HTTPS协议进行传输 ;5、使用双因素认证,双因素认证可以提高账户的安全性。

12046

2023.09.14

登录token无效怎么办
登录token无效怎么办

登录token无效的解决办法有检查Token是否过期、检查Token是否正确、检查Token是否被篡改、检查Token是否与用户匹配、清除缓存或Cookie、检查网络连接和服务器状态、重新登录或请求新的Token、联系技术支持或开发人员等。本专题为大家提供token相关的文章、下载、课程内容,供大家免费下载体验。

1465

2023.09.14

token怎么获取
token怎么获取

获取token值的方法:1、小程序调用“wx.login()”获取 临时登录凭证code,并回传到开发者服务器;2、开发者服务器以code换取,用户唯一标识openid和会话密钥“session_key”。想了解更详细的内容,可以阅读本专题下面的文章。

3217

2023.12.21

token什么意思
token什么意思

token是一种用于表示用户权限、记录交易信息、支付虚拟货币的数字货币。可以用来在特定的网络上进行交易,用来购买或出售特定的虚拟货币,也可以用来支付特定的服务费用。想了解更多token什么意思的相关内容可以访问本专题下面的文章。

5381

2024.03.01

页面置换算法
页面置换算法

页面置换算法是操作系统中用来决定在内存中哪些页面应该被换出以便为新的页面提供空间的算法。本专题为大家提供页面置换算法的相关文章,大家可以免费体验。

4796

2023.08.14

http与https有哪些区别
http与https有哪些区别

http与https的区别:1、协议安全性;2、连接方式;3、证书管理;4、连接状态;5、端口号;6、资源消耗;7、兼容性。本专题为大家提供相关的文章、下载、课程内容,供大家免费下载体验。

5250

2024.08.16

Buffalo框架数据库开发全教程
Buffalo框架数据库开发全教程

本专题围绕Buffalo框架数据库开发,讲解database.yml多环境配置、soda与fizz迁移生成回滚、模型结构体标签、增删改查与条件查询、一对多与多对多关联、数据校验、回调钩子、事务处理及原生SQL执行能力。

80

2026.09.23

Buffalo框架路由与请求处理实操指南

本专题讲解Buffalo框架路由与请求处理机制,涵盖路由注册与分组、资源路由、Handler编写规范、Context上下文方法、参数绑定、中间件编写挂载、Session与Cookie读写、Flash消息及错误页面定制方法。

20

2026.09.23

Buffalo框架零基础入门教程
Buffalo框架零基础入门教程

本专题整理Buffalo框架入门内容,涵盖Go环境准备、buffalo CLI安装、新项目生成、目录结构说明、dev热加载启动、数据库连接配置与常见报错排查,帮助新手按约定优于配置的思路跑通第一个Buffalo框架应用。

20

2026.09.23

热门下载

更多
网站特效
/
网站源码
/
网站素材
/
前端模板

精品课程

更多
相关推荐
/
热门推荐
/
最新课程
Buffalo框架快速入门指南
Buffalo框架快速入门指南

共0课时 | 0人学习

Conan 2 Essentials 免费课程

共0课时 | 0人学习

Conan 2 高级依赖模型介绍
Conan 2 高级依赖模型介绍

共0课时 | 0人学习

关于我们 免责申明 举报中心 意见反馈 讲师合作 广告合作 最新更新
php中文网:公益在线php培训,帮助PHP学习者快速成长!
关注服务号
PHP中文网订阅号
每天精选资源文章推送

Copyright 2014-2026 https://www.php.cn/ All Rights Reserved | php.cn