








在xorm中实现分表,核心做法是配置`tablemapper`以动态生成表名,并在模型结构体上通过`tablename()`方法或`xorm:"table_name"`标签指定基础表前缀。对于按时间或id分片的场景,通常结合自定义的映射函数,根据业务主键计算哈希值或取模结果,从而将数据路由到具体的物理表中。这样配置后,xorm在执行crud操作时会自动拼接后缀,无需修改业务代码中的查询逻辑。

如何配置全局表名映射规则
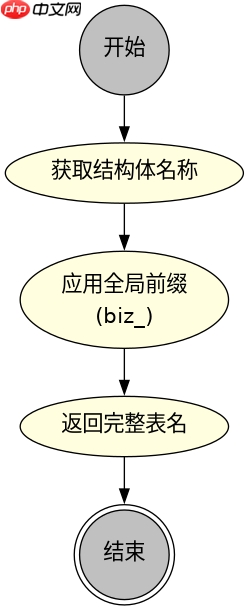
要启用分表,必须替换默认的表名映射器。默认情况下,XORM使用`SnakeMapper`将结构体名转换为蛇形命名。通过调用`engine.SetTableMapper()`并传入一个符合`func(string) string`签名的函数,可以接管所有表的命名逻辑。这个函数接收原始结构体名,返回最终使用的数据库表名。如果希望所有表都遵循某种前缀或后缀规范,可以在这里统一处理。
package main

import (
    "fmt"
    "strings"
    "github.com/go-xorm/xorm"
    _ "github.com/go-sql-driver/mysql"
)

// CustomMapper 模拟一个简单的分表映射逻辑
// 这里仅演示添加后缀,实际分表需结合主键计算
func CustomMapper(tableName string) string {
    // 假设我们有一个固定的前缀
    prefix := "biz_"

    // 获取结构体名并转为小写
    name := strings.ToLower(tableName)

    // 简单示例:直接返回带前缀的表名
    // 在实际分表中,这通常是一个工厂函数,返回的是闭包
    return prefix + name
}

func main() {
    engine, err := xorm.NewEngine("mysql", "root:root@tcp(127.0.0.1:3306)/test")
    if err != nil {
        panic(err)
    }
    defer engine.Close()

    // 设置全局表映射器
    engine.SetTableMapper(CustomMapper)

    // 定义模型
    type User struct {
        Id   int64 `xorm:"pk autoincr"`
        Name string
    }

    // 同步表结构,观察生成的SQL
    err = engine.Sync2(new(User))
    if err != nil {
        fmt.Println("Sync error:", err)
    } else {
        fmt.Println("Table synced successfully.")
    }
}
运行上述代码,XORM会尝试创建名为`biz_user`的表(假设结构体名为User)。关键在于,`SetTableMapper`接受的是一个函数,这意味着我们可以利用闭包来存储分片状态。例如,创建一个工厂函数`NewShardMapper(prefix string)`,它返回一个内部持有计数器或哈希表的匿名函数,从而实现更复杂的动态路由。
如何实现基于主键的动态分表路由
真正的分表需要根据记录的主键(如UserID)决定写入哪张物理表。这需要在模型层面配合使用`TableName()`方法。当XORM执行插入或查询时,它会优先检查模型是否实现了`TableName() string`接口。如果实现了,该方法会被调用以获取当前实例对应的具体表名。结合全局的映射策略,可以实现“前缀+固定后缀”或“前缀+动态后缀”的组合。

package main

import (
    "fmt"
    "math"
    "strings"
    "github.com/go-xorm/xorm"
    _ "github.com/go-sql-driver/mysql"
)

// ShardUser 带有分表逻辑的结构体
type ShardUser struct {
    Id     int64  `xorm:"pk autoincr"`
    UserId int64  `xorm:"unique"` // 用于分片的字段
    Name   string
}

// TableName 实现动态表名解析
// XORM会在每次操作此结构体时调用此方法
func (u *ShardUser) TableName() string {
    // 假设分为10张表
    shardCount := 10

    // 如果UserId为0,可能表示新建未分配,或者使用默认表
    if u.UserId == 0 {
        return "user_shard_0"
    }

    // 简单的取模分片算法
    shardIndex := int(math.Mod(float64(u.UserId), float64(shardCount)))

    return fmt.Sprintf("user_shard_%d", shardIndex)
}

func main() {
    engine, err := xorm.NewEngine("mysql", "root:root@tcp(127.0.0.1:3306)/test")
    if err != nil {
        panic(err)
    }
    defer engine.Close()

    // 注意:如果使用了全局Mapper,TableName()的结果可能会被进一步处理
    // 通常建议在全局Mapper中只做前缀处理,动态部分由TableName()负责
    // 或者不使用全局Mapper,完全依赖TableName()

    user := &ShardUser{
        UserId: 1001,
        Name:   "Alice",
    }

    // 插入数据
    _, err = engine.Insert(user)
    if err != nil {
        fmt.Println("Insert error:", err)
    } else {
        // 预期输出:INSERT INTO user_shard_1 ... WHERE user_id=1001
        fmt.Printf("Inserted into table: %s\n", user.TableName())
    }

    // 查询数据
    var users []ShardUser
    err = engine.Where("user_id = ?", 1001).Find(&users)
    if err != nil {
        fmt.Println("Query error:", err)
    } else {
        fmt.Printf("Found %d users\n", len(users))
    }
}
在这个例子中,`UserId`为1001的记录会被路由到`user_shard_1`表。需要注意的是,如果使用`engine.Table("user_shard_1").Find(...)`进行显式表名指定,则`TableName()`方法不会生效。此外,跨表查询(Join)在分表场景下非常复杂,XORM本身不自动处理跨库或跨表Join,通常需要应用层组装或使用中间件解决。
如何处理分表后的批量查询与索引失效问题
当数据分散在多张表中时,普通的`Find`或`Get`方法只能查询单张表。如果需要查询所有分片中的数据(例如统计总用户数),需要手动遍历所有可能的分片表。XORM没有内置的全局聚合查询功能。开发者需要维护一份分片列表,循环对每个分片表执行查询,然后在内存中合并结果。这种操作会导致大量的网络往返和CPU消耗,且无法利用数据库层面的索引优化,因为索引是存在于每张物理表上的局部索引。
package main

import (
    "fmt"
    "github.com/go-xorm/xorm"
    _ "github.com/go-sql-driver/mysql"
)

// ShardUser 同上定义

type ShardUser struct {
    Id     int64  `xorm:"pk autoincr"`
    UserId int64  `xorm:"unique"`
    Name   string

    // 辅助字段,用于控制查询范围
    ShardId int `xorm:"shard_id"`
}

func (u *ShardUser) TableName() string {
    return fmt.Sprintf("user_shard_%d", u.ShardId)
}

func queryAllShards(engine *xorm.Engine) ([]ShardUser, error) {
    var allUsers []ShardUser
    shardCount := 10

    for i := 0; i < shardCount; i++ {
        // 构造特定分片的查询条件
        // 注意:这里需要重新实例化结构体以改变TableName
        tempUser := &ShardUser{ShardId: i}

        // 使用 Table 方法强制指定表名,绕过 TableName() 的动态逻辑
        // 或者直接操作 tempUser 并传入 engine.Find(tempUser)
        // 但 Find 需要切片指针
        var slice []ShardUser
        err := engine.Table(tempUser.TableName()).Find(&slice)
        if err != nil {
            return nil, err
        }
        allUsers = append(allUsers, slice...)
    }
    return allUsers, nil
}

func main() {
    engine, err := xorm.NewEngine("mysql", "root:root@tcp(127.0.0.1:3306)/test")
    if err != nil {
        panic(err)
    }
    defer engine.Close()

    users, err := queryAllShards(engine)
    if err != nil {
        fmt.Println("Error:", err)
    } else {
        fmt.Printf("Total users across shards: %d\n", len(users))
    }
}
这种全表扫描式的查询效率极低。在实际生产环境中,应避免此类操作。如果必须统计,建议使用专门的搜索引擎(如Elasticsearch)或数据仓库进行异步同步和查询。对于单条记录的精确查找,只要知道分片键(如UserId),就可以直接计算出目标表名,从而高效命中索引。关键在于保持分片键的一致性,确保相同的Key总是路由到相同的表。























