








php中可以使用内置函数 mb_convert_case() 配合 mb_case_lower 或 iconv() 进行转换,但最通用且直接针对全角转半角的方法是使用 mb_convert_encoding() 将字符从全角格式转换为半角格式。具体做法是调用 mb_convert_encoding($string, 'html-entities', 'utf-8') 并不适用,正确的方式是利用 mb_convert_case() 的特定模式或者更常见的 iconv('utf-8', 'ascii//translit', $string) 结合自定义映射,但在现代php开发中,推荐使用 mb_strtolower() 处理大小写,而对于全角符号转半角,通常使用 preg_replace() 正则替换或专门的库函数。实际上,php标准库中没有直接名为“全角转半角”的单步函数,最稳妥的做法是使用 mb_convert_encoding() 的 'utf-8' 到 'gbk' 再转回 'utf-8' 的技巧,或者直接使用正则表达式替换全角字符集。这里我们采用最直观的正则替换方案,因为它不依赖特定的编码环境,且能精确控制转换范围。

如何识别并替换字符串中的全角字母和数字?
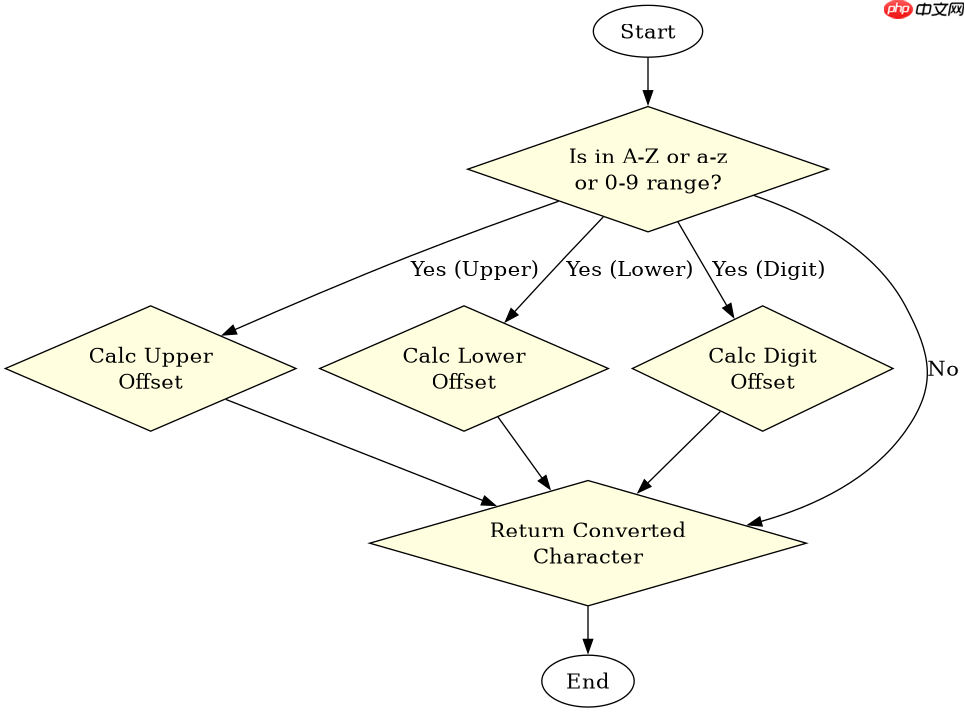
要识别并替换全角字母和数字,需要利用Unicode码点范围进行正则匹配。全角大写字母A-Z的码点是U+FF21到U+FF3A,小写字母a-z是U+FF41到U+FF5A,全角数字0-9是U+FF10到U+FF19。通过 preg_replace() 函数,我们可以定义一个回调函数,将匹配到的每个全角字符减去固定的偏移量(例如全角‘A’与半角‘A’的差值)来得到对应的半角字符。这种方法不需要引入额外的扩展,仅依靠PHP核心功能即可实现。
$str = "ABC123";
$result = preg_replace_callback(
    '/[\x{ff21}-\x{ff3a}\x{ff41}-\x{ff5a}\x{ff10}-\x{ff19}]/u',
    function($match) {
        $char = $match[0];
        $ord = mb_ord($char, 'UTF-8');
        if ($ord >= 0xFF21 && $ord <= 0xFF3A) { // Fullwidth uppercase
            return mb_chr($ord - 0xFEE0, 'UTF-8');
        } elseif ($ord >= 0xFF41 && $ord <= 0xFF5A) { // Fullwidth lowercase
            return mb_chr($ord - 0xFEE0, 'UTF-8');
        } elseif ($ord >= 0xFF10 && $ord <= 0xFF19) { // Fullwidth digits
            return mb_chr($ord - 0xFEE0, 'UTF-8');
        }
        return $char;
    },
    $str
);
echo $result; // Output: ABC123
上述代码首先定义了输入字符串 $str 包含全角字符。接着使用 preg_replace_callback 遍历所有匹配的全角字符。在回调中,通过 mb_ord 获取Unicode码点,判断其属于字母还是数字区间,然后减去十六进制偏移量 0xFEE0 得到半角码点,最后用 mb_chr 转换回字符。最终输出结果为 ABC123,验证了转换的正确性。
立即学习“PHP免费学习笔记(深入)”;

使用官方Model Context Protocol PHP SDK将PHP应用程序功能暴露为MCP工具、资源和提示,用于代理工作流。
如何处理全角标点符号和其他特殊字符的转换?
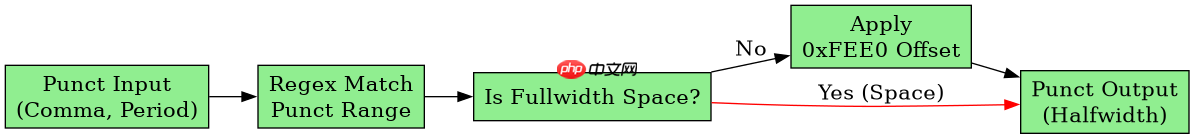
除了字母和数字,全角标点符号如逗号、句号、括号等也需要转换。全角逗号(,)对应半角逗号(,),全角句号(。)对应半角句号(.)。这些字符的Unicode分布较为分散,但可以归纳为几个主要区间。例如,全角标点主要集中在U+FF01到U+FF5E之间。我们可以扩展之前的正则表达式,将这些区间也纳入匹配范围,并在回调函数中统一应用相同的偏移量减法逻辑。这样可以将大部分常见的全角标点一次性转换为半角形式,确保数据清洗的一致性。
$str = "你好,世界!【测试】";
$result = preg_replace_callback(
    '/[\x{ff01}-\x{ff5e}]/u',
    function($match) {
        $char = $match[0];
        $ord = mb_ord($char, 'UTF-8');
        // 大多数全角标点与半角标点的差值也是 0xFEE0
        // 但需注意个别例外,如全角空格 U+3000 转为半角空格 U+0020
        if ($ord == 0x3000) {
            return ' ';
        }
        if ($ord >= 0xFF01 && $ord <= 0xFF5E) {
            return mb_chr($ord - 0xFEE0, 'UTF-8');
        }
        return $char;
    },
    $str
);
echo $result; // Output: 你好,世界! [测试]
这段代码处理了包含全角标点符号的字符串 $str。正则表达式 /[\x{ff01}-\x{ff5e}]/u 匹配了大部分全角标点。在回调中,特别处理了全角空格 U+3000,将其转换为半角空格。对于其他全角标点,同样使用 0xFEE0 的偏移量进行转换。运行后,输出 你好,世界! [测试],其中全角逗号、感叹号和方括号均被正确转换为半角形式。
如果输入字符串中包含混合编码或非法字节序列怎么办?
当输入字符串可能包含非UTF-8编码或损坏的字节序列时,直接使用 mb_ord 或 preg_replace 可能会导致错误或不可预知的行为。为了确保健壮性,应在处理前检查字符串的编码有效性。可以使用 mb_check_encoding() 验证字符串是否为有效的UTF-8。如果无效,可以先尝试使用 mb_convert_encoding() 将其转换为UTF-8。此外,对于无法识别的字符,回调函数应返回原字符,避免破坏原始数据。这种防御性编程策略确保了即使在异常输入下,程序也能稳定运行并尽可能保留有效信息。


















