








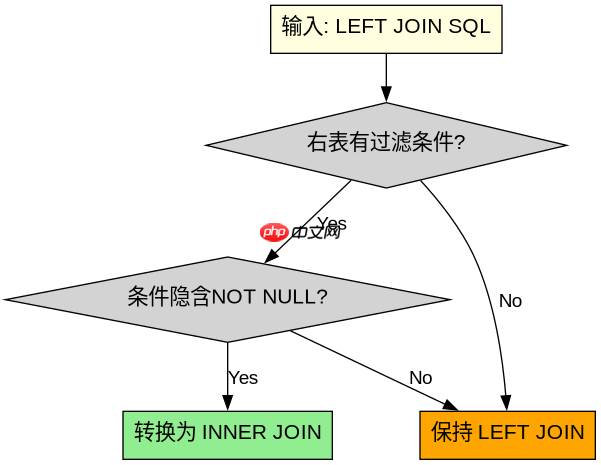
sql执行计划中将left join重写为inner join,是因为优化器通过统计信息或常量过滤条件确认左表(驱动表)在连接后不会产生null扩展行,即右表必然有匹配记录。此时left join与inner join的结果集完全一致,而inner join允许使用更高效的嵌套循环或散列连接算法,从而提升查询性能。

什么条件下LEFT JOIN会被重写为INNER JOIN
当WHERE子句中对右表的非空列施加了NOT NULL约束,或者右表的主键列出现在WHERE中时,优化器会判定右表不可能返回NULL值。这种逻辑推导消除了LEFT JOIN特有的“保留未匹配行”的需求,因此可以安全地转换为INNER JOIN。
SELECT * FROM t1 LEFT JOIN t2 ON t1.id = t2.id WHERE t2.status != 'deleted';
上述查询中,如果t2.status列定义为NOT NULL且业务逻辑保证不存在NULL值,那么任何t2.id为NULL的行都会被WHERE条件过滤掉。由于LEFT JOIN产生的NULL扩展行在后续过滤中被剔除,最终结果等同于INNER JOIN。
如何验证和优化这种重写行为
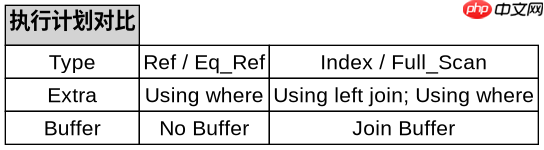
开发者可以通过EXPLAIN命令查看执行计划中的Type和Extra字段来确认是否发生了重写。如果看到Type为ref或eq_ref且没有Using join buffer等LEFT JOIN特有特征,通常意味着优化器已经将其视为内部连接处理。此外,确保统计信息最新是触发这种重写的先决条件。
EXPLAIN SELECT * FROM t1 LEFT JOIN t2 ON t1.id = t2.id WHERE t2.id IS NOT NULL;
在这个例子中,显式的IS NOT NULL条件直接告诉优化器右表必须有值。执行计划通常会显示优化器使用了更紧凑的连接顺序,甚至可能改变驱动表的选择,因为现在两个表都是强制匹配的。
基于t2.id IS NOT NULL条件的具体影响
当明确加入t2.id IS NOT NULL条件时,数据库引擎会彻底忽略左表可能存在的无匹配项。这意味着连接算法不再需要维护一个缓冲区来存储那些在右表中找不到对应记录的左表行。这种简化不仅减少了内存占用,还允许索引扫描更加激进,因为每一行都必须成功匹配才能进入结果集。


















