








在sql中处理group by将null划分为同一组的问题,核心在于理解标准行为并决定是否需要特殊处理。默认情况下,sql标准规定所有null值被视为相等,因此它们会被聚合到同一个分组中。如果业务逻辑要求将null值单独分组或排除,可以使用case表达式进行预处理,或者在查询后通过应用层逻辑过滤。
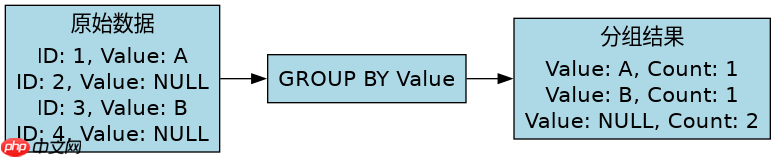
如何验证GROUP BY对NULL值的默认分组行为
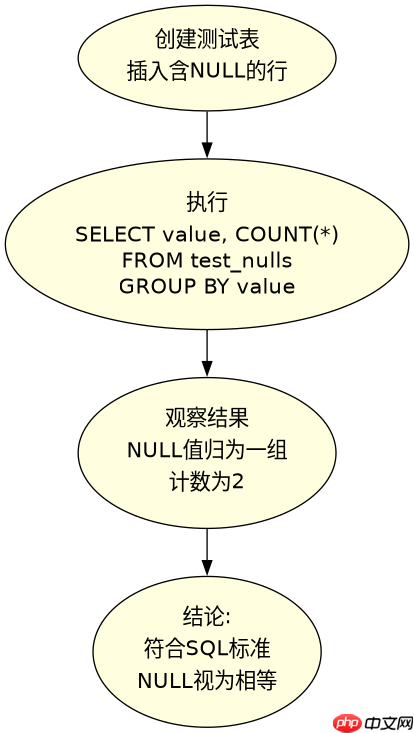
要验证这一行为,只需创建一个包含NULL值的测试表并执行简单的GROUP BY查询。结果会显示NULL值被归为一组,且COUNT(*)会统计这些行。这是符合SQL标准的预期行为,无需额外配置即可观察到。
CREATE TABLE test_nulls (id INT, value VARCHAR(10));
INSERT INTO test_nulls VALUES (1, 'A'), (2, NULL), (3, 'B'), (4, NULL);
SELECT value, COUNT(*) FROM test_nulls GROUP BY value;
预期输出:两行,一行value为'A'计数1,一行value为'B'计数1,另一行value为NULL计数2。这证实了NULL值被合并。
如何将NULL值从主分组中分离出来单独统计
若需将NULL值单独列示而非合并,可在GROUP BY子句中使用CASE表达式,将NULL映射为一个特定的标记值(如'__NULL__')。这样,原始NULL值和实际数据值会被分到不同的组,从而实现分离统计。这种方法兼容大多数SQL数据库。
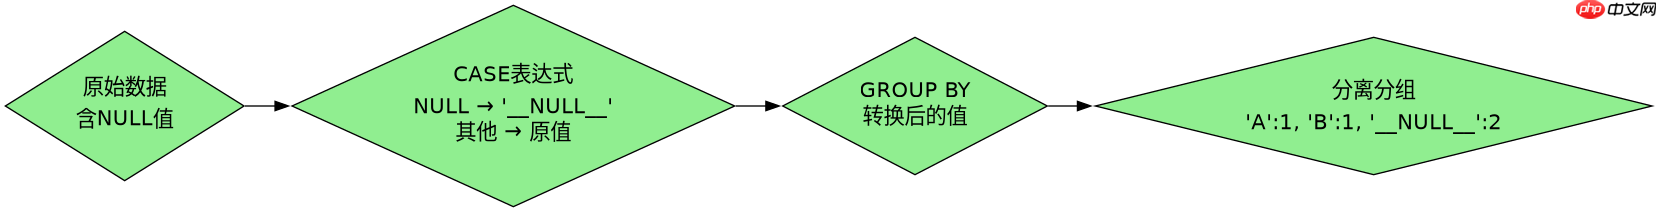
SELECT CASE WHEN value IS NULL THEN '__NULL__' ELSE value END AS grp_value, COUNT(*) FROM test_nulls GROUP BY CASE WHEN value IS NULL THEN '__NULL__' ELSE value END;
预期输出:三行,分别对应'A'、'B'和'__NULL__',其中'__NULL__'的计数为2。这实现了NULL值的独立分组。
基于输入条件判断是否应保留NULL分组
当程序需要根据特定条件决定是否保留NULL分组时,可以在WHERE子句中预先过滤NULL值,或在GROUP BY前使用COALESCE替换。例如,若业务规则要求忽略NULL记录,则添加WHERE value IS NOT NULL;若要求将NULL视为空字符串参与分组,则使用COALESCE(value, '')。具体选择取决于输入数据的语义和最终结果的期望。
















