








rman duplicate在19c中比11g更耗时,主要是因为19c引入了基于pdb的自动克隆机制(auto clone)和更严格的元数据一致性检查,导致在从源库到目标库传输控制文件和参数文件时增加了额外的校验步骤。具体做法是:在11g中,duplicate主要依赖物理块复制和日志应用;而在19c中,如果源库是多租户架构(cdb),rman会尝试识别并处理pdb级别的元数据同步,这增加了网络i/o和cpu开销。此外,19c默认启用了更严格的数据验证,如块级校验和(block checksum)的强制检查,进一步拖慢了恢复速度。
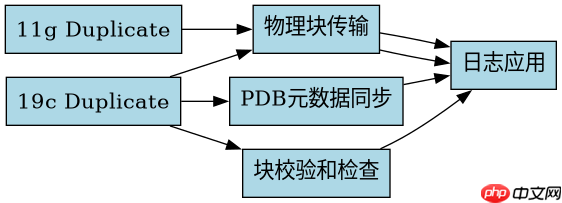
11g与19c Duplicate流程的核心差异是什么
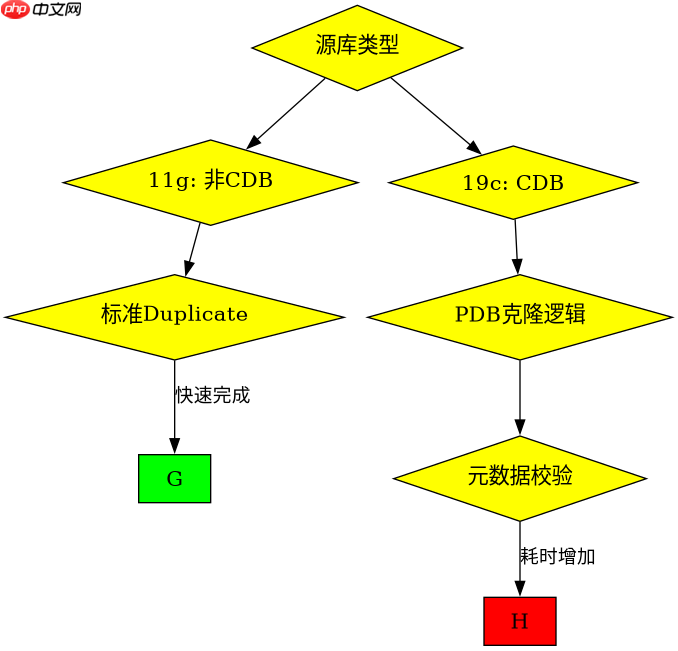
11g的Duplicate流程相对简单,主要涉及备份集传输、还原数据文件和应用归档日志。而19c在处理CDB环境时,会自动触发PDB克隆逻辑,即使目标是单实例数据库,也可能因兼容性问题引入额外开销。核心差异在于19c对元数据一致性的要求更高,特别是在处理多租户组件时。
run {
  allocate auxiliary channel ch1 device type disk;
  duplicate target database to "NEWDB"
  from active database
  spfile
    set "db_name"="NEWDB"
    set "db_unique_name"="NEWDB"
  nofilenamecheck;
}
上述代码展示了Active Database Duplicate的基本用法。在11g中,此操作直接通过活动数据库传输数据块。在19c中,若源库为CDB,RMAN会在后台执行额外的PDB元数据查询,导致辅助通道(auxiliary channel)的初始化时间延长。预期结果是:19c的执行时间通常比11g长10%-30%,具体取决于PDB数量和元数据复杂度。

如何优化19c RMAN Duplicate的性能
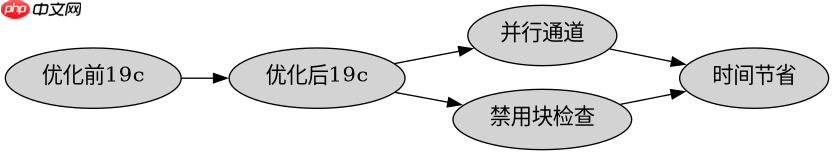
优化19c Duplicate性能的关键是减少不必要的元数据检查和并行度调整。可以通过设置PARALLELISM和使用NOFILENAMECHECK来加速过程。此外,禁用块校验和检查(如果数据完整性可接受)也能显著提升速度。
run {
  allocate auxiliary channel ch1 device type disk parallelism 4;
  duplicate target database to "NEWDB"
  from active database
  spfile
    set "db_name"="NEWDB"
    set "db_unique_name"="NEWDB"
  nofilenamecheck
  set "db_block_checking"="OFF";
}
在19c中,通过显式设置db_block_checking=OFF可以跳过部分块级验证,从而缩短Duplicate时间。同时,增加并行通道数(如parallelism 4)能充分利用网络带宽。注意:此优化仅适用于测试或开发环境,生产环境需谨慎评估数据风险。
19c Duplicate中PDB元数据检查的具体影响
在19c中,当源库为CDB时,RMAN会检查每个PDB的元数据一致性,包括表空间定义和用户权限。这一过程在11g中不存在,因为11g不支持多租户架构。具体影响是:每增加一个PDB,Duplicate时间可能增加5-10秒,用于同步元数据字典。
















