








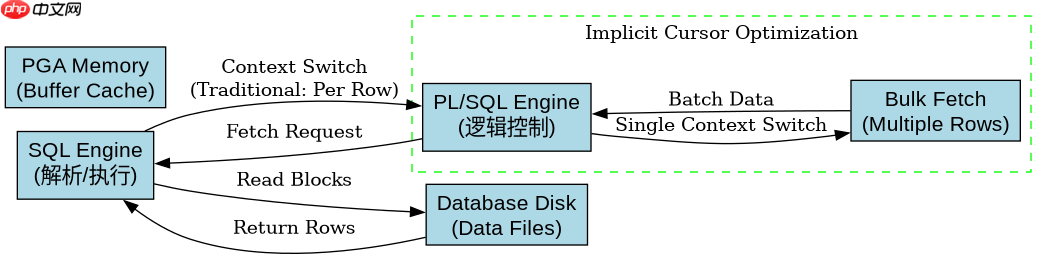
oracle游标for循环比传统的open fetch性能表现更好,核心原因在于它显著减少了客户端与数据库服务器之间的网络往返次数(context switches)。传统方式需要在pl/sql和sql引擎之间频繁切换以获取每一行数据,而for循环在内部实现了批量提取(bulk fetch),将多行数据一次性传输到pga内存中,从而大幅降低了上下文切换的开销。
传统OPEN FETCH循环的性能瓶颈在哪里
在传统模式下,每次执行FETCH语句都会触发一次从PL/SQL引擎到SQL引擎的上下文切换。如果处理大量数据,这种切换会成为主要的性能瓶颈。
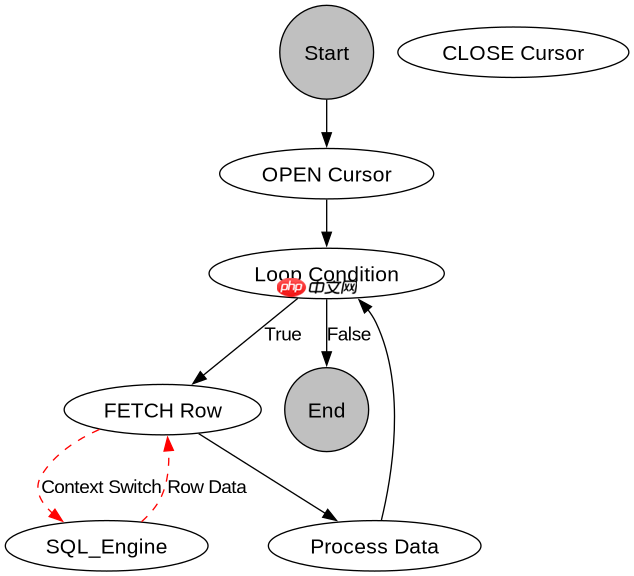

-- 传统 OPEN-FETCH 循环示例
DECLARE
  CURSOR c_emp IS SELECT empno, ename FROM emp;
  r_emp c_emp%ROWTYPE;
BEGIN
  OPEN c_emp;
  LOOP
    FETCH c_emp INTO r_emp;
    EXIT WHEN c_emp%NOTFOUND;
    -- 每FETCH一次,发生一次上下文切换
    DBMS_OUTPUT.PUT_LINE(r_emp.empno);
  END LOOP;
  CLOSE c_emp;
END;
FOR循环如何优化数据传输效率
FOR循环在底层自动执行了批量提取操作。它不像传统循环那样逐行获取,而是每次从数据库抓取一批数据(默认批次大小通常为100行或更多,取决于实现细节),将这些数据放入程序全局区(PGA)中。随后,PL/SQL代码直接在这些内存数据上迭代,无需再次访问SQL引擎,直到当前批次耗尽才发起下一次批量提取。
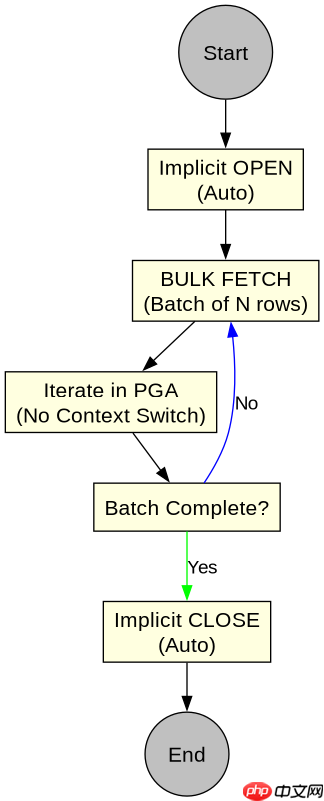
-- 隐式游标 FOR 循环示例
BEGIN
  -- 内部自动完成 OPEN, FETCH (批量), CLOSE
  FOR r_emp IN (SELECT empno, ename FROM emp) LOOP
    -- 仅在内存中迭代,无额外上下文切换
    DBMS_OUTPUT.PUT_LINE(r_emp.empno);
  END LOOP;
END;
基于程序中某个输入、条件或结果的具体问题
当查询返回的数据量极大时,传统OPEN FETCH可能会因为频繁的I/O和上下文切换导致执行时间呈线性增长甚至超时,而FOR循环由于批量提取机制,能保持相对稳定的吞吐量。此外,FOR循环还具备自动异常处理和资源清理的优势,若在执行过程中发生错误,它会像COMMIT一样自动关闭游标并释放资源,避免了传统模式下因忘记CLOSE导致的游标泄漏问题。





















