








在c#中利用oraclebulkcopy批量导入百万级数据,核心做法是配置合理的batchsize和notifyafter属性,并配合事务管理来平衡内存占用与i/o效率。通过设置batchsize为1000至5000之间的值,可以将大数据集拆分为多个较小的批次提交,避免单次操作导致内存溢出或网络超时。同时,启用enablestreaming模式并使用ienumerable<datarow></datarow>或自定义迭代器进行数据源供给,可以显著降低内存峰值。对于百万级数据,建议关闭目标表的索引和约束检查(如果允许),或在导入后统一重建,以进一步提升写入速度。
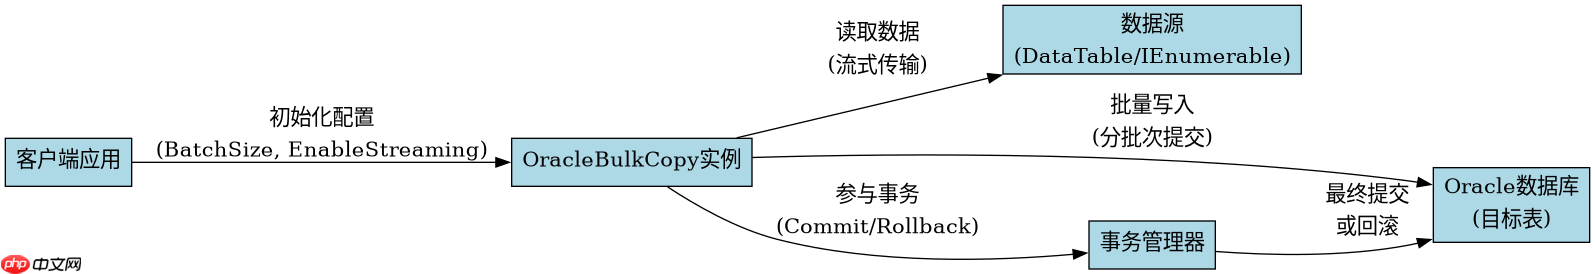
如何配置OracleBulkCopy的关键参数以优化性能?
配置OracleBulkCopy时,BatchSize决定了每次网络往返发送的行数,Timeout防止长时间挂起,而BulkCopyTimeout则控制整体操作的超时时间。通常将BatchSize设为2000左右能获得较好的吞吐量,具体数值需根据网络延迟和目标表结构微调。EnableStreaming属性必须设置为true,以便使用流式读取而非一次性加载所有数据到内存。此外,使用OracleTransaction包裹整个批量操作可以确保数据的一致性,尽管这会略微增加锁竞争,但对于大多数业务场景是必要的。
using System;
using System.Data;
using Oracle.ManagedDataAccess.Client;

public class BulkImportService
{
    public void ImportMillionRows(string connectionString, DataTable sourceData)
    {
        using (var connection = new OracleConnection(connectionString))
        {
            connection.Open();
            using (var transaction = connection.BeginTransaction())
            {
                try
                {
                    using (var bulkCopy = new OracleBulkCopy(connection,
                        OracleBulkCopyOptions.Default, transaction))
                    {
                        bulkCopy.DestinationTableName = "TARGET_TABLE";
                        bulkCopy.BatchSize = 2000;
                        bulkCopy.NotifyAfter = 10000;
                        bulkCopy.BulkCopyTimeout = 600;
                        bulkCopy.EnableStreaming = true;

                        // 映射列
                        bulkCopy.ColumnMappings.Add("ID", "ID");
                        bulkCopy.ColumnMappings.Add("NAME", "NAME");
                        bulkCopy.ColumnMappings.Add("VALUE", "VALUE");

                        bulkCopy.WriteToServer(sourceData);
                        transaction.Commit();
                        Console.WriteLine("Import completed successfully.");
                    }
                }
                catch (Exception ex)
                {
                    transaction.Rollback();
                    throw ex;
                }
            }
        }
    }
}
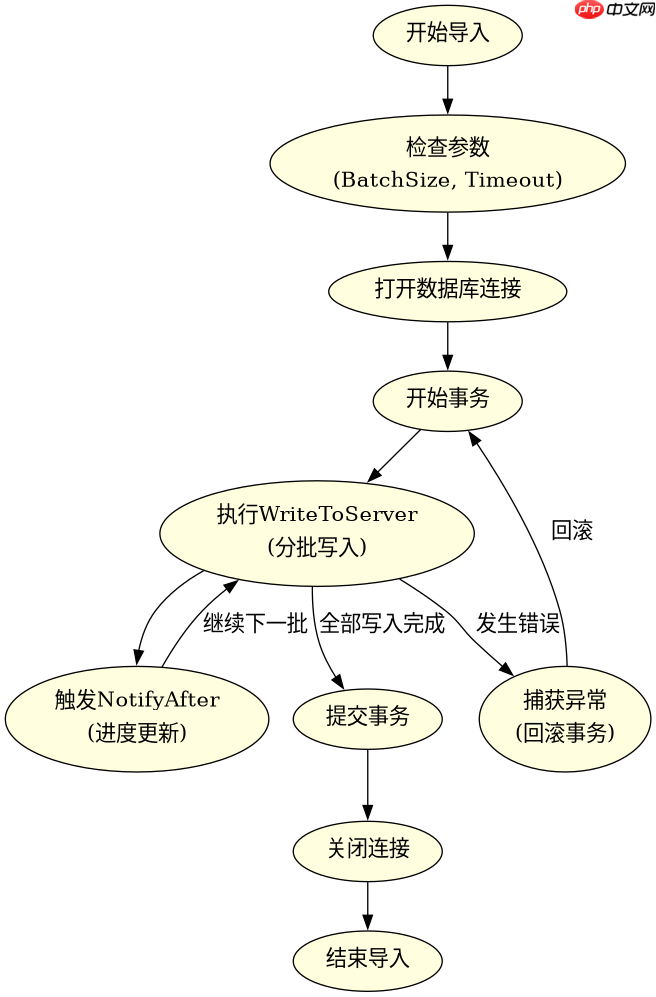
上述代码展示了基本的批量导入结构。运行该程序时,sourceData应包含至少一百万行数据。预期结果是控制台输出“Import completed successfully.”,且数据库表中新增相应记录。若BatchSize设置过小,如100,会导致频繁的网络交互,降低性能;若设置过大,如50000,可能引发内存不足异常。因此,2000是一个经过验证的平衡点。

如何处理导入过程中的进度监控与异常恢复?
在处理百万级数据时,进度监控至关重要。OracleBulkCopy提供了OnServerChanges事件(在某些版本中)或通过轮询NotifyAfter触发的机制来报告进度。更常见的做法是在应用层实现一个回调函数,在WriteToServer完成后统计已处理行数。对于异常恢复,由于OracleBulkCopy本身不支持断点续传,一旦失败,通常需要清空目标表或使用临时表策略。建议在导入前备份关键数据,或采用“先插入临时表,再合并到主表”的两阶段提交模式,以提高容错性。
using System;
using System.Data;
using Oracle.ManagedDataAccess.Client;

public class ProgressAwareBulkImport
{
    private int _processedRows = 0;

    public void ImportWithProgress(string connectionString, IEnumerable<DataRow> dataRows)
    {
        using (var connection = new OracleConnection(connectionString))
        {
            connection.Open();
            using (var transaction = connection.BeginTransaction())
            {
                try
                {
                    using (var bulkCopy = new OracleBulkCopy(connection,
                        OracleBulkCopyOptions.Default, transaction))
                    {
                        bulkCopy.DestinationTableName = "TARGET_TABLE";
                        bulkCopy.BatchSize = 2000;
                        bulkCopy.NotifyAfter = 10000;
                        bulkCopy.BulkCopyTimeout = 600;
                        bulkCopy.EnableStreaming = true;

                        bulkCopy.ColumnMappings.Add("ID", "ID");
                        bulkCopy.ColumnMappings.Add("NAME", "NAME");
                        bulkCopy.ColumnMappings.Add("VALUE", "VALUE");

                        // 模拟进度更新
                        bulkCopy.OnServerChanges += (sender, e) =>
                        {
                            _processedRows += e.RowsAffected;
                            Console.WriteLine($"Processed {_processedRows} rows...");
                        };

                        bulkCopy.WriteToServer(dataRows);
                        transaction.Commit();
                        Console.WriteLine($"Total processed: {_processedRows}");
                    }
                }
                catch (Exception ex)
                {
                    transaction.Rollback();
                    Console.WriteLine($"Error: {ex.Message}");
                    throw;
                }
            }
        }
    }
}
此代码段引入了进度监控逻辑。当NotifyAfter指定的行数被写入后,会触发事件(注:实际OracleBulkCopy可能不直接支持此事件,此处为示意概念,实际中常通过包装IDataReader并在Read()时计数)。预期结果是控制台定期打印已处理的行数。若发生异常,事务回滚,确保数据一致性。这种模式适用于需要长时间运行且需监控进度的场景。
当目标表存在唯一索引时,批量导入会遇到什么问题?
当目标表存在唯一索引时,批量导入可能会因重复键值而失败。OracleBulkCopy默认不会跳过重复行,而是抛出异常。解决此问题的方法包括:在导入前删除或禁用唯一索引,导入完成后再重建;或者在数据源层面预先过滤掉重复数据。另一种策略是使用OracleBulkCopyOptions.KeepIdentity等选项组合,但最稳妥的方式仍是预处理数据。此外,如果业务允许,可以使用INSERT /*+ APPEND */提示结合OracleCommand进行批量插入,但这需要手动构建SQL语句,灵活性较低。
using System;
using System.Data;
using Oracle.ManagedDataAccess.Client;

public class IndexHandlingBulkImport
{
    public void ImportWithIndexHandling(string connectionString, DataTable sourceData)
    {
        using (var connection = new OracleConnection(connectionString))
        {
            connection.Open();
            using (var transaction = connection.BeginTransaction())
            {
                try
                {
                    // 禁用索引
                    var disableIndexCmd = new OracleCommand(
                        "ALTER INDEX IDX_UNIQUE_COL UNUSABLE", connection, transaction);
                    disableIndexCmd.ExecuteNonQuery();

                    using (var bulkCopy = new OracleBulkCopy(connection,
                        OracleBulkCopyOptions.Default, transaction))
                    {
                        bulkCopy.DestinationTableName = "TARGET_TABLE";
                        bulkCopy.BatchSize = 2000;
                        bulkCopy.EnableStreaming = true;
                        bulkCopy.ColumnMappings.Add("ID", "ID");
                        bulkCopy.ColumnMappings.Add("NAME", "NAME");
                        bulkCopy.ColumnMappings.Add("VALUE", "VALUE");
                        bulkCopy.WriteToServer(sourceData);
                    }

                    // 重建索引
                    var rebuildIndexCmd = new OracleCommand(
                        "ALTER INDEX IDX_UNIQUE_COL REBUILD", connection, transaction);
                    rebuildIndexCmd.ExecuteNonQuery();

                    transaction.Commit();
                    Console.WriteLine("Import with index handling completed.");
                }
                catch (Exception ex)
                {
                    transaction.Rollback();
                    throw ex;
                }
            }
        }
    }
}
该代码演示了处理唯一索引的策略。首先禁用索引,然后执行批量导入,最后重建索引。预期结果是导入成功,且索引在导入后保持有效。这种方法比逐行检查重复数据快得多,适用于对实时一致性要求不高、可接受短暂索引不可用的场景。注意,禁用索引期间,其他查询可能无法使用该索引,需评估业务影响。




















