








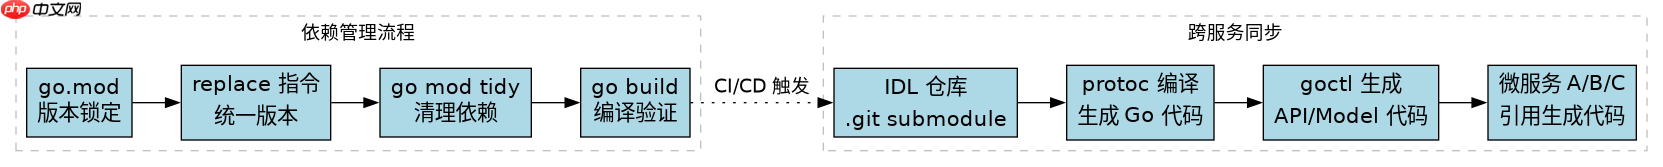
go-zero 框架通过 goctl 工具链和 protoc-gen-go-zero 插件实现 protobuf 版本管理,核心做法是在 go.mod 中锁定 google.golang.org/protobuf 与 github.com/gogo/protobuf(若兼容旧版)的具体版本,并在 makefile 或 ci 脚本中统一执行 goctl model mysql ddl -c 及 goctl api go 生成代码。跨服务协议同步的关键在于维护一个共享的 .proto 文件仓库,确保所有微服务引用同一版本的 idl 定义,并通过 protoc 编译时指定相同的输出路径和插件参数,从而避免因协议版本不一致导致的字段丢失或类型冲突。
如何锁定 Protobuf 依赖版本以避免编译冲突?
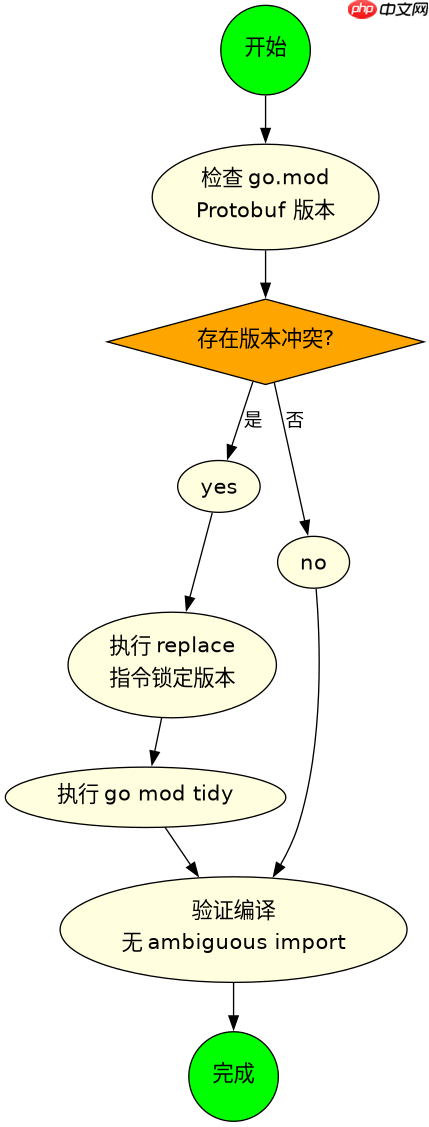
在 Go-Zero 项目中,Protobuf 的版本管理主要依赖于 go.mod 中的依赖声明。由于 Go-Zero 早期版本可能依赖 gogo/protobuf,而新版转向标准 google.golang.org/protobuf,因此必须显式指定版本以消除歧义。通常的做法是引入 github.com/gogo/protobuf 作为兼容层,或者完全迁移到标准库。关键在于使用 replace 指令或直接锁定版本号,确保所有子模块使用相同的底层实现。
module github.com/example/my-service

go 1.21

require (
	github.com/zeromicro/go-zero v1.5.7
	google.golang.org/protobuf v1.31.0
	github.com/gogo/protobuf v1.3.2
)

// 若需强制使用特定版本解决冲突
replace google.golang.org/protobuf => google.golang.org/protobuf v1.28.1
上述 go.mod 配置展示了如何同时保留两个 Protobuf 实现的支持。当项目升级时,只需修改版本号并运行 go mod tidy。若出现 ambiguous import 错误,通常是因为不同模块引入了不同版本的 Protobuf 库,此时通过 replace 指令统一版本是有效的解决方案。此外,goctl 生成的代码中会包含对特定 Protobuf 版本的导入语句,确保这些语句与 go.mod 中的依赖一致至关重要。
跨服务协议同步的最佳实践是什么?
跨服务协议同步的核心策略是将 .proto 文件集中管理在一个独立的 Git 仓库中,称为 api-definitions 或 idl-repo。各微服务通过 git submodule 或 go get 引用该仓库的特定标签或提交哈希。这样做的目的是确保所有服务在编译时使用的是同一份接口定义,避免因某个服务更新协议后未通知其他服务而导致的运行时错误。

# Makefile 示例:统一生成代码
.PHONY: generate

generate:
	cd proto && \
	protoc --go_out=paths=source_relative:. --go-grpc_out=paths=source_relative:. *.proto && \
	goctl api go -api user.api -dir ../user-api && \
	goctl model mysql ddl -sql file.sql -c
在 Makefile 中,我们定义了统一的生成命令。首先,protoc 负责将 .proto 文件编译为 Go 代码,这里使用了 paths=source_relative 选项以保持导入路径的一致性。接着,goctl api go 根据 .api 文件生成 API 处理逻辑,而 goctl model 则生成数据库模型。这种自动化流程确保了每次代码生成都基于最新的协议定义,减少了人工同步的成本。开发者只需在 idl-repo 中更新协议,然后触发各服务的 CI/CD 流水线即可。
当 .proto 文件中新增可选字段时,现有服务会受到什么影响?
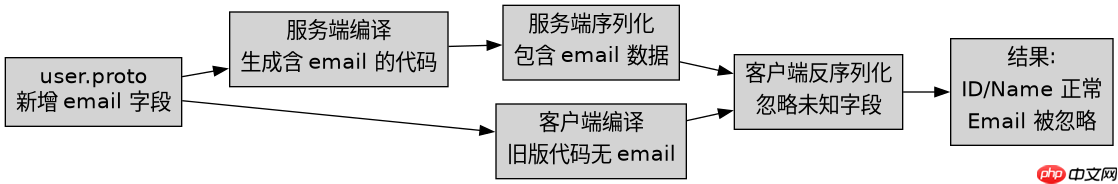
在 Protobuf 3 中,新增字段默认是可选的(optional),且不会破坏向后兼容性。如果服务端新增了字段 extra_info,而客户端仍使用旧版代码,客户端在解析响应时会忽略该字段,不会报错。反之,如果客户端发送了包含新字段的请求,服务端若未识别该字段,也会将其丢弃。这种行为保证了服务在独立升级时的稳定性。
为了验证这一点,我们可以创建一个简单的测试程序。假设有一个 User 消息类型,初始版本只包含 id 和 name。我们在服务端新增了 email 字段,但客户端未更新。当服务端返回包含 email 的数据时,客户端反序列化后的 User 对象中 Email 字段为空,但 ID 和 Name 依然正确。这证明了 Protobuf 的二进制格式设计允许字段的新增和删除而不影响基本通信。
package main

import (
	"fmt"
	pb "github.com/example/proto/user"
)

func main() {
	// 模拟服务端数据,包含新字段
	serverData := &pb.User{
		Id:    1,
		Name:  "Alice",
		Email: "alice@example.com", // 新字段
	}

	// 模拟客户端反序列化(假设客户端代码未更新,无 Email 字段)
	// 在实际场景中,这由 protoc 生成的代码自动处理
	fmt.Printf("Client received ID: %d, Name: %s\n", serverData.Id, serverData.Name)
	// 注意:如果客户端结构体没有 Email 字段,它无法访问该值,但不会崩溃
}
上述代码展示了即使服务端数据结构扩展,客户端仍能安全地获取已知字段。然而,如果服务端删除了旧字段,而客户端仍尝试读取,可能会导致默认值(如空字符串或 0)被返回,这可能引发业务逻辑错误。因此,最佳实践是避免删除已发布的字段,而是标记为废弃(deprecated),并逐步迁移客户端。


















