








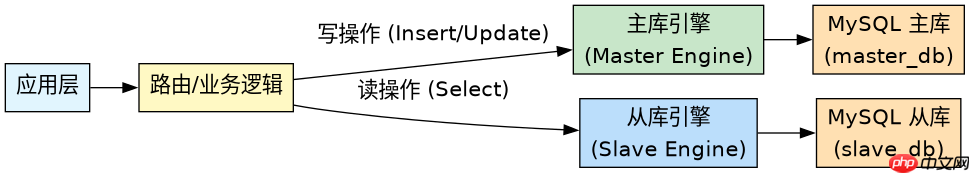
在xorm框架中实现多数据源切换,核心做法是实例化多个独立的engine对象并分别配置不同的数据库连接字符串,随后通过显式调用对应引擎的方法来执行sql或orm操作。开发者需要在初始化阶段创建好所有需要的数据源引擎,并在业务逻辑中根据具体需求(如读写分离、分库路由)选择正确的引擎实例进行查询或写入,从而避免单点故障并支持复杂的数据分布场景。
如何初始化并管理多个XORM引擎实例
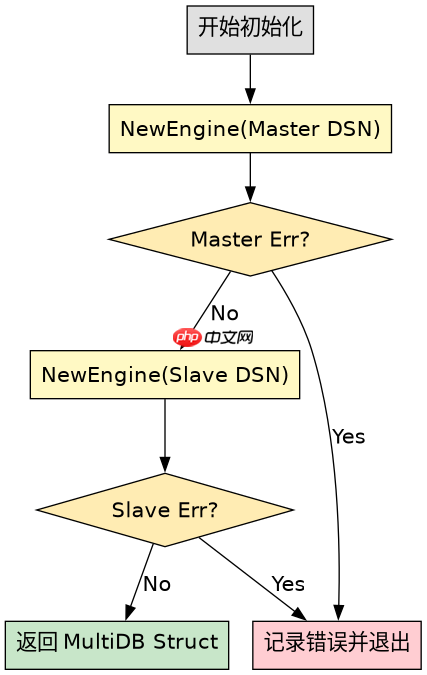
初始化多数据源的第一步是分别为每个数据库配置创建一个独立的xorm.Engine。这通常通过调用xorm.NewEngine()方法完成,传入对应的驱动名称和连接DSN(Data Source Name)。每个引擎都拥有独立的连接池和元数据缓存,彼此之间互不干扰。开发者应将这些引擎存储在结构体或全局变量中,以便在后续的业务逻辑中进行分发调用。
package main

import (
	"fmt"
	"github.com/xormplus/xorm"
	_ "github.com/go-sql-driver/mysql"
)

type MultiDB struct {
	Master *xorm.Engine
	Slave  *xorm.Engine
}

func NewMultiDB() (*MultiDB, error) {
	// 初始化主库
	masterEngine, err := xorm.NewEngine("mysql", "user:password@tcp(127.0.0.1:3306)/master_db?charset=utf8mb4")
	if err != nil {
		return nil, err
	}

	// 初始化从库
	slaveEngine, err := xorm.NewEngine("mysql", "user:password@tcp(127.0.0.1:3307)/slave_db?charset=utf8mb4")
	if err != nil {
		return nil, err
	}

	return &MultiDB{
		Master: masterEngine,
		Slave:  slaveEngine,
	}, nil
}

func main() {
	db, err := NewMultiDB()
	if err != nil {
		fmt.Println("Init failed:", err)
		return
	}
	defer db.Master.Close()
	defer db.Slave.Close()

	// 验证连接
	if err := db.Master.Ping(); err != nil {
		fmt.Println("Master ping failed:", err)
	}
	if err := db.Slave.Ping(); err != nil {
		fmt.Println("Slave ping failed:", err)
	}
	fmt.Println("Multi-DB initialized successfully.")
}
如何在业务代码中根据条件切换数据源
在业务逻辑中切换数据源的关键在于明确区分读操作和写操作,或者根据特定的业务规则(如租户ID)路由到不同的引擎。由于XORM的每个Engine都是独立的,切换数据源本质上就是切换所调用的引擎实例。例如,在读写分离场景下,所有的INSERT、UPDATE、DELETE操作必须指向主库引擎,而SELECT操作可以指向从库引擎。这种切换不需要动态改变全局状态,而是通过函数参数或上下文传递来决定使用哪个引擎。
// 假设 User 模型已定义
// type User struct { Id int64 Name string }

func (m *MultiDB) CreateUser(user *User) error {
	// 强制写入主库
	_, err := m.Master.Insert(user)
	return err
}

func (m *MultiDB) GetUserById(id int64) (*User, error) {
	user := new(User)
	has, err := m.Slave.Get(user)
	if err != nil {
		return nil, err
	}
	if !has {
		return nil, fmt.Errorf("user not found")
	}
	return user, nil
}

func main() {
	db, _ := NewMultiDB()

	// 写入操作
	newUser := &User{Name: "test_user"}
	db.CreateUser(newUser)

	// 读取操作
	u, _ := db.GetUserById(1)
	fmt.Printf("Got user: %v\n", u.Name)
}
当主库写入成功后从库尚未同步时查询会返回什么
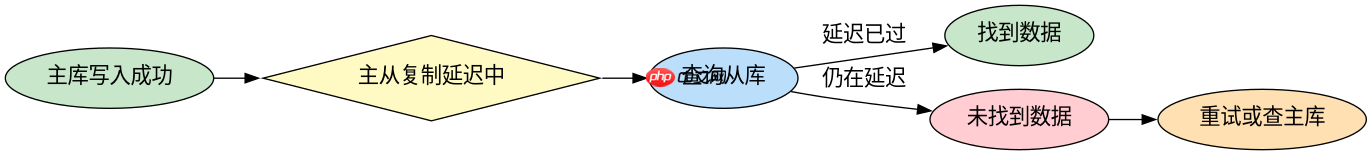
在主库写入成功但主从复制存在延迟的情况下,如果立即查询从库,通常会查不到刚刚插入的数据,或者返回旧数据。这是因为从库需要通过Binlog异步复制主库的操作,这个过程需要时间。因此,在这种特定条件下,查询结果取决于复制延迟的大小以及业务对数据一致性的要求。若业务强依赖刚写入的数据,应直接查询主库而非从库,否则需处理“暂时不存在”的逻辑分支。
,














